

Python正则表达式re模块六大核心函数详解
本文详细解析Python中re模块的六种核心字符串匹配方法。涵盖re.match从头匹配、re.search全局搜索、re.sub替换、compile预编译优化、findall返回列表及finditer返回迭代器的具体用法与区别,结合代码示例说明正则表达式在URL解析等场景中的应用。
2026-10-13
7

本文详细解析Python中re模块的六种核心字符串匹配方法。涵盖re.match从头匹配、re.search全局搜索、re.sub替换、compile预编译优化、findall返回列表及finditer返回迭代器的具体用法与区别,结合代码示例说明正则表达式在URL解析等场景中的应用。
本文介绍在 C# 开发中,利用 System.Text.RegularExpressions 命名空间下的 Regex.Replace 方法,通过定义脚本、样式和 HTML 标签的正则模式,结合空白字符清理与 HTML 实体替换,实现将 HTML 字符串转换为纯净文本的高效处理方式。
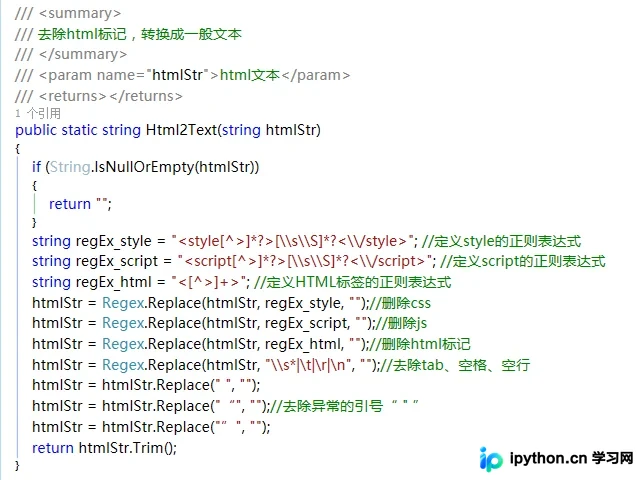
本文介绍C#中移除HTML标记的三种实现方式:普通正则表达式、预编译正则表达式及使用For循环的字符数组法。通过对比测试结果,字符数组法在处理大量文本时效率最高,适合高性能场景;预编译正则式次之;普通正则式最慢且无法处理所有非法HTML结构。
本文介绍如何利用JavaScript的正则表达式对15位和18位身份证号码进行格式校验。通过定义匹配规则,检查输入是否仅由数字组成(15位)或以X结尾(18位),从而实现快速的前端数据验证,避免无效提交。
本文介绍如何在Python3中利用正则表达式从混合字符串中精准提取中文字符。通过定义包含Unicode范围的匹配模式,并结合re模块的findall方法,实现过滤非中文内容并返回结果数组的功能。
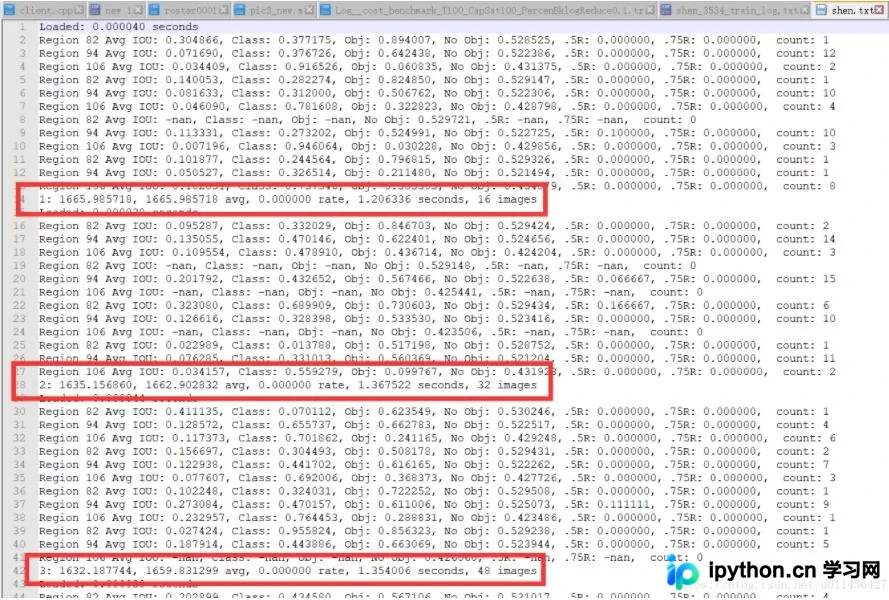
本文介绍利用Python读取TXT文件中特定格式行的方法。通过正则表达式匹配以数字加冒号开头的行,提取目标数据,并使用replace函数去除逗号与冒号,实现数据格式的规范化处理。
介绍如何构建安全的Web表单。前端利用JavaScript正则表达式(RegExp)进行实时格式校验(如账号、密码、邮箱、手机号),提升用户体验;后端使用PHP的preg_match函数进行二次安全过滤。同时提供基于Session或数据库的安全验证码机制,防止恶意注册。
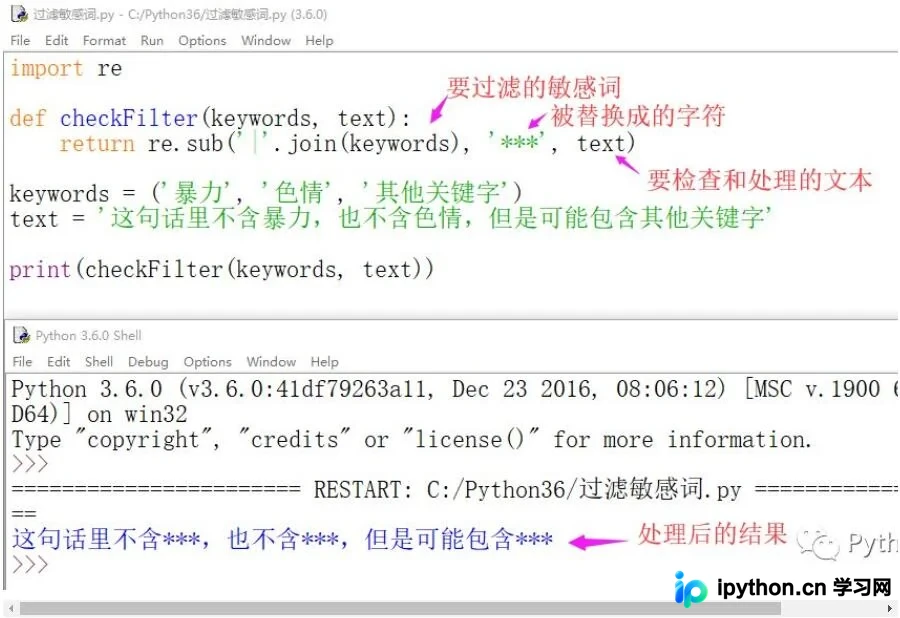
本文介绍如何利用Python的re模块sub()函数结合正则表达式中的竖线“|”语法,实现对用户发帖内容中敏感词的自动检测与字符替换。通过具体代码示例,展示如何高效构建过滤规则,适用于网站内容安全审核场景。
本文介绍Python中过滤字母、数字及特殊符号的多种实现方式,涵盖filter内置方法、正则表达式re模块及isnumeric等字符串处理技巧,适用于中文分词前的数据清洗场景。
本文介绍如何使用Python打开文件并利用正则表达式对内容进行匹配处理。通过定义特定的正则模式,程序可以逐行读取文件,提取符合格式要求的数据字段(如16位数字和3位数值),并对提取结果进行进一步的字符串格式化处理,适用于需要批量处理结构化文本数据的场景。
本文介绍利用Python的pymysql库将TXT文档中的每行内容循环插入MySQL数据库的方法。通过正则表达式提取关键字段,结合游标执行SQL插入语句,实现数据自动化入库。
本文介绍如何使用Python的re模块匹配两个指定短语之间的字符。通过open读取文件,利用re.findall配合非贪婪模式.*?提取目标内容,并遍历打印结果。