C#中正则表达式的3种常用匹配模式详解
在C#开发中使用Regex类处理文本时,理解单行(Singleline)、多行(Multiline)和忽略大小写(IgnoreCase)三种核心模式至关重要。本文详细解析这三种模式的定义与行为差异,通过提取HTML标签、查找特定用户名等真实代码示例,展示如何正确配置RegexOptions枚举及嵌入修饰符,解决常见的匹配失败问题并提供最佳实践建议。
2026-10-13
6

在C#开发中使用Regex类处理文本时,理解单行(Singleline)、多行(Multiline)和忽略大小写(IgnoreCase)三种核心模式至关重要。本文详细解析这三种模式的定义与行为差异,通过提取HTML标签、查找特定用户名等真实代码示例,展示如何正确配置RegexOptions枚举及嵌入修饰符,解决常见的匹配失败问题并提供最佳实践建议。
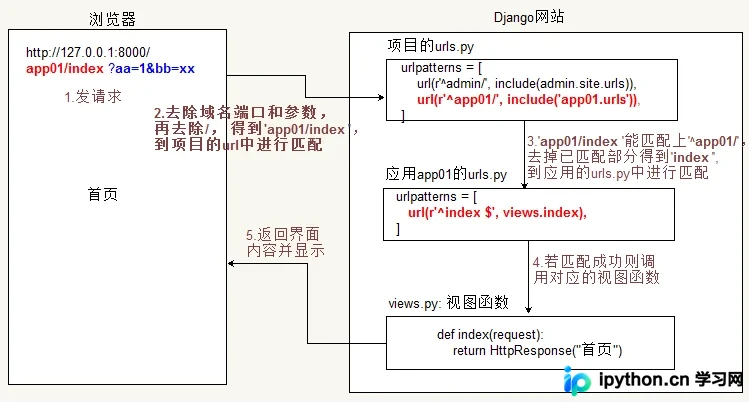
本文详解Django框架中的视图函数与URL配置机制。涵盖视图定义、URL路由匹配流程、位置与关键字参数捕获,以及404、500等内置错误视图的自定义与调试方法,帮助开发者掌握Django请求处理核心逻辑。
本文对比Python中str.split与re.split两种字符串分割方法。str.split仅支持简单字符分割,无法处理连续空格或正则表达式;而re.split支持正则匹配、多字符分割及空白字符处理,功能更强大。通过代码示例解析两者差异,帮助开发者根据场景选择合适方案。
本文介绍如何在Python中使用正则表达式过滤HTML标签并提取纯文本。通过定义多个正则规则,依次移除CDATA、Script、Style标签及HTML注释,并将换行符转换为标准格式,最后替换字符实体。该方法能有效清理HTML字符串,适用于网页内容抓取与数据处理场景。
本文介绍在Python中如何使用正则表达式一次性提取被任意标点符号隔开的短句。通过定义包含中英文标点的匹配模式,利用re.split函数实现高效分割,并展示完整代码示例与结果验证。
本文介绍在 Python 中利用正则表达式判断字符串是否包含简体中文或非简体中文的方法。通过定义匹配 Unicode 汉字范围的编译对象,结合 search 方法实现检测,并提供了完整的代码示例供参考。
本文介绍Python中使用正则表达式匹配日期与时间的方法,涵盖日期格式如2016-12-12及带时间的2016-12-12 14:34的匹配模式。同时解析原生字符串r的作用,说明其如何简化反斜杠转义处理,避免多重转义带来的困扰,提升代码可读性与准确性。
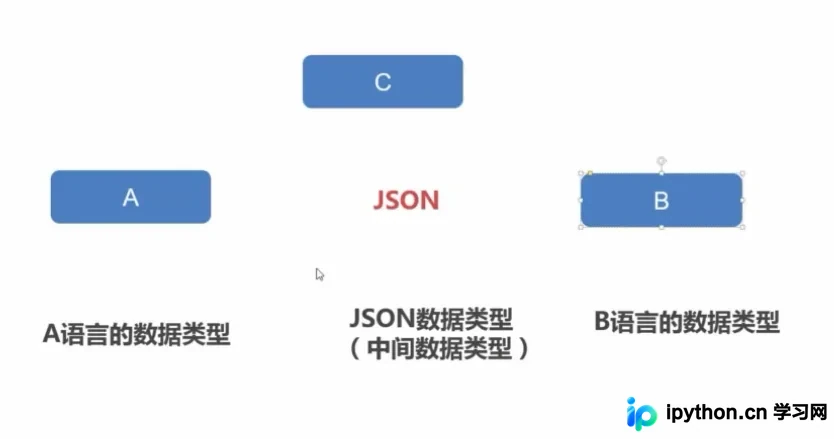
本文详细介绍Python中正则表达式的基本用法,涵盖元字符、字符集、数量词、贪婪模式及分组匹配等核心概念,并结合re模块函数进行实战演示。同时深入解析JSON数据交换格式,对比XML优势,讲解JSON字符串与对象的区别,以及Python中json模块的序列化与反序列化操作,帮助开发者掌握文本处理与数据交互的关键技术。
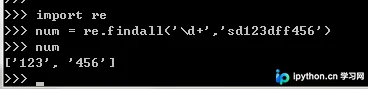
本文介绍如何使用Python正则表达式匹配整数和小数。通过\d+匹配一次或多次数字,可获取整数列表;针对小数匹配,结果返回字符串类型。文章包含具体代码示例与结果分析,帮助开发者快速掌握相关技巧。
本文介绍Python中对字符串列表进行排序的两种常见场景:按字符串长度排序和按字符串内嵌数字大小排序。通过内置sorted()和list.sort()方法,结合lambda表达式与key参数,可灵活实现自定义排序逻辑。示例展示了如何提取文件名中的数字并按数值大小排列,适用于数据清洗与文件管理场景。
本文介绍在C#开发中如何利用正则表达式快速去除字符串中的HTML标签。通过定义匹配尖括号内容的Regex模式,将标记替换为空字符串,从而提取纯文本内容,适用于数据清洗等场景。
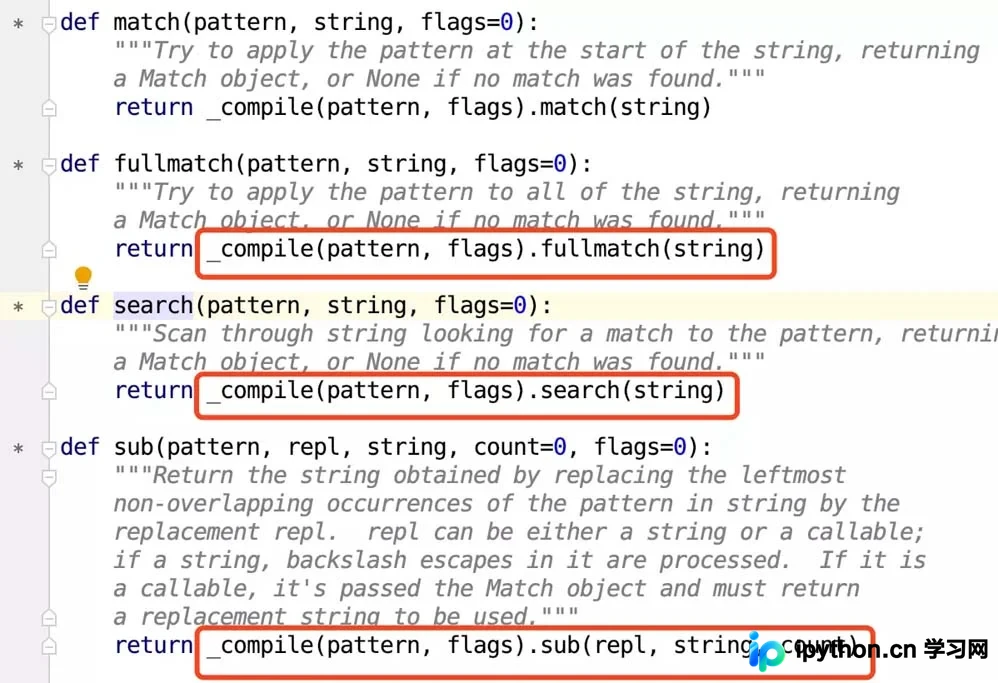
本文通过Python源码深入解析,指出re模块中的search、findall等方法内部已自动调用_compile并具备缓存机制。手动调用re.compile不仅多余,且源自其他语言的不良习惯。文章澄清了关于百万级数据匹配的性能误区,建议开发者直接使用内置方法以获得更简洁高效的代码。