

Python正则表达式无需手动re.compile:源码解析与性能真相

本文通过Python源码深入解析,指出re模块中的search、findall等方法内部已自动调用_compile并具备缓存机制。手动调用re.compile不仅多余,且源自其他语言的不良习惯。文章澄清了关于百万级数据匹配的性能误区,建议开发者直接使用内置方法以获得更简洁高效的代码。
Python正则表达式无需手动re.compile:源码解析与性能真相
前言
如果在网络上搜索Python正则表达式的使用教程,你会发现大量文章推荐以下写法:
import re

pattern = re.compile('正则表达式')
text = '一段字符串'
result = pattern.findall(text)
这些文章的作者或许受到其他编程语言习惯的影响,或是被误导性的内容所欺骗,从而不加甄别地直接套用。
但在Python中,实际上根本不需要使用re.compile。
为了证实这一观点,我们直接查阅Python的源代码。
在PyCharm编辑器中输入:
import re

re.search
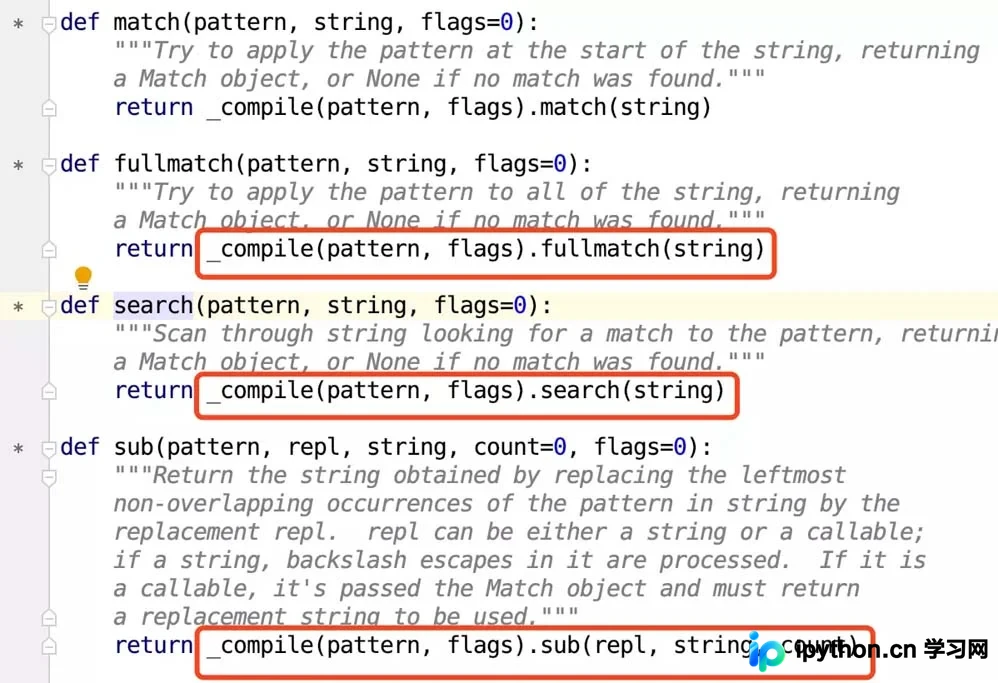
随后,Windows用户按住Ctrl键并左键点击search,Mac用户按住Command键并左键点击search,PyCharm会自动跳转至Python的re模块源码。在这里你可以看到,无论是常用的findall、search、sub还是match方法,其实现方式均如下所示:
_compile(pattern, flag).对应的方法(string)例如:
def findall(pattern, string, flags=0):
 """Return a list of all non-overlapping matches in the string.

 If one or more capturing groups are present in the pattern, return
 a list of groups; this will be a list of tuples if the pattern
 has more than one group.

 Empty matches are included in the result."""
 return _compile(pattern, flags).findall(string)
具体实现如下图所示:
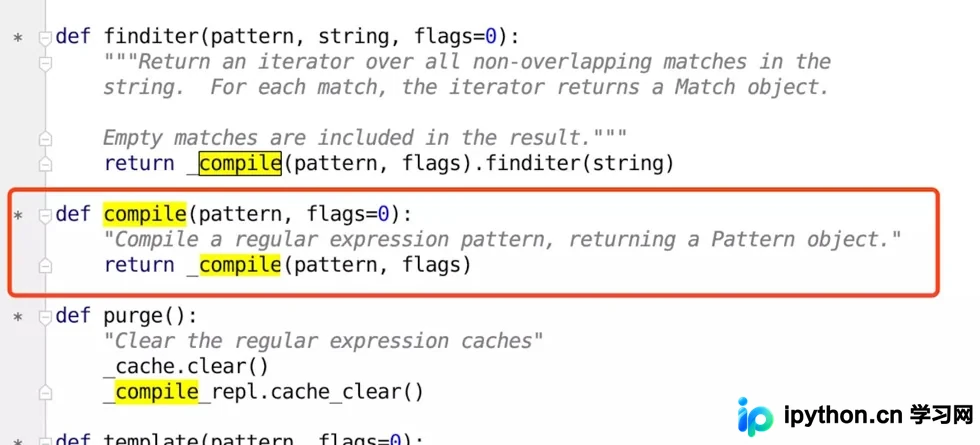
接着我们查看compile函数的实现:
def compile(pattern, flags=0):
 "Compile a regular expression pattern, returning a Pattern object."
 return _compile(pattern, flags)
具体实现如下图所示:
问题是否已经显而易见?
我们日常使用的正则表达式方法内部已经封装了compile逻辑!
因此,先调用re.compile再生成正则对象再调用匹配方法的做法完全是多此一举。
此时,可能会有人提出反驳:
假设我需要处理一百万条字符串,并使用同一个正则表达式进行匹配,代码可以这样编写:
texts = [包含一百万个字符串的列表]
pattern = re.compile('正则表达式')
for text in texts:
 pattern.search(text)
在这种场景下,re.compile仅执行了一次;而如果你采用如下写法:
texts = [包含一百万个字符串的列表]
for text in texts:
 re.search('正则表达式', text)
这相当于在底层对同一正则表达式重复执行了100万次re.compile操作。
空谈无益,让我们看代码实现。
查看源代码可知,正则表达式re.compile最终调用的是_compile函数,我们进一步查看_compile的源码,如下图所示:
红框标注的代码表明,_compile内部自带缓存机制。它会自动存储最多512条由type(pattern)、pattern和flags组成的Key。只要正则表达式、标志位完全一致,第二次调用_compile时,系统会直接读取缓存,无需重新编译。
综上所述,请停止手动调用re.compile,这是从其他语言(确切地说是Java)移植过来的不良编程习惯。
总结
以上就是本文的全部内容,希望这些内容对你的学习或工作有所启发。感谢大家对本站的支持。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









