

Python正则表达式实战:爬取京东商品数据详解
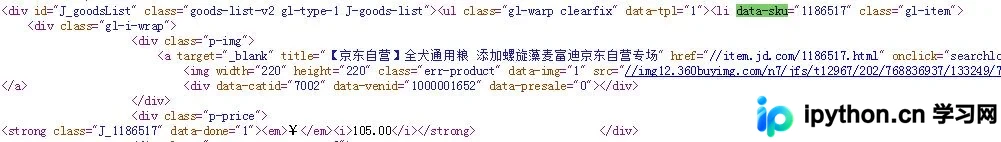
本文详细介绍如何使用Python正则表达式从京东网站抓取商品信息。通过构造包含关键词的URL,利用urllib库获取网页源码,并运用[\s\S]等正则模式精准提取商品数据。文章涵盖URL编码原理、正则匹配技巧及代码实现,帮助开发者掌握基础爬虫技能。
2026-10-13
6

本文详细介绍如何使用Python正则表达式从京东网站抓取商品信息。通过构造包含关键词的URL,利用urllib库获取网页源码,并运用[\s\S]等正则模式精准提取商品数据。文章涵盖URL编码原理、正则匹配技巧及代码实现,帮助开发者掌握基础爬虫技能。
本文详解使用Python实现密码验证程序的完整思路。程序需处理多行输入,对每行密码进行三项核心校验:长度必须超过8位;需包含大小写字母、数字及特殊符号中的至少三种;严禁存在长度超过2的重复子串。通过结合循环遍历与正则表达式,可有效判断密码是否符合规范并输出OK或NG结果。
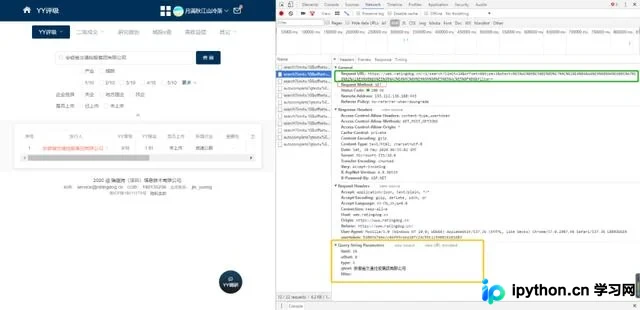
本文介绍使用Python编写爬虫批量获取YY评级分数的方法。通过解析Ajax GET请求URL规律,提取企业名称变量构建请求。重点讲解如何携带登录Cookie维持会话状态,并利用正则表达式从JSON响应中提取评级数据。最终实现将安徽省100多条发债企业数据保存至本地,适用于大规模企业评级信息查询场景。
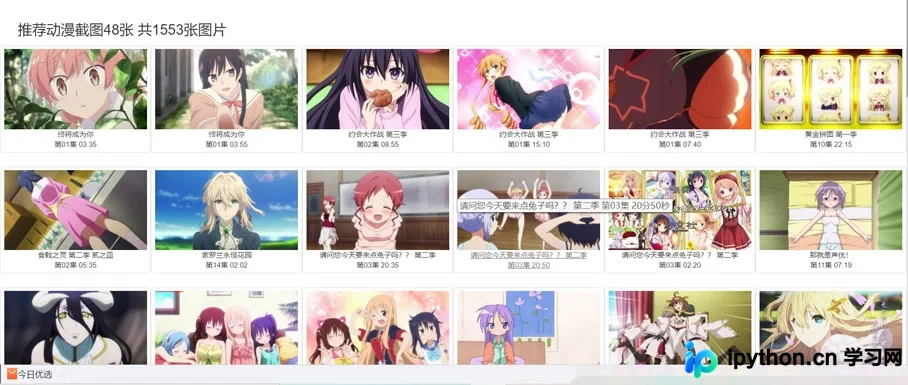
本文详细介绍使用Python爬虫批量获取动漫网站截图的完整流程。通过requests发送请求,利用正则表达式解析HTML提取图片链接与标题,结合os库管理文件存储,并引入time模块控制爬取频率以遵守网站规范。文章提供完整代码示例及分页处理技巧,帮助初学者快速掌握图片抓取实战技能。
本文介绍如何使用Python脚本批量去除指定文件夹中所有Python文件的注释。通过结合正则表达式匹配单行及多行注释,并读取INI配置文件指定源与目标路径,实现自动化清理。脚本支持忽略特定格式的注释行,并将处理后的文件保存至新目录,适用于代码优化或清理场景。
本文介绍如何在PHP中通过正则表达式格式化电话号码。函数自动去除非数字字符,并针对美国标准的7位和10位号码分别输出带分隔符或括号的格式。文中也指出该代码默认适配美国电话规则,中文用户需根据本地号码长度调整逻辑。
本文介绍如何在JavaScript中实现身份证号的完整性校验。通过结合正则表达式、省份编码映射、生日逻辑验证及ISO 7064:1983.MOD 11-2校验算法,提供从15位转换到18位校验位计算的全套代码,并在前端表单blur事件中集成实时错误提示功能。
本文介绍如何利用Python3的PyPDF2库读取PDF文件内容,并通过正则表达式精准提取特定数据。代码演示了遍历页面、合并文本、匹配股票代码与数值,以及将结果保存为CSV格式的全过程,适用于需要批量处理PDF文档数据的场景。
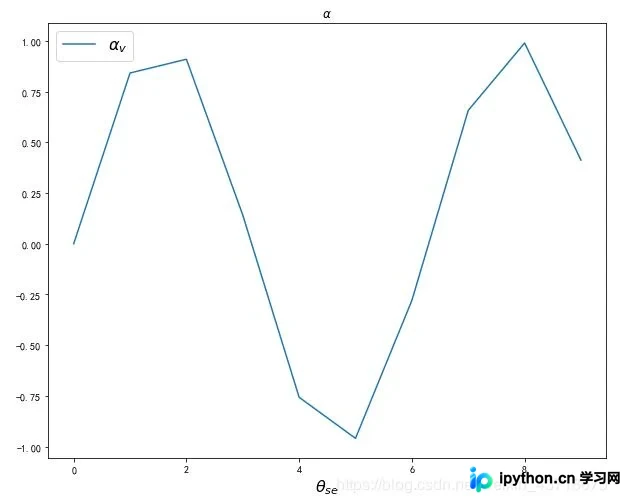
本文介绍在Python中利用Matplotlib库输出LaTeX格式的数学符号,以及使用正则表达式和eval函数解析并计算字符串中的简单数学表达式。通过具体代码示例,展示了如何在图表标题和标签中正确渲染希腊字母及下标,并实现了对包含加减乘除运算的文本字符串进行自动提取与计算。
在PHP中匹配UTF-8编码的中文,不能使用简单的字节范围匹配,否则可能误伤其他字符。正确做法是使用 Unicode 范畴 \x{4e00}-\x{9fa5},并务必添加 u 修饰符以启用 UTF-8 模式,确保正则引擎按字符而非字节进行处理。
本文介绍在C#中验证身份证号码的三种方法,涵盖从基础的长度与区域匹配,到符合GB11643-1999标准的15位和18位身份证全逻辑校验。包含详细的算法解析、省份代码映射及最后一位校验码(X)的计算过程,提供可直接使用的完整代码片段。
在PHP项目中使用preg_match进行复杂正则匹配时,若遇到匹配失败或无结果的情况,通常是因为触发了默认的回溯和递归限制。本文详解如何通过ini_set调整pcre.backtrack_limit和pcre.recursion_limit参数值,并配合memory_limit设置,确保长字符串处理的稳定性与安全性。