

Python去除字符串前后空格的几种方法
本文介绍Python中去除字符串前后空格的三种方法:使用内置的strip()函数、利用正则表达式匹配首尾空白字符,以及通过递归函数手动处理。通过具体代码示例展示各方法的实现逻辑与适用场景,帮助开发者根据实际需求选择最合适的方案。
2026-10-11
6

本文介绍Python中去除字符串前后空格的三种方法:使用内置的strip()函数、利用正则表达式匹配首尾空白字符,以及通过递归函数手动处理。通过具体代码示例展示各方法的实现逻辑与适用场景,帮助开发者根据实际需求选择最合适的方案。
本文介绍如何使用Python正则表达式匹配中括号及其内部的任意字符。通过示例代码展示利用re.search函数配合特定正则模式,实现对包含中括号内容的精准提取与匹配操作。
本文介绍如何使用Python提取包含特定字符串的行数据。通过正则表达式匹配目标字符串,结合文件读写操作,实现从原始文件中筛选并保存包含特定关键字的行。
本文介绍在Python中如何从包含多种字符的字符串中提取并保留汉字。通过定义判断Unicode范围的函数,遍历字符串并筛选出汉字字符,最终拼接成纯汉字字符串。该方法适用于需要清理文本数据或提取特定语言内容的场景。
本文提供Python3环境下抓取百度贴吧图片的完整代码示例。通过urllib获取页面源码,利用re正则表达式匹配图片URL,并结合urlretrieve实现图片的批量下载与本地存储。代码包含异常处理机制,适合初学者学习网络爬虫基础操作。
本文详解Python中检查字符串开头与结尾的两种核心方法:startswith()和endswith()。通过元组参数实现多模式匹配,对比字符串切片与正则表达式的优劣,并结合文件过滤等实际场景,提供高效且优雅的代码实现方案。
本文介绍如何使用Python正则表达式从Apache日志文件中提取特定字段,并通过重定向sys.stdout将结果写入指定文件。通过示例代码展示了如何解析IP、时间、URL及状态码,并处理文件读写与输出恢复的逻辑。
本文介绍在Python中过滤纯数字字符串的多种方法。通过对比正则表达式、try-except异常捕获以及字符串内置方法(如strip和isdigit),分析各自的适用场景与优缺点,帮助开发者选择最简洁高效的实现方案。
本文介绍使用Python编写爬虫脚本,自动抓取淘宝和天猫商品页面的主图、SKU颜色展示图以及详情页长图。通过正则表达式解析HTML数据,利用requests库发起请求并保存本地图片,实现一键批量下载功能,适用于电商数据分析与素材收集场景。
本文深入解析Python中三种核心字符串处理函数:replace、re.sub与strip。通过具体代码示例,展示如何利用字典映射进行批量字符替换,结合正则表达式实现复杂模式匹配替换,以及使用strip去除指定前后缀字符。内容涵盖基础用法、参数详解及实际应用场景,适合Python初学者及需要高效处理文本数据的开发者参考。
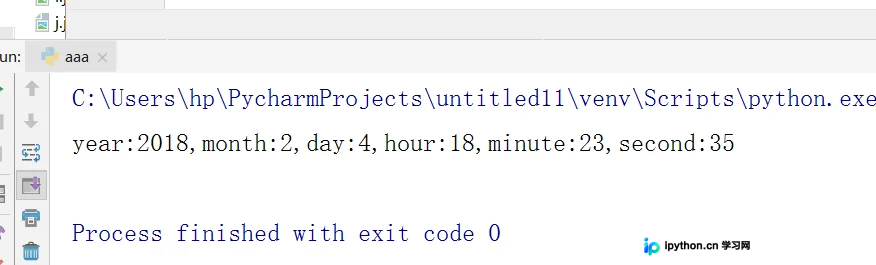
本文介绍在 Python 中将标准时间字符串(如“2018-02-04 18:23:35”)解析为包含年、月、日、时、分、秒键值对的字典的两种常用方法。通过正则表达式匹配或内置 time 模块,可以高效提取时间信息并转换为结构化数据,适用于日志分析和数据处理场景。
本文详细解析在Python中修改文件内容的多种方法,包括使用字符串replace、正则表达式re模块以及调用系统命令如sed。文章对比了不同方法的适用场景,提供了完整的代码示例,并重点提醒了直接覆盖写入文件时的数据备份风险与潜在的数据丢失隐患。