

Python提取字符串数字并求和的两种实现方法
本文介绍在Python中提取字符串内数字并求和的两种方法。第一种通过正则表达式 `re.findall` 精准匹配浮点数,代码简洁且处理边界情况可靠;第二种通过手动遍历字符,利用状态标记处理连续小数点和字母过滤。文章包含完整代码示例、运行结果及注意事项,帮助开发者快速解决字符串解析问题。
2026-10-11
6

本文介绍在Python中提取字符串内数字并求和的两种方法。第一种通过正则表达式 `re.findall` 精准匹配浮点数,代码简洁且处理边界情况可靠;第二种通过手动遍历字符,利用状态标记处理连续小数点和字母过滤。文章包含完整代码示例、运行结果及注意事项,帮助开发者快速解决字符串解析问题。
本文详解如何在Python中利用正则表达式处理PDF转文本产生的多余空格问题。通过特定正则模式,可精准去除中文及数字间的冗余空格,同时严格保留英文单词间的正常间隔。提供re.sub与split两种实现方案,并附完整代码示例,帮助开发者优化文本数据观感与后续处理效果。
本文详解 Python 中利用 re 模块进行字符串参数替换的方法。通过 re.sub 函数结合正则表达式(如匹配 ${key} 格式),实现字典数据的动态值替换。文章包含核心代码示例、正则语法解析及操作逻辑说明,帮助开发者掌握字符串处理技巧。
本文探讨在Python中使用正则表达式提取字符串内数字的两种策略。通过对比普通匹配与边界匹配,分析如何避免从混合文本中提取非独立数字。文章包含具体代码示例,展示如何正确使用原生字符串与\b边界符来精准获取纯数字数据。
本文详细解析Python中re模块findall函数的返回值机制。重点阐述正则表达式中分组括号对返回结果的影响:无分组时返回完整匹配字符串,单分组时返回分组内容,多分组时返回元组列表。通过具体代码示例对比不同写法,并介绍非捕获分组(?:)的用法,帮助开发者准确获取所需匹配信息。
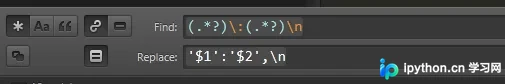
本文介绍如何将从Chrome浏览器复制的原始HTTP Header数据,通过正则表达式快速转换为Python代码中常用的字典格式。通过Sublime Text等编辑器使用特定的匹配与替换规则,在Header键值对的冒号两侧自动添加单引号并追加逗号,从而简化Python网络请求库(如requests)的参数构建过程。
本文介绍在 Python 3.x 环境下,利用正则表达式提取中文字符的两种常见场景:读取包含中文的文本文件以及处理给定的字符串。核心在于使用 Unicode 范围 [\u4e00-\u9fa5] 进行匹配,并需注意文件读取时的编码处理及字符串转义问题。
本文详细介绍Python中利用正则表达式分割字符串的方法。重点解析re.split()函数的pattern、string、maxsplit及flags参数,并通过URL分割示例演示实际应用。同时列举了ASCII、IGNORECASE等常用标志位,帮助开发者灵活控制匹配行为,提升字符串处理效率。
本文介绍在Python中利用正则表达式过滤中英文标点符号的方法。通过定义不同的正则规则r1至r4,演示如何去除文本中的特殊字符、括号及内容。代码示例展示了针对混合中英文标点及符号的过滤策略,适用于文本预处理场景。
本文介绍Python中使用re模块进行数字匹配的方法。通过\d+可提取字符串中的数字片段,但会包含嵌入数字。若需识别纯数字,应使用\b\d+\b结合单词边界(空格、标点等)进行精确匹配,避免误识别字符串内的数字部分。
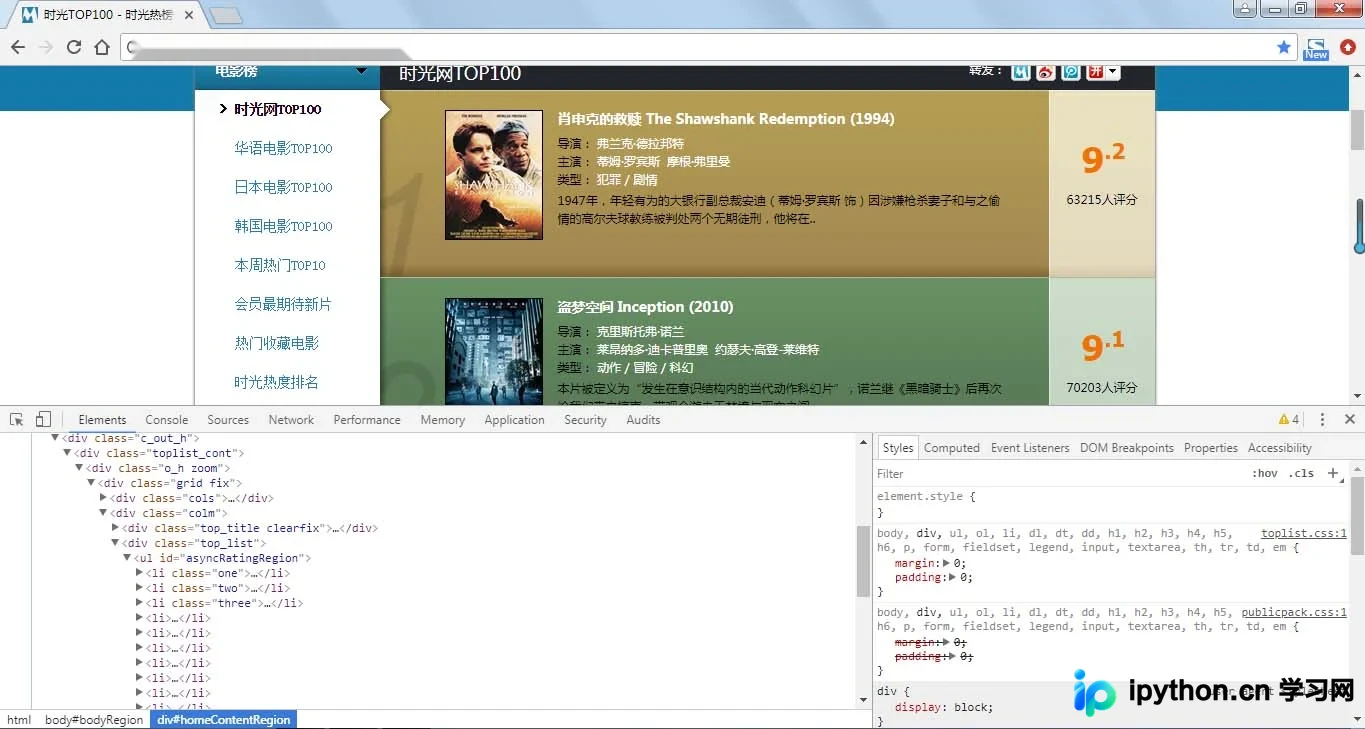
本文演示如何使用Python结合BeautifulSoup与正则表达式,从时光网爬取全球、华语、日本及韩国Top100电影数据。通过解析HTML结构处理分页逻辑,提取排名、名称、简介、评分及评论人数。随后将数据保存为CSV,利用matplotlib进行可视化对比分析,重点展示不同地区电影评论热度的差异,为数据清洗与初步分析提供完整代码示例。
本文详细介绍如何使用Python列表存储学生信息,实现添加、删除、查询、修改及显示功能。重点解析利用正则表达式进行学号格式校验,以及通过循环与条件判断实现成绩合法性检查。代码包含完整的交互逻辑与错误处理机制,适合Python初学者理解基础数据结构与流程控制的应用。