

Python用正则表达式匹配纯字母输入

在日常数据清洗、接口参数校验和表单处理场景中,确认用户输入是否为“纯英文字母”是一项基础而关键的任务。在 Python 中,最标准且严谨的解决方案是使用内置的 re 模块,通过正则表达式精确限定字符集范围,首选语句为 re.fullmatch(r'[a-zA-Z]+', text) 或带锚点的 re.match(r'^[a-zA-Z]+$', text)。本文将从核心正则语法、标准化操作步骤、底层陷阱辨析到常见场景选型展开系统讲解。
一、核心正则表达式拆解与语法解析
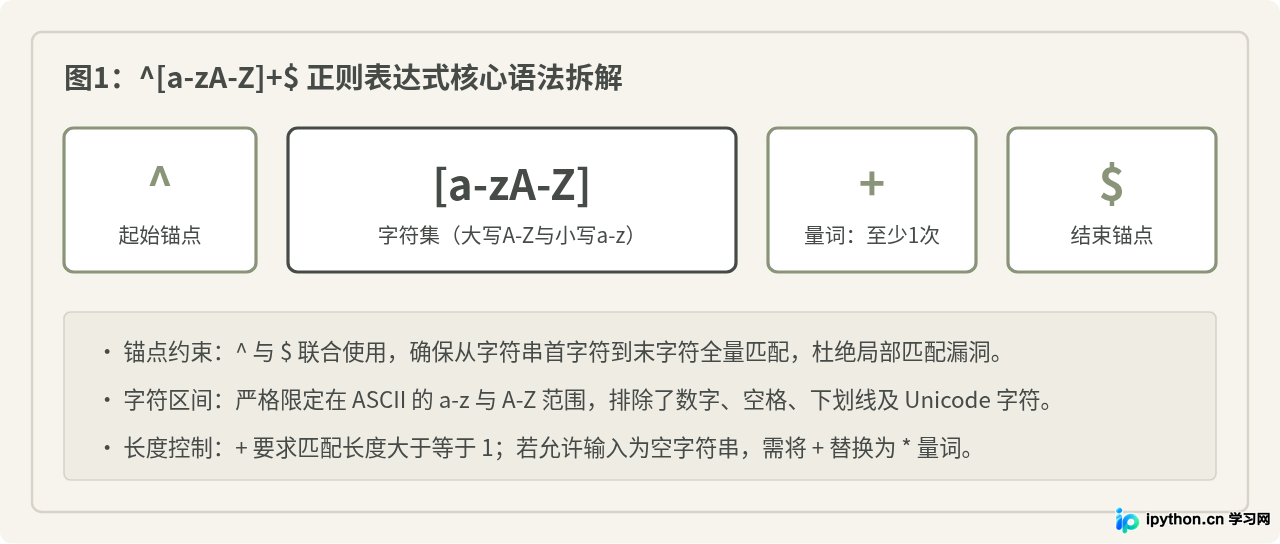
实现纯字母匹配的核心正则模式为 ^[a-zA-Z]+$。虽然表达式非常简短,但其中每一个字符单元都承担着不可或缺的边界防御职责:
^(脱字符):匹配输入字符串的起始位置。确保匹配过程从第一个字符开始,杜绝忽略开头非法字符的隐患。[a-zA-Z](字符集区间):方括号定义了一个字符集。a-z涵盖所有小写英文字母(ASCII 97 至 122),A-Z涵盖所有大写英文字母(ASCII 65 至 90)。两个区间连写表示“小写或大写”,排除了数字、空格、下划线及所有标点符号。+(正闭包量词):表示匹配前面的字符集至少 1 次,上限不限。若业务允许空字符串输入,可替换为*量词。$(美元符):匹配输入字符串的结束位置。确保直到最后一个字符结束,没有跟随任何其他非字母字符。
二、Python 代码实现与标准操作流程
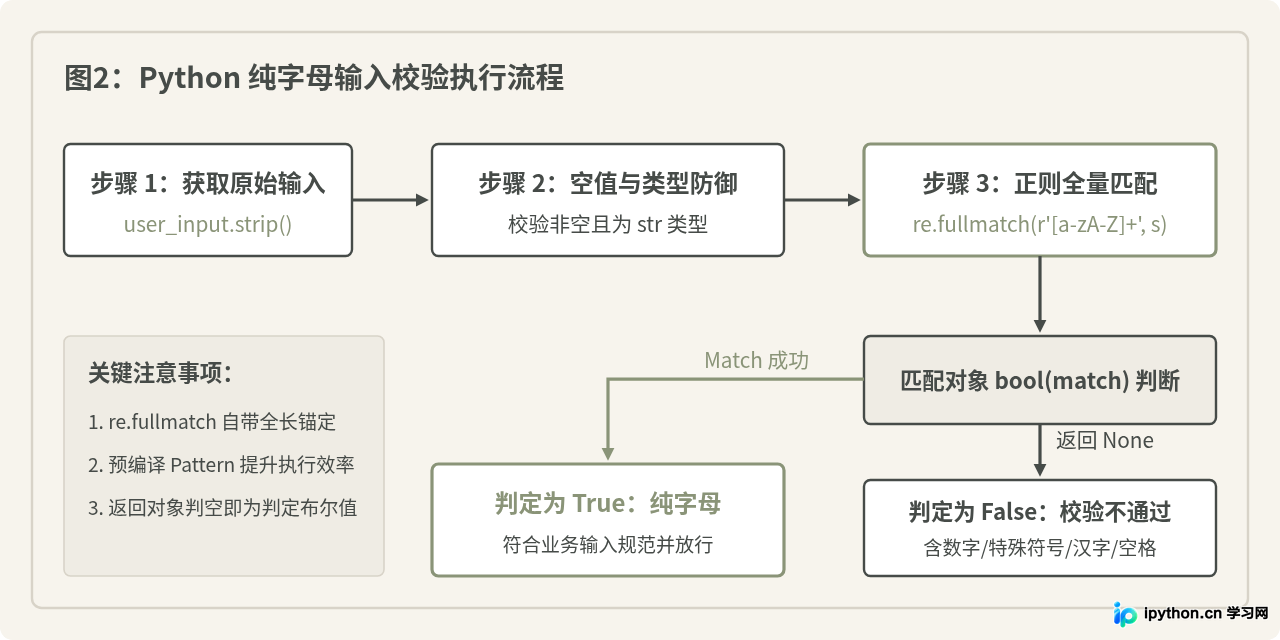
在 Python 程序中,实现验证功能通常遵循“数据清洗 -> 类型检查 -> 模式匹配 -> 结果布尔化”的标准流程。推荐使用 re.compile() 将正则模式预编译,尤其在高并发或循环迭代场景中,预编译能够复用内部状态机,减少重复编译带来的额外开销。
import re

# 预编译正则模式:严格匹配 ASCII 范围内的英文字母
LETTER_PATTERN = re.compile(r'^[a-zA-Z]+$')

def validate_letters_only(user_input: str) -> bool:
    """
    验证输入字符串是否完全由英文字母组成。

    参数:
        user_input: 待检测的输入对象
    返回:
        bool: 全为英文字母返回 True,否则返回 False
    """
    if not isinstance(user_input, str):
        return False

    # 根据业务需求决定是否去除首尾空白
    cleaned_text = user_input.strip()
    if not cleaned_text:
        return False

    return bool(LETTER_PATTERN.fullmatch(cleaned_text))

# 测试示例
test_cases = [
    ("Python", True),
    ("HelloWorld", True),
    ("Python3", False),       # 包含数字
    ("hello world", False),   # 包含空格
    ("user_name", False),     # 包含下划线
    ("你好", False),           # 包含中文字符
    ("", False),              # 空字符串
]

for text, expected in test_cases:
    result = validate_letters_only(text)
    assert result == expected, f"测试失败: {text}"
print("所有基准用例测试通过!")
三、常见误区与深层辨析
在实际开发中,开发者容易采用看似简便但暗藏漏洞的替代方案。以下三个易混淆点需要重点防范:
1. 误区一:混淆 re.match 与 re.fullmatch
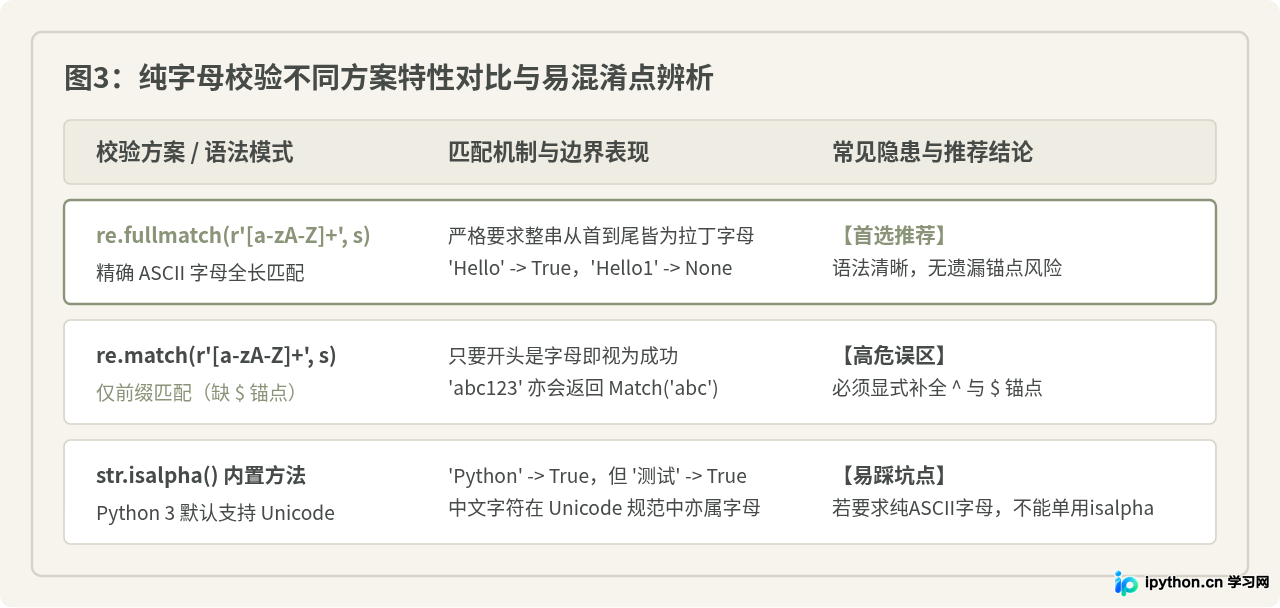
很多初学者误以为 re.match(r'[a-zA-Z]+', text) 能校验全串。事实上,re.match 的底层定义是“仅从字符串头部开始匹配”。若字符串为 "Hello123",re.match 会成功匹配前面的 "Hello" 并返回 Match 对象,从而导致校验逻辑彻底失效。要使用 re.match,必须显式带上末尾锚点 $;而使用 re.fullmatch 时,正则引擎默认强制两端完全对齐,更不易遗漏。
2. 误区二:使用 \w 匹配字母
部分教程将 \w 解释为“字母”。但在正则表达式标准中,\w 代表的是“单词字符”,不仅包含英文字母,还天然包含十进制数字 0-9 以及下划线 _。更重要的是,在 Python 3 中,正则表达式默认开启 Unicode 标志,\w 还会直接匹配汉字、假名、希腊字母等全角字符。因此,^\w+$ 绝不能用来验证纯字母输入。
3. 误区三:轻信内置方法 str.isalpha()
Python 字符串内置的 str.isalpha() 常被误当做最简单的判断方式。但必须注意,Python 3 的 str.isalpha() 遵循的是 Unicode 标准(涵盖类别 L),例如 "你好".isalpha() 返回的是 True!如果业务场景要求的是纯 ASCII 拉丁字母(例如用户英文 ID、纯英文编码),单用 isalpha() 将导致中文字符穿透校验。若要使用内置方法,必须组合为 text.isascii() and text.isalpha(),而正则表达式 ^[a-zA-Z]+$ 在意图表达和边界控制上更为明确直观。
四、规则速查与常见业务场景选型
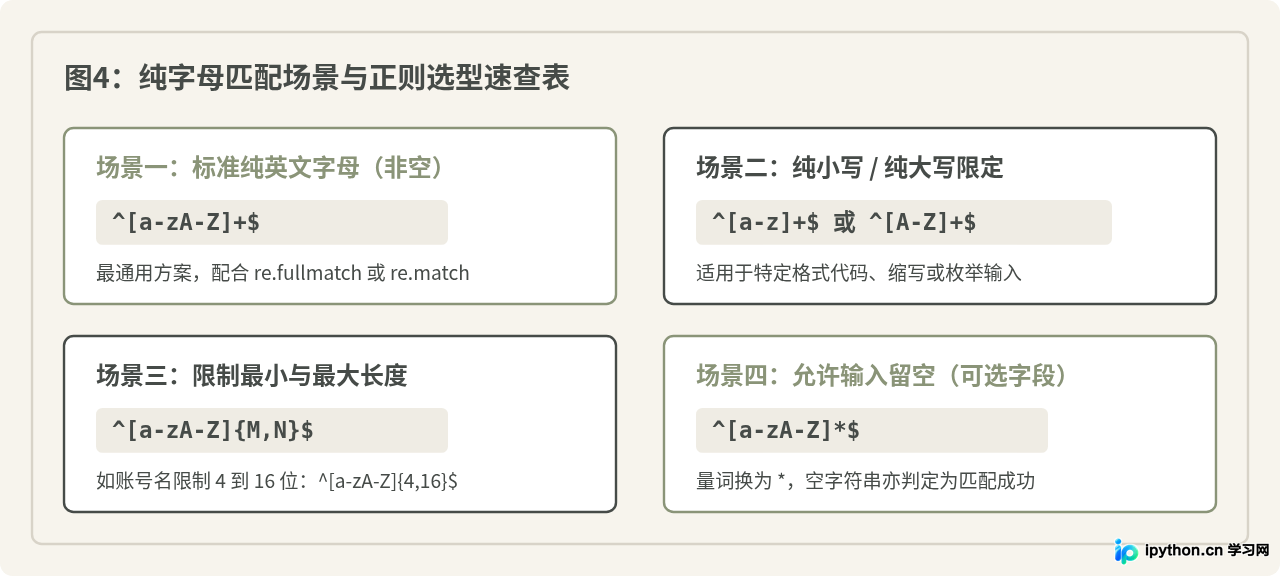
在实际生产业务中,除了基础纯英文字母校验,往往还伴随着大小写区分、长度约束或可选填输入等细节变体。开发者可根据下述速查表直接选取相匹配的模式:
r'...',并配合 re.fullmatch() 执行。无论正则内部是否书写 ^ 和 $,都能确保从首至尾的全串严格校验。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









