

Python正则表达式re库使用指南:从入门到实战

本文详解Python中re库的核心用法,涵盖compile、match、search及findall等关键函数的定义与区别。深入解析正则符号如点号、星号、问号及分组机制,并通过邮箱提取等实例演示group与groups方法的实际应用,帮助开发者掌握文本模式匹配与数据提取技巧。
Python正则表达式基础与导入
一、导入re库
在Python中运用正则表达式,首先需要在代码中导入内置的re库。
import re
该库主要用于检索、查找或替换符合特定规则(模式)的文本内容。
正则表达式使用步骤
二、使用正则表达式步骤
第一步,分析目标文本并找出其内在规律;
第二步,利用正则表达式中的特殊符号将这些规律形式化;
第三步,执行提取操作。只有当文本中的每个字符都能与正则模式匹配时,才视为匹配成功;若出现任何一个字符无法匹配的情况,则整个匹配过程失败。
常见正则符号详解
三、正则表达式中常见的基本符号
1.点号“.”
单个点号可以匹配除换行符(\n)之外的任意一个字符,这包括英文字母、数字、汉字以及各种中英文标点符号。
2.星号“*”
星号表示其前面的子表达式(可以是普通字符,也可以是其他正则符号)可以出现0次到无限次。
3.问号“?”
问号表示其前面的子表达式可以出现0次或1次。请注意,此处必须使用英文状态下的问号。
4.反斜杠“\”
在正则表达式乃至整个Python语法中,反斜杠都不能单独存在。它必须与其他字符组合使用,作用是将特殊符号转换为普通字符,或将普通字符转换为具有特殊含义的正则符号,例如“\n”代表换行符。
5.数字“\d”
在正则表达式中,“\d”用于匹配单个数字字符。需要强调的是,尽管“\d”由反斜杠和字母d组成,但在正则引擎中应将其视为一个整体的匹配符号。
6.小括号“()”
小括号的主要功能是将括号内的内容作为一个整体进行提取或分组。
正则表达式实战案例
四、常见的正则表达式举例
1. .*?(匹配所有内容)
例如,使用正则表达式 '<title>(.*?)</title>' 可以高效地从网页源码中提取出标题内容。
2、\w 单词字符[A-Za-z0-9_], "+" 匹配前一个字符1次或无限次。例如,假设有一个邮箱地址为lixiaomei@qq.com,我们需要从大量字符串中将其提取出来。
pattern: \w+@\w+\.com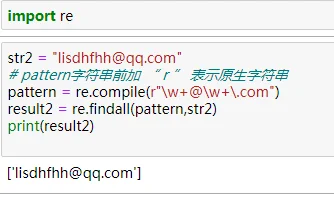
思考:若邮箱格式变为hello123@heuet.edu.com,该如何进行匹配?
pattern:\w+@(\w+\.)?\w+\.com?代表了匹配0次或者1次括号分组内的匹配内容,"()"则表示被括内容是一个分组,分组序号从pattern字符串起始往后依次排列。因为是匹配0次或1次,那么就意味着括号内的部分是可有可无的,所以这个pattern就可能匹配以上两种邮箱格式。
扩展: \w+@(\w+\.)*\w+\.com 模式就更厉害了," * " 可以匹配0次或无限次。
re库核心函数解析
五、re库的核心函数
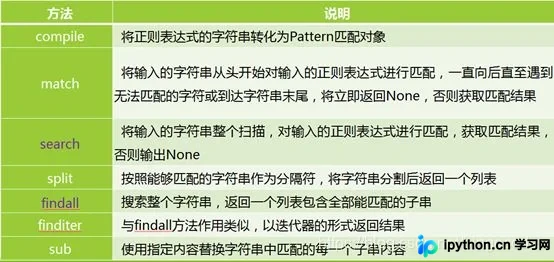
1、compile()函数 (可有可无)
- 函数定义: compile(pattern, flag=0)
- 函数描述:编译正则表达式pattern,然后返回一个正则表达式对象。
为什么要对pattern进行编译呢?《Python核心编程》里面是这样解释的:
使用预编译的代码对象比直接使用字符串要快,因为解释器在执行字符串形式的代码前都必须把字符串编译成代码对象。
2、match()函数
- 函数定义: match(pattern, string, flag=0)
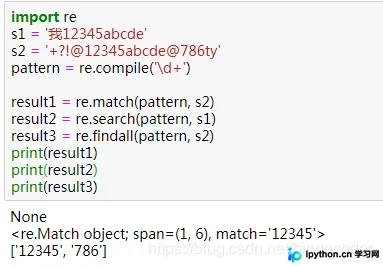
- 函数描述:只从字符串的最开始与pattern进行匹配,匹配成功返回匹配对象(只有一个结果),否则返回None。
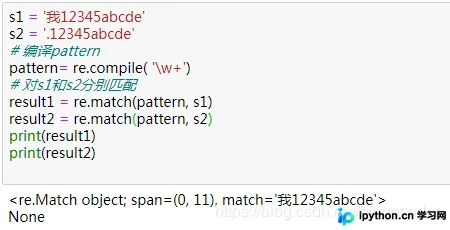
问题来了,为什么result1结果有这么多的东西啊?貌似最后一个才是要匹配的对象。这个要怎么提取出来呀?
别着急,我们现在得到的是匹配对象,需要用一定的方法提取,后面会在《匹配对象的方法》章节来解决这个问题,继续往下看。
3、search()函数
- 函数定义: search(pattern, string, flag=0)
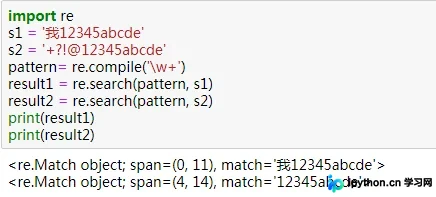
- 函数描述:与match()工作的方式一样,但是search()不是从最开始匹配的,而是从任意位置查找第一次匹配的内容。如果所有的字串都没有匹配成功,返回None,否则返回匹配对象。
4、findall()函数
- 函数定义: findall(pattern, string [,flags])
- 函数描述:查找字符串中所有出现的正则表达式模式,并返回一个匹配列表
匹配对象提取方法
上面同时列出了match、search、findall三个函数用法。findall与match和search不同的地方是它会返回一个所有无重复匹配的列表。如果没找到匹配部分,就返回一个空列表。六、匹配对象的方法(提取)
以上re模块函数的返回内容可以分为两种:
- 返回匹配对象:就是上面如 <_sre.SRE_Match object; span=(0, 5), match='12345'>这样的对象,可返回匹配对象的函数有match、search、finditer。
- 返回一个匹配的列表:返回列表的就是 findall。
因此匹配对象的方法只适用match、search、finditer,而不适用与findall。
常用的匹配对象方法有这两个:group、groups、还有几个关于位置的如 start、end、span就在代码里描述了。
1、group方法
- 方法定义:group(num=0)
- 方法描述:返回整个的匹配对象,或者特殊编号的字组
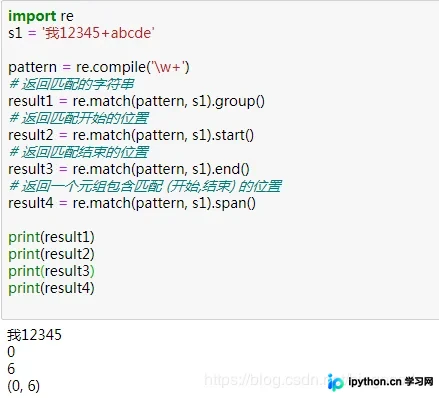
再看下面的实例:
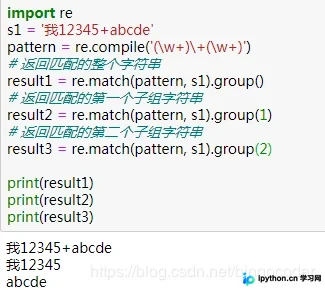
这里就需要用到我们之前提到的分组概念。
分组的意义在于:我们不仅仅想得到匹配的整个字符串,我们还想得到整个字符串里面的特定子字符串。如上例中,整个字符串是“我12345+abcde”,但是想得到 “abcde”,我们就可以用()括起来。因此,你可以对pattern进行任何的分组,提取你想得到的内容。
2、groups方法
- 方法定义:groups(default =None)
- 方法描述:返回一个含有所有匹配子组的元组,匹配失败则返回空元组
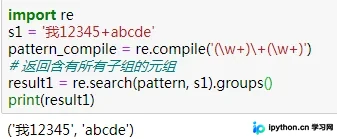
re模块标志位属性
七、re模块的属性(flag)
re模块的常用属性有以下几个:
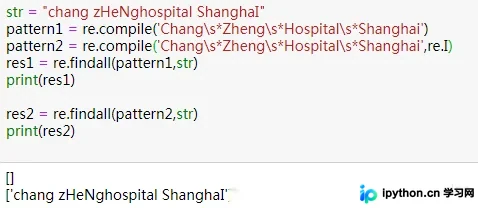
- re.I: 匹配不分大小写;(常用)
- re.L: 根据使用的本地语言环境通过\w, \W, \b, \B, \s, \S实现匹配;
- re.M: ^和$分别匹配目标字符串中行的起始和结尾,而不是严格匹配整个字符串本身的起始和结尾;
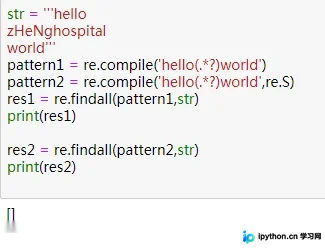
- re.S: “.”(点号)通常匹配除了\n(换行符)之外的所有单个字符,该标记表示“.”(点号)能够匹配全部字符;(常用)
- re.X: 通过反斜线转义,否则所有空格加上#(以及在该行中所有后续文字)都被忽略,除非在一个字符类中或者允许注释并且提高可读性;
注意:
如果我们定义了compile编译,需要先将flag填到compile函数中,否则填到匹配函数中会报错; 如果没有定义compile,则可以直接在匹配函数findall中填写flag。
附录:
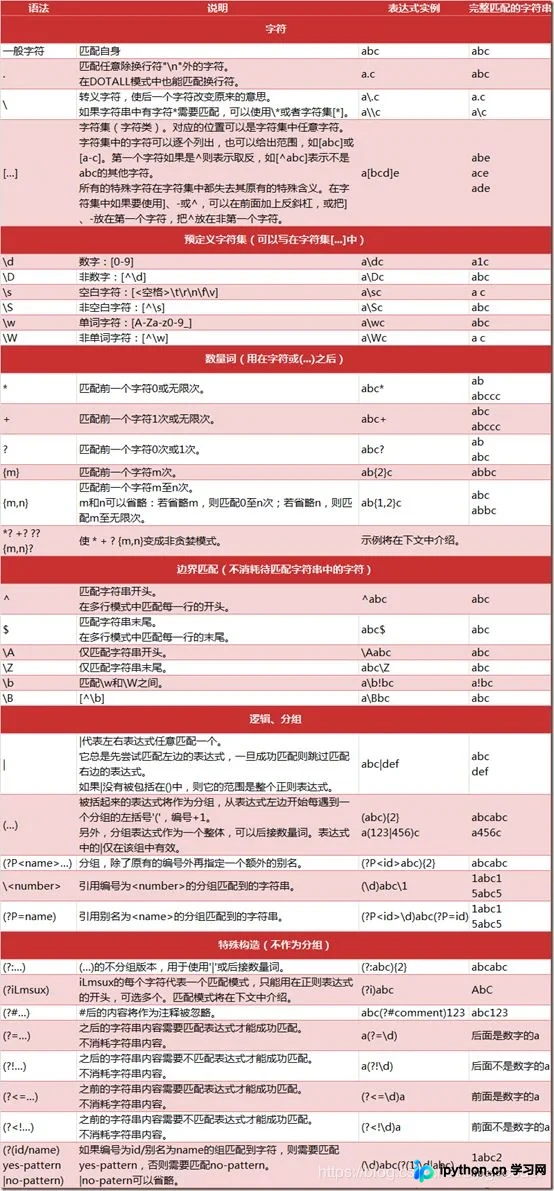
正则表达式中语法一览表
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









