

Python爬虫实战:批量抓取动漫截图教程
本文详细介绍使用Python爬虫批量获取动漫网站截图的完整流程。通过requests发送请求,利用正则表达式解析HTML提取图片链接与标题,结合os库管理文件存储,并引入time模块控制爬取频率以遵守网站规范。文章提供完整代码示例及分页处理技巧,帮助初学者快速掌握图片抓取实战技能。
2026-10-13
6

本文详细介绍使用Python爬虫批量获取动漫网站截图的完整流程。通过requests发送请求,利用正则表达式解析HTML提取图片链接与标题,结合os库管理文件存储,并引入time模块控制爬取频率以遵守网站规范。文章提供完整代码示例及分页处理技巧,帮助初学者快速掌握图片抓取实战技能。
本文介绍如何使用Python脚本批量去除指定文件夹中所有Python文件的注释。通过结合正则表达式匹配单行及多行注释,并读取INI配置文件指定源与目标路径,实现自动化清理。脚本支持忽略特定格式的注释行,并将处理后的文件保存至新目录,适用于代码优化或清理场景。
本文介绍如何利用Python3的PyPDF2库读取PDF文件内容,并通过正则表达式精准提取特定数据。代码演示了遍历页面、合并文本、匹配股票代码与数值,以及将结果保存为CSV格式的全过程,适用于需要批量处理PDF文档数据的场景。
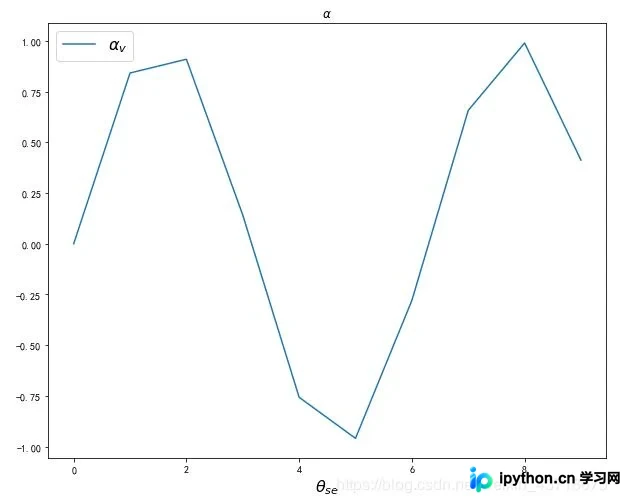
本文介绍在Python中利用Matplotlib库输出LaTeX格式的数学符号,以及使用正则表达式和eval函数解析并计算字符串中的简单数学表达式。通过具体代码示例,展示了如何在图表标题和标签中正确渲染希腊字母及下标,并实现了对包含加减乘除运算的文本字符串进行自动提取与计算。
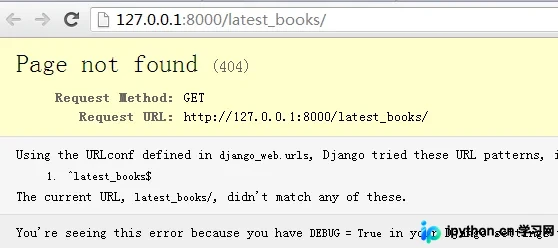
本文深入解析Django框架中URL映射的核心机制与服务器响应顺序。涵盖Python模块搜索路径、URL正则匹配规则(包括锚点符号与斜杠处理)、根目录配置方法,以及从浏览器发起请求到返回HTTP响应的完整执行步骤,帮助开发者掌握Django路由配置的关键细节。
本文通过Python面向对象编程实现当当网书籍数据抓取,演示了正则表达式、BS4和XPath三种解析方式,以及TXT、CSV和MySQL三种存储方案。文章提供完整代码示例,对比各解析方法的优劣,帮助开发者掌握高效的数据爬取与处理技巧。
本文深入解析Python中re模块的核心正则处理函数。详细讲解re.match与re.search在匹配位置上的差异,介绍re.compile生成正则对象以优化性能的方法。同时涵盖findall、finditer获取所有匹配项,以及split和sub进行字符串分割与替换的高级用法,配合代码示例说明参数flags及贪婪非贪婪匹配机制。
本文通过多个Python正则表达式实战案例,详细解析字符串处理技巧。内容涵盖数字范围匹配、座机与QQ号格式校验、多字符分割、连续数字替换、字母提取、单词查找及HTML标签清理等常见场景。每个案例均提供完整代码与运行结果,帮助开发者快速掌握re模块在数据清洗和文本分析中的实际应用。
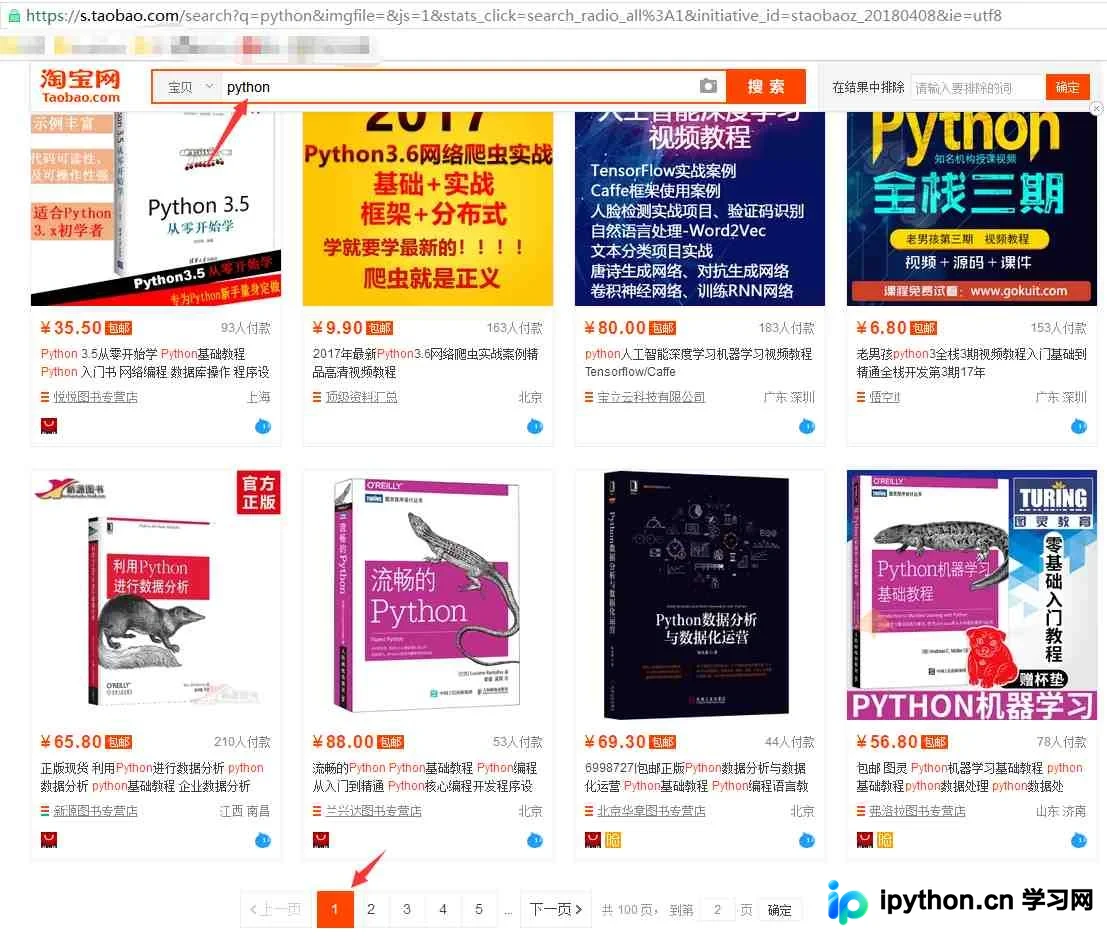
本文详细介绍如何使用Python的requests和re库爬取淘宝商品列表。通过解析URL参数q和s,构建分页请求,利用正则表达式精准提取raw_title和view_price字段。代码示例展示了从获取HTML源码、解析数据到存储结果的完整流程,适合Python初学者学习网络爬虫基础。
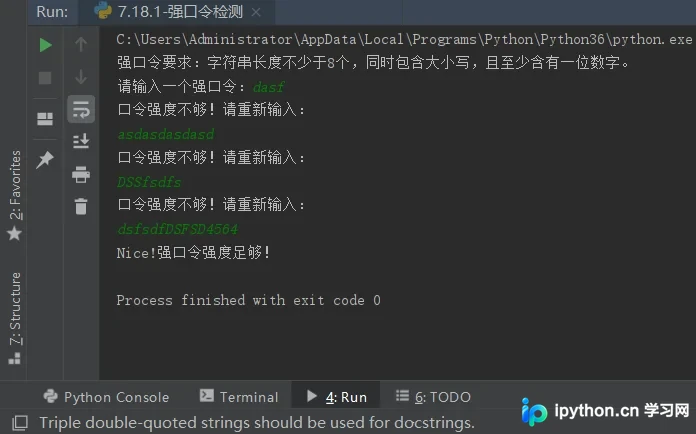
本文详解如何使用Python正则表达式实现强口令检测算法。通过定义长度不少于8位、包含大小写字母及至少一个数字的组合规则,利用re模块编译正则对象进行匹配。代码包含循环输入与函数调用逻辑,确保口令符合安全标准,并提供在线工具辅助验证。
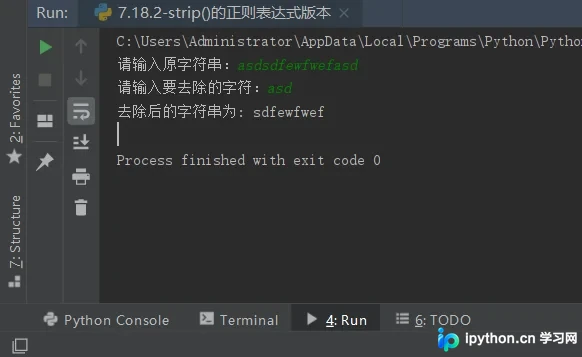
本文详细解析了如何使用Python的正则表达式模块re来模拟内置strip()函数的功能。通过构建包含首尾匹配符^和$的正则模式,结合format方法动态传入待去除字符,实现了灵活的字符串首尾清理。代码演示了如何处理默认空白字符及自定义字符的去除逻辑,为理解正则表达式在字符串操作中的应用提供了具体案例。
本文介绍如何使用Python统计文章中的单词出现次数。核心思路利用字典记录单词及其频次,结合正则表达式精准提取单词,并通过文件读写功能处理文本数据。文章提供了完整的Counter类实现代码,演示如何从文件中读取内容、清洗数据并排序输出高频单词,适合Python初学者学习数据结构应用与文本处理技巧。