

Python中re正则匹配数据的实现
本文详解Python正则表达式(re模块)的核心语法、常用函数及高级用法。通过元字符对照表掌握模式匹配规则,结合re.match、re.search、re.findall等函数实现数据提取与替换,并给出基于正向预查断言的随机密码生成方案,帮助开发者高效处理复杂文本匹配任务。
2026-10-11
7

本文详解Python正则表达式(re模块)的核心语法、常用函数及高级用法。通过元字符对照表掌握模式匹配规则,结合re.match、re.search、re.findall等函数实现数据提取与替换,并给出基于正向预查断言的随机密码生成方案,帮助开发者高效处理复杂文本匹配任务。
本文介绍在 Python 3.x 环境下,利用正则表达式提取中文字符的两种常见场景:读取包含中文的文本文件以及处理给定的字符串。核心在于使用 Unicode 范围 [\u4e00-\u9fa5] 进行匹配,并需注意文件读取时的编码处理及字符串转义问题。
Python处理文本时依赖正则表达式实现高效模式匹配。本文详细演示re.search定位首个匹配、re.findall与re.finditer批量获取、re.compile预编译优化性能、命名捕获组解析结构化文本,以及re.sub一键清除换行与空格的完整操作,附带可直接运行的代码示例,覆盖日常数据清洗与解析需求。
本文介绍如何使用Python内置的re模块进行正则表达式操作。通过导入模块、编译模式字符串、使用search()和split()方法,您可以高效地搜索、匹配和分割文本数据。文章涵盖基础语法、特殊字符处理及常见应用场景,帮助开发者掌握Python文本处理的核心技能。
本文介绍Python中去除字符串前后空格的三种方法:使用内置的strip()函数、利用正则表达式匹配首尾空白字符,以及通过递归函数手动处理。通过具体代码示例展示各方法的实现逻辑与适用场景,帮助开发者根据实际需求选择最合适的方案。
本文介绍在 Python3 中使用正则表达式进行万能匹配的方法。通过采用 [\s\S]*? 模式,可以突破单行匹配的限制,实现对包含换行符在内的任意字符进行非贪婪匹配。结合括号分组,可进一步提升匹配效果与提取效率。
本文介绍如何使用Python提取包含特定字符串的行数据。通过正则表达式匹配目标字符串,结合文件读写操作,实现从原始文件中筛选并保存包含特定关键字的行。
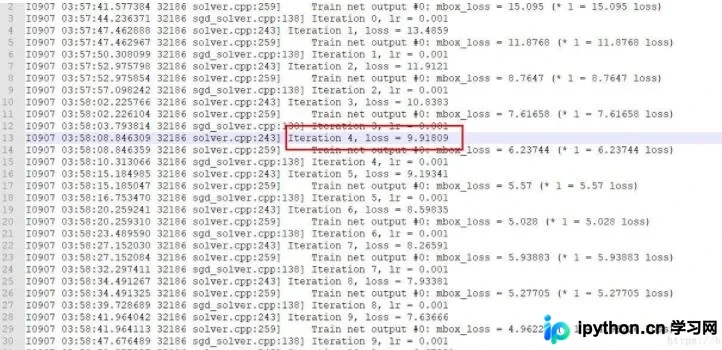
本文介绍如何使用Python正则表达式从Apache日志文件中提取特定字段,并通过重定向sys.stdout将结果写入指定文件。通过示例代码展示了如何解析IP、时间、URL及状态码,并处理文件读写与输出恢复的逻辑。
数据清洗是数据分析的核心环节。本文整理Python处理字符串、数值、日期及缺失值的18种高效方法,涵盖基础语法技巧,并深入讲解正则提取、Pandas批量操作、异常捕获与函数封装等进阶流程,帮助开发者快速规范数据格式、提升处理效率。
本文介绍在Python中过滤纯数字字符串的多种方法。通过对比正则表达式、try-except异常捕获以及字符串内置方法(如strip和isdigit),分析各自的适用场景与优缺点,帮助开发者选择最简洁高效的实现方案。
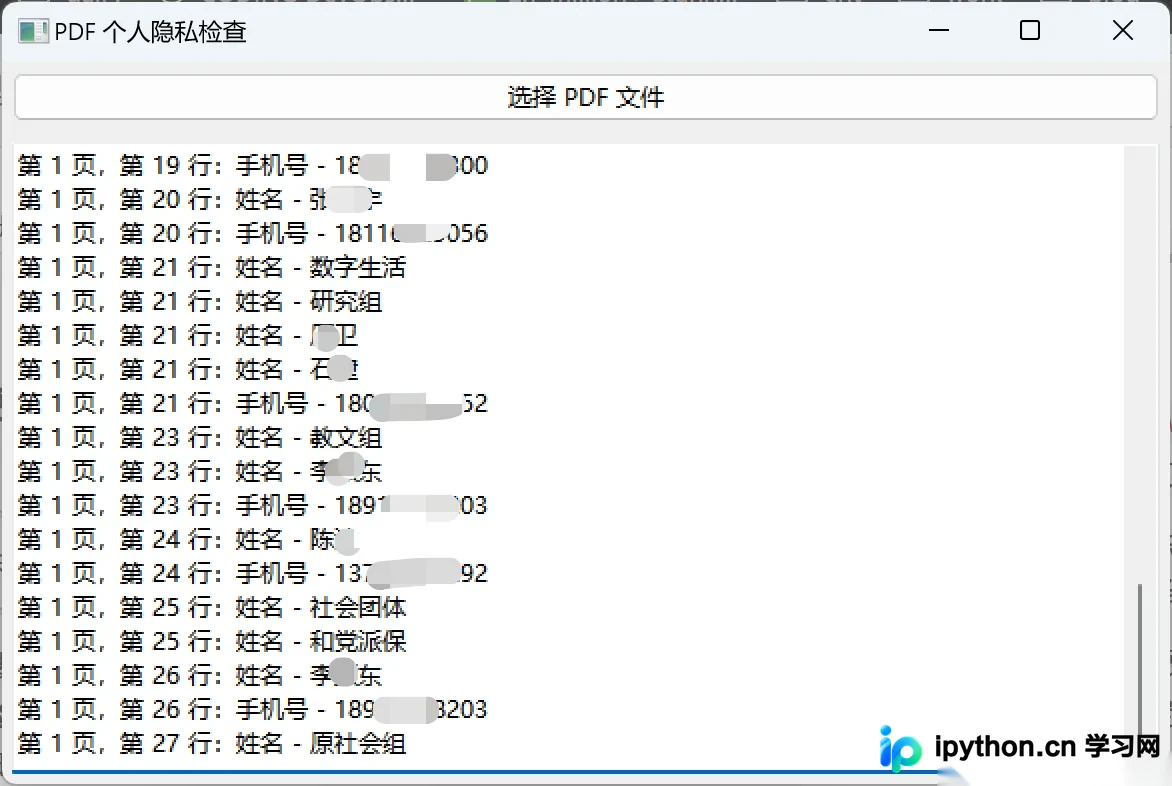
本文介绍使用Python结合pdfplumber库提取PDF文本,并配合正则表达式快速定位姓名、身份证号、手机号等敏感数据的方法。通过wxPython搭建桌面界面,输入文件后自动输出结果页码与行号,支持按需扩展检测规则,适用于日常文档脱敏审查。
Python正则表达式中,非捕获组((?:...))专为逻辑分组设计,不保存匹配结果。通过对比普通捕获组,可直观掌握其语法特性。本文结合实际提取、交替匹配及性能基准测试代码,详细说明何时使用非捕获组以降低内存消耗并提升大规模文本处理速度。