

Python中re正则匹配数据的实现

本文详解Python正则表达式(re模块)的核心语法、常用函数及高级用法。通过元字符对照表掌握模式匹配规则,结合re.match、re.search、re.findall等函数实现数据提取与替换,并给出基于正向预查断言的随机密码生成方案,帮助开发者高效处理复杂文本匹配任务。
正则表达式基础语法与元字符速查
正则表达式是一种强大的文本处理工具,它使用特定的句法规则描述字符串模式,广泛应用于数据验证、检索与批量替换。在Python中,标准库提供了re模块来调用该功能。掌握以下核心语法是高效匹配的前提:
基础字符与类
- 普通字符:
a-z、A-Z、0-9等直接匹配自身。 - 转义序列:
\n(换行)、\t(制表符)、\\(反斜杠本身)。特殊符号前加\可关闭其元字符属性。 - 字符集:
[abc]匹配指定字符之一,[^abc]为取反,[a-z]表示范围。
常用量词与边界控制
.匹配除换行外的任意单字符;*、+、?分别表示零或多次、一次或多次、零或一次。{n}、{n,}、{n,m}控制精确次数或区间。贪婪模式默认尽可能多匹配,末尾加?(如*?)可切换为非贪婪(最少匹配)。锚点^匹配开头,$匹配结尾,\b为单词边界。
高级构造:分组、选择与断言
- 捕获与非捕获分组:
(pattern)将子表达式打包并记录内容,供反向引用\1使用;(?:pattern)仅组合逻辑不占用内存记录。 - 多选分支:
a|b匹配前者或后者。 - 前瞻断言:正向前瞻
(?=...)与负向前瞻(?!...)要求后续字符符合条件但不消耗字符;后顾断言(如(?<=...))需依赖底层引擎支持(Python原生re不支持变长后顾)。
Python re模块核心函数与应用
re模块提供了一系列用于模式匹配的内置方法。使用时建议先通过re.compile()预编译正则对象以提升重复匹配效率。以下是各函数的实际作用与参数说明:
第1步:导入模块并编译正则对象
目的:构建可复用的正则表达式实例,避免每次调用重复解析。
import re
# compile() 返回 Pattern 对象,支持 flags 参数控制行为(如 re.IGNORECASE)
pattern_obj = re.compile(r'\d+')
第2步:使用搜索与提取函数定位数据
re.match(pattern, string):仅从字符串起始位置尝试匹配,成功返回匹配对象,否则为None。re.search(pattern, string):扫描整个字符串,返回首个匹配成功的对象。re.findall(pattern, string):一次性提取所有符合模式的子串,返回列表。re.finditer(pattern, string):返回迭代器,适用于大型文本流式处理,逐个产出匹配对象以节省内存。
# search() 获取第一个匹配结果
result = re.search(r',\s*', 'Hello, World!')
if result:
    print(result.group())  # 输出: ,

# findall() 批量提取数字
nums = re.findall(r'\d+', 'Price: 20, Tax: 5')
print(nums)  # 输出: ['20', '5']
第3步:执行分割与全局替换
re.split(pattern, string):按匹配到的分隔符切分字符串。re.sub(pattern, repl, string):将匹配到的内容替换为目标文本,可通过计数参数限制替换次数。
# 以逗号加空格分割列表
text_list = re.split(r',\s*', 'A,B,C,D')
print(text_list)  # 输出: ['A', 'B', 'C', 'D']

# 替换连续空白符为单横杠
cleaned = re.sub(r'\s+', '-', 'Data\tProcessing  Pipeline')
print(cleaned)  # 输出: Data-Processing-Pipeline
匹配对象常用方法
成功匹配的Match对象提供丰富的索引接口:.group()获取完整匹配串;.start()与.end()返回起止索引;.span()直接输出(start, end)元组;若正则包含分组,.group(1)可精准提取对应子串。
实战:基于正向预查验证并生成安全密码
正则断言非常适合处理多重约束条件。下面演示如何编写一个校验规则,强制密码必须包含至少一位数字、一个大写或小写字母、一个特殊符号,且长度不低于8位。随后利用该规则配合循环采样生成合规字符串。
构建复合验证规则
目标正则逻辑如下:
rule_pattern = r'^(?=.*\d)(?=.*[a-zA-Z])(?=.*[!@#$%^&*()\-_=+]).{8,}$'
结构拆解:
^与$锁定首尾,确保全文本符合规范。(?=.*\d)、(?=.*[a-zA-Z])、(?=.*[!@#$%^&*()\-_=+])为正向预查,并行检查是否包含指定类别字符。.{8,}兜底长度限制。
第4步:实现随机密码生成器
注意:此类基于概率采样的生成方式适合宽松场景。若对安全性或确定性要求极高,建议显式拼接必选字符后再随机打乱。
import re
import random
import string

def generate_secure_password(length=12):
    chars_pool = string.ascii_letters + string.digits + '!@#$%^&*()-_=+'
    compiled_rule = re.compile(r'^(?=.*\d)(?=.*[a-zA-Z])(?=.*[!@#$%^&*()\-_=+]).{8,}$')

    while True:
        candidate = ''.join(random.choices(chars_pool, k=length))
        if compiled_rule.search(candidate):
            return candidate

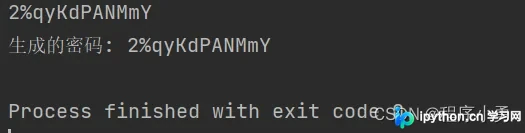
new_pw = generate_secure_password()
print(new_pw)
总结
Python的re模块以简洁的API覆盖了绝大多数文本清洗与模式识别需求。合理运用预查断言、非捕获分组与编译优化,能显著提升正则表达式的执行效率与可读性。在实际项目中,建议针对高频调用的复杂表达式提前编译,并结合flag参数(如忽略大小写re.I、多行匹配re.M)微调行为。
以上就是Python正则表达式re模块使用与文本匹配实战的详细内容,更多关于Python编程与数据处理技巧的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









