

Python爬虫指南:urllib.request与requests库的使用及核心区别
本文详细解析Python中urllib.request与requests库的使用方法及核心差异。通过对比urlopen()与Request类的构建方式,以及requests库对GET/POST请求的便捷封装,帮助开发者理解为何在实际开发中更推荐使用requests。内容涵盖Headers添加、响应数据处理及代码示例,适合Python爬虫初学者参考。
2026-10-13
1

本文详细解析Python中urllib.request与requests库的使用方法及核心差异。通过对比urlopen()与Request类的构建方式,以及requests库对GET/POST请求的便捷封装,帮助开发者理解为何在实际开发中更推荐使用requests。内容涵盖Headers添加、响应数据处理及代码示例,适合Python爬虫初学者参考。
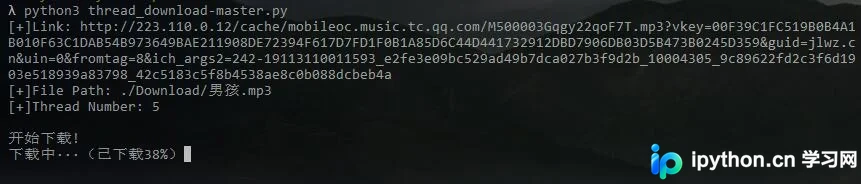
本文介绍使用Python实现多线程下载网络资源的完整脚本。通过Download类计算文件总大小并分配线程任务,结合ThreadDownload类继承threading.Thread实现并发读写。代码包含URL请求头设置、分块下载逻辑及进度回显功能,适用于歌曲或大文件的高效下载场景。
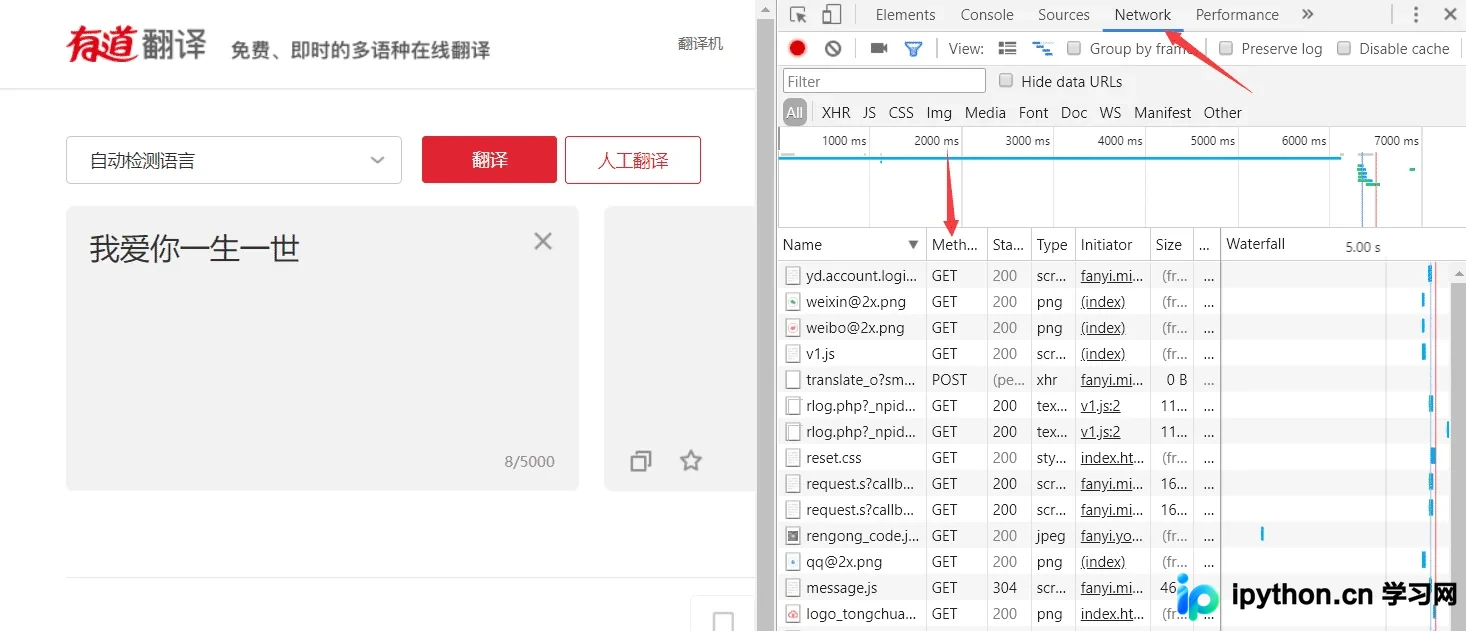
本文详解如何使用Python的urllib库模拟有道在线翻译的POST请求。通过浏览器开发者工具分析网络请求,识别GET与POST差异,重点讲解urlopen方法中data参数的应用、字典数据的构造以及UTF-8编码转换原理,帮助开发者掌握基础网页抓取与接口模拟技巧。
本文详细解析Python中处理含中文URL参数的常见需求,重点介绍urllib库中的urlencode和unquote函数。通过具体代码示例,展示如何将键值对转换为标准查询字符串,以及如何对单个字符串进行编码和解码操作,解决Callback等场景下的中文传递问题。

针对PyCharm等IDE因Python动态类型特性导致的第三方库代码提示缺失问题,本文提供了三种有效解决方案。通过assert isinstance、类型注解或类型注释明确变量类型,可强制IDE进行准确类型推断,从而恢复函数和属性的自动补全功能,提升开发效率。
本文详细介绍如何使用Python的requests和urllib库,结合OS模块爬取今日头条街拍美图。通过解析索引页获取图集链接,再深入详情页提取图片URL,最终实现批量保存本地。代码包含完整注释,适合Python爬虫初学者参考学习。
本文详解Python中urllib模块的自定义Opener构建原理。通过HTTPHandler、ProxyHandler及HTTPCookieProcessor处理器,实现代理IP切换与Cookie持久化。涵盖Debug调试、免费与私密代理选择策略,以及基于CookieJar的模拟登录流程,帮助开发者突破基础urlopen的功能限制。
本文详解Python中利用urllib模块处理URL中文编码与解码的方法。通过urllib.quote进行编码(支持UTF-8和GBK),使用urllib.unquote进行解码,解决URL中特殊字符歧义及非ASCII字符传输问题,并提供完整代码示例。
本文介绍使用Python编写简易爬虫并将抓取的数据保存至本地文件的方法。通过urllib获取网页内容,利用正则表达式提取图片链接,最后将图片保存至指定本地目录。文章基于Python 3.5环境,重点讲解了文件存储的实现细节及正则匹配的注意事项,适合初学者参考。
本文介绍如何使用Python通过16行代码批量下载王者荣耀高清皮肤。教程涵盖获取英雄列表JSON、解析皮肤URL规则、利用urllib.urlretrieve下载及文件管理逻辑,帮助开发者快速掌握基础爬虫技巧。
本文详细解析Python中urllib模块的两个核心方法:urlopen()与urlretrieve()。urlopen用于获取远程URL的类文件对象,支持read、info等方法;urlretrieve则直接将远程数据下载至本地,支持进度回调。文章通过代码示例展示了参数配置、状态码判断及下载进度实现,适用于Python网络编程初学者参考。
本文详细介绍在Python爬虫开发中如何添加请求头,分别通过requests、urllib以及PhantomJS三种方式给出具体代码示例。内容涵盖常见Header字段的配置方法,如User-Agent、Referer等,帮助开发者绕过基础反爬机制。