Python requests设置代理的方法步骤
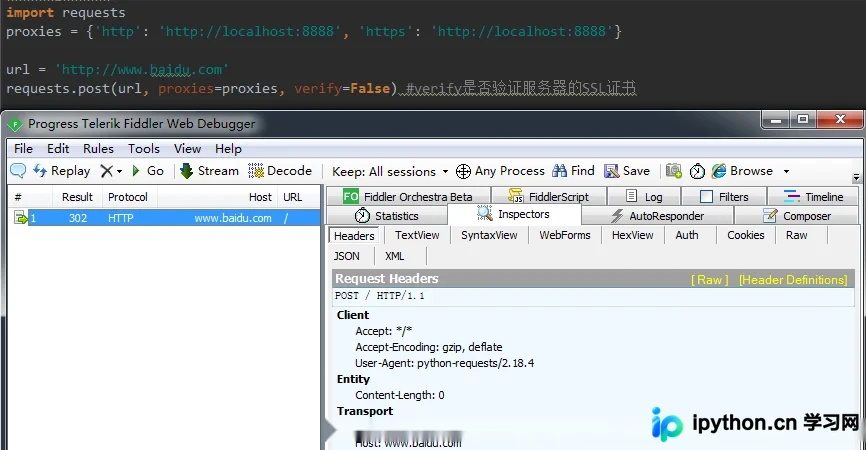
本文详细介绍在Python中使用requests库配置代理的方法,重点解决Python 3.8+版本中常见的ProxySchemeUnknown报错。通过示例展示如何正确拼接代理格式,并补充Selenium浏览器自动化的代理配置方案,帮助开发者顺利实现网络请求的代理转发。
2026-10-11
6

本文详细介绍在Python中使用requests库配置代理的方法,重点解决Python 3.8+版本中常见的ProxySchemeUnknown报错。通过示例展示如何正确拼接代理格式,并补充Selenium浏览器自动化的代理配置方案,帮助开发者顺利实现网络请求的代理转发。
教你使用 Python 的 requests 与 BeautifulSoup 编写第一个网页爬虫,步骤详尽,示例完整。
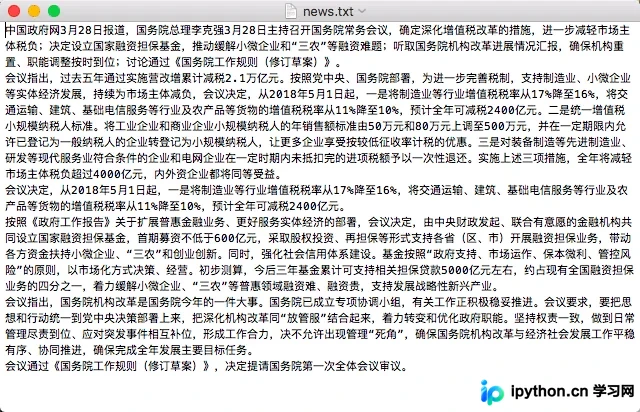
本文介绍如何使用Python的requests和BeautifulSoup库抓取指定网页的正文内容,并利用jieba库对提取的文本进行分词处理。通过具体代码示例,展示了从获取HTML、解析DOM、提取文本到写入文件及分词输出的完整流程,适用于简单的网页内容分析与预处理场景。
Python 使用 requests 库可大幅简化 HTTP 网络请求操作。本文演示如何直接调用模块方法发起 GET 与 POST 请求,利用 Session 对象自动维护 Cookie 与会话状态,并结合 try-except 结构精准捕获超时、断连与 HTTP 错误。掌握这些核心用法,能够快速搭建稳定高效的接口调用流程。
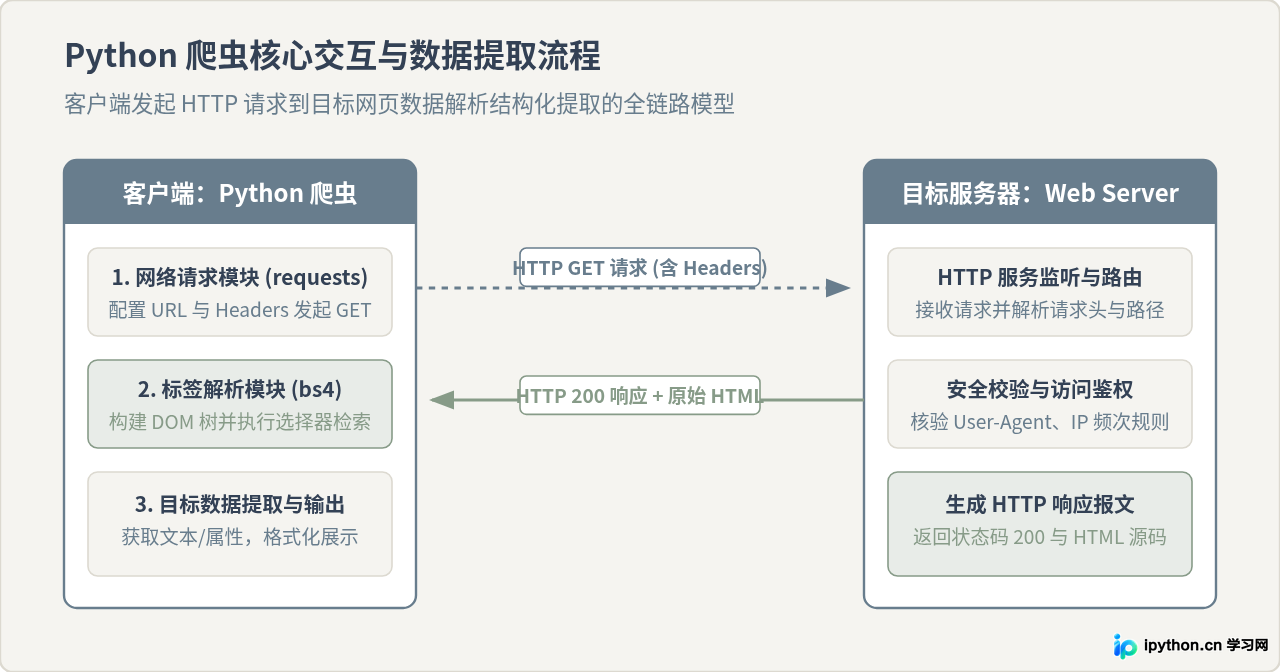
面向新手的Python爬虫入门教程,从Python运行环境检查、虚拟环境与核心依赖库配置入手,系统解析HTTP网络请求与DOM树解析机制,提供完整可运行的代码实现与常见报错排障方案。
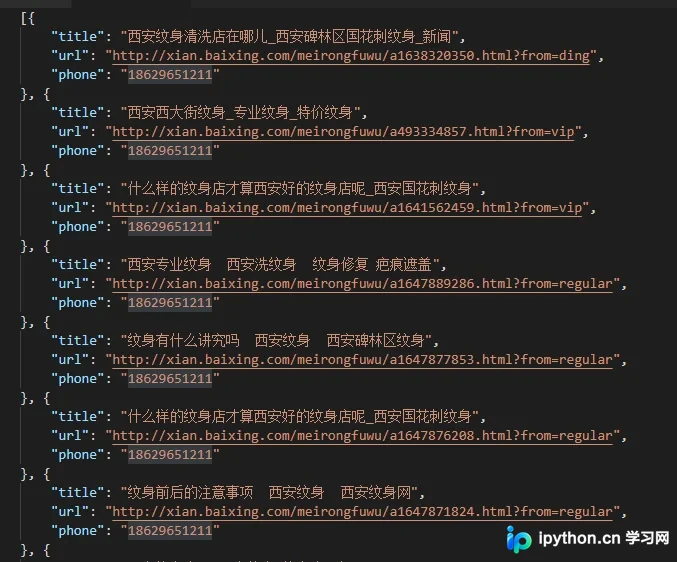
本文介绍如何使用Python3结合requests、lxml和json模块,爬取百姓网列表数据并保存为JSON格式。文章详细讲解了环境准备、代码实现及文件保存步骤,适合初学者参考学习。
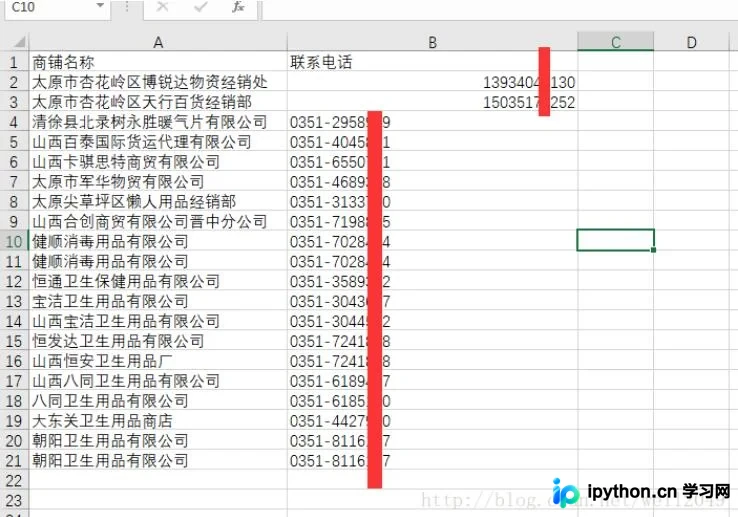
本文介绍如何使用 Python 爬取 114 黄页的商家联系电话及名称。通过 requests 获取页面源码,利用 BeautifulSoup 解析 HTML 结构,提取特定 div 下的列表数据。代码包含翻页逻辑、请求头设置及 CSV 文件写入,适合初学者学习基础爬虫开发。
本文详细介绍如何使用 Python 第三方库 requests 快速发起各类 HTTP 请求。内容涵盖 GET/POST 请求的标准写法、动态参数传递、自定义请求头与 Cookie 设置、Session 会话保持机制以及完善的异常分类处理方案。附带可直接运行的代码示例与调试技巧,帮助开发者高效完成后端接口调试与自动化脚本编写。
本文介绍如何使用 Python 的 requests 库来测试代理 IP 是否生效。通过配置代理字典和请求头,向icanhazip.com发起GET请求,并打印返回的IP地址。若返回的IP与代理IP一致,则说明代理设置成功。
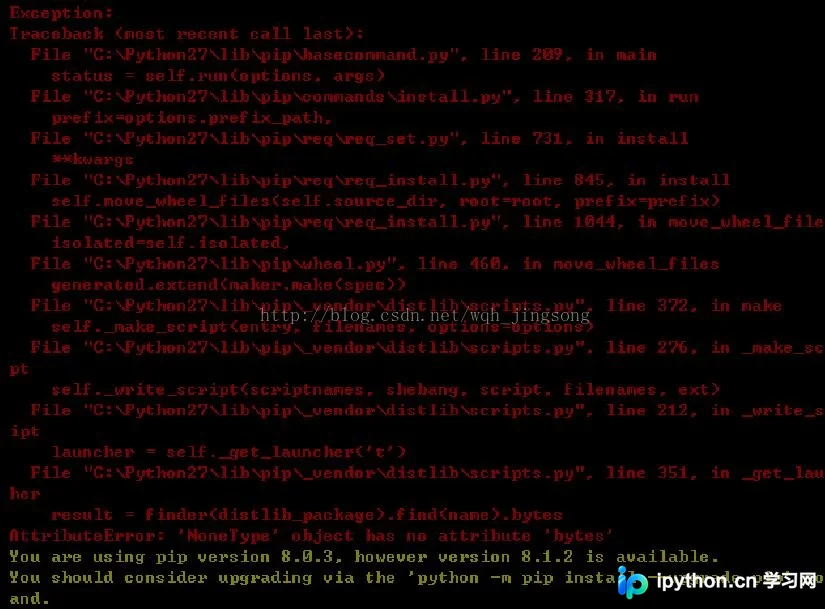
本文介绍在 Python 2.7.10 及以上版本中,如何解决自带 pip 版本滞后导致的下载缓慢问题。通过切换到安装目录并使用 python -m pip 命令升级 pip,以及多次尝试安装 requests 包,确保环境配置成功。
本文详细讲解Python环境下Requests库的部署步骤,系统演示GET与POST请求的标准写法。内容覆盖URL参数自动拼接、JSON响应体一键转换、自定义请求头注入,以及基于超时设置与异常类的稳定容错方案,助您快速搭建可靠的网络通信模块。
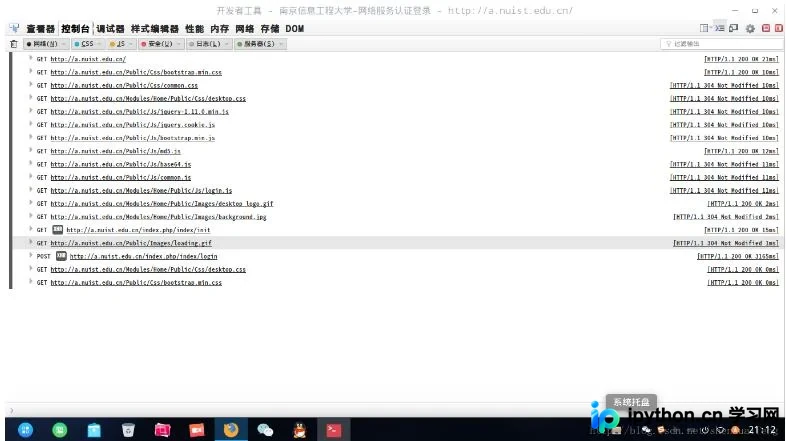
本文详细讲解如何利用Python和requests库实现校园网自动登录。通过Firefox浏览器和Firebug插件监控网络请求,分析POST请求的Header和Body参数。重点解析密码字段的Base64编码过程,并提供完整的Python登录脚本,帮助读者掌握网络请求模拟与数据构造技巧。