构建高效的Python Requests长连接池详解
本文深入解析Python requests库中Session类的长连接机制,指出默认基于host的连接管理在多域名或子域名场景下的性能缺陷。通过自定义HTTPAdapter,结合scheme、主域名、IP及端口构建更精细的连接池键值,有效解决IP轮询和子域名复用问题,显著提升高并发爬虫及分布式系统的网络IO效率。
2026-10-14
5

本文深入解析Python requests库中Session类的长连接机制,指出默认基于host的连接管理在多域名或子域名场景下的性能缺陷。通过自定义HTTPAdapter,结合scheme、主域名、IP及端口构建更精细的连接池键值,有效解决IP轮询和子域名复用问题,显著提升高并发爬虫及分布式系统的网络IO效率。
本文详解Python requests库中POST请求的data与json参数区别。重点说明两者在dict或str类型下,未指定headers时Content-Type的默认值差异:data默认为application/x-www-form-urlencoded或text/plain,json默认为application/json。同时展示request.body内容的格式差异,并提供Django后端接收及Python客户端发送的完整代码示例。
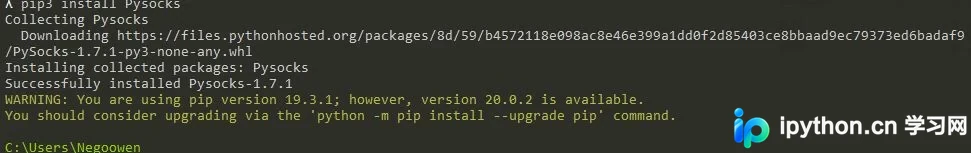
本文介绍如何在 Python 中通过 PySocks 库配置 SOCKS5 全局代理。首先讲解 pip 安装方法,随后通过代码示例展示如何替换默认 socket 以启用代理。最后提供完整的测试脚本,演示在启用代理后访问外部网站(如 Google)的效果,帮助开发者快速实现网络请求的代理转发。
本文详解Python requests模块中Cookie的处理机制。通过Session对象实现请求间Cookie持久化,演示方法级与Session级两种设置方式。重点介绍RequestsCookieJar类在跨域名、跨路径场景下的灵活应用,结合httpbin.org测试案例,提供完整的代码示例与结果分析,帮助开发者掌握HTTP状态保持的最佳实践。
本文详解Python requests库中Session对象的使用。通过创建Session实例,可实现HTTP请求间的状态保持,自动传递Cookie。同时,Session支持配置全局缺省参数(如Headers),并允许在单次请求中覆盖或添加临时参数,从而灵活处理跨请求与独立请求的参数差异。
本文通过五个Python代码实例,详解如何使用requests库进行网络爬虫开发。内容涵盖普通页面爬取、模拟浏览器请求规避限制、搜索引擎关键词抓取、图片保存以及IP地址归属地查询,提供完整代码与参数解析,帮助开发者快速掌握网络数据提取核心技巧。
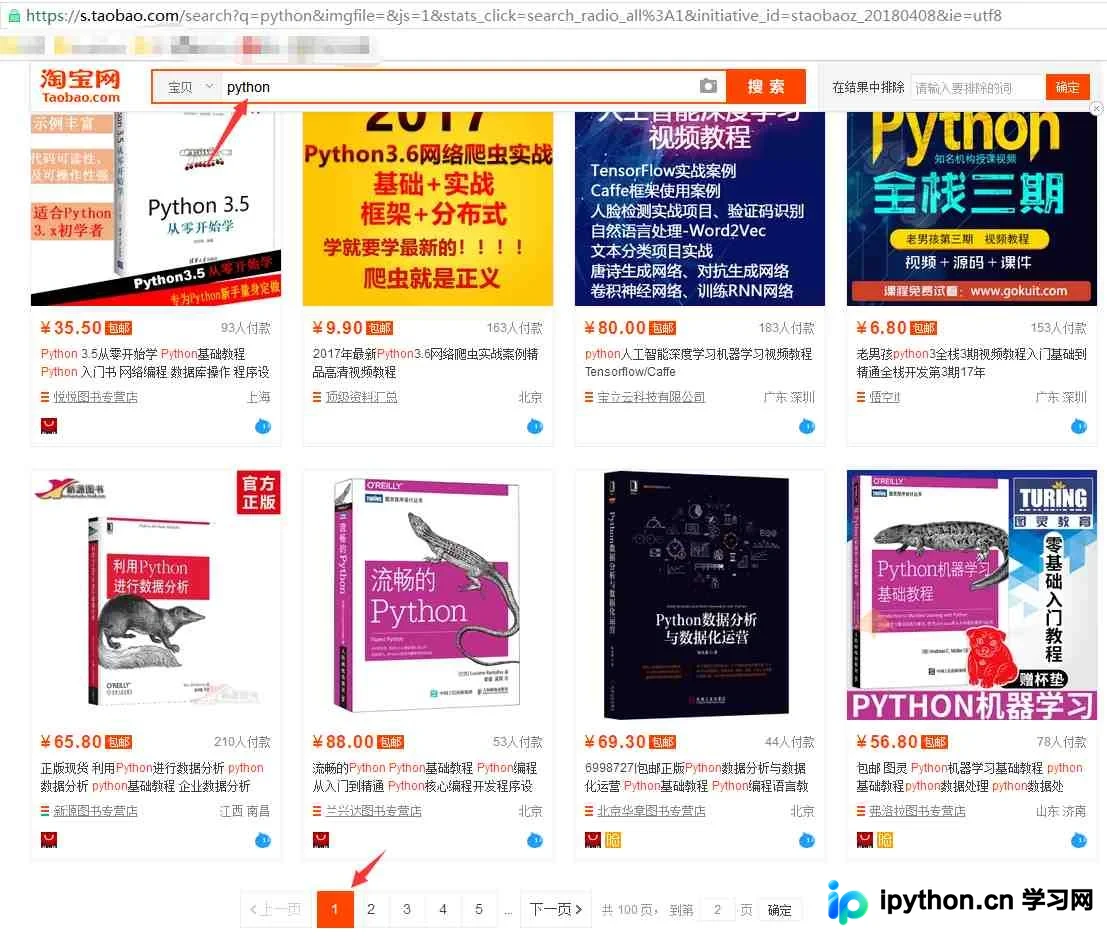
本文详细介绍如何使用Python的requests和re库爬取淘宝商品列表。通过解析URL参数q和s,构建分页请求,利用正则表达式精准提取raw_title和view_price字段。代码示例展示了从获取HTML源码、解析数据到存储结果的完整流程,适合Python初学者学习网络爬虫基础。
本文介绍了使用Python自动访问网页的两种方法。第一种利用requests库结合IP池和User-Agent随机化,模拟浏览器请求以规避简单反爬;第二种通过socket直接构建TCP连接并发送原始HTTP报文,解析响应体保存为HTML文件。代码包含完整实现细节,供开发者参考。
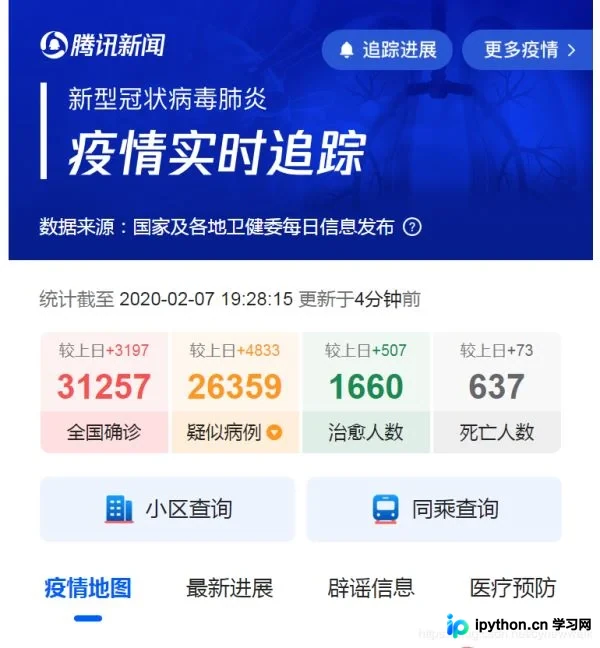
本文提供使用Python爬取疫情数据的完整源码。通过requests库获取接口数据,利用json模块解析嵌套JSON结构,提取全国及各省累计确诊病例等关键指标。代码包含类封装、数据下载与解析逻辑,适合Python初学者参考学习网络爬虫基础及数据抓取技巧。
本文介绍如何使用Python的requests库发送HTTP请求。重点讲解通过data参数传递字典或元组列表来提交表单数据,以及通过json参数直接传递字典或手动序列化JSON字符串的方法,帮助开发者掌握常见的数据提交方式。
本文介绍使用Python3结合xlrd和requests库,从Excel文件中读取URL链接并批量下载音视频文件的完整代码。示例包含文件夹创建、路径拼接及文件写入逻辑,适用于自动化媒体资源抓取场景。
本文详解如何利用Python的requests库模拟GitHub登录流程。通过解析HTTP无状态特性,掌握Cookie与Session的维护机制。重点讲解如何从登录页面提取authenticity_token(CSRF令牌),构造POST表单数据,并发送请求至session接口实现自动登录,最终通过状态码判断登录结果。