

Python Requests库发送含文件参数接口的完整指南
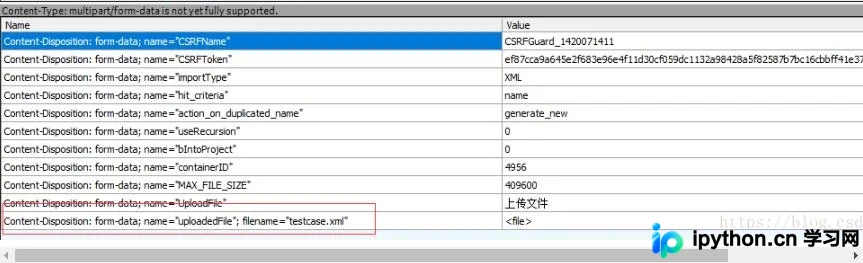
本文详解如何使用Python Requests库调用包含文件参数的接口。针对Fiddler抓包显示的Form-Data结构,说明不能仅用data传参,需将文件参数通过files字典传递。通过对比抓包结果验证请求一致性,确保文件上传逻辑正确。
2026-10-13
6

本文详解如何使用Python Requests库调用包含文件参数的接口。针对Fiddler抓包显示的Form-Data结构,说明不能仅用data传参,需将文件参数通过files字典传递。通过对比抓包结果验证请求一致性,确保文件上传逻辑正确。
本文介绍如何利用Python将浏览器开发者工具中复制的原始Headers字符串转换为标准的字典格式,并进一步序列化为JSON字符串。通过字符串分割与字典生成式技术,自动处理键值对提取及协议头修正,适用于网络爬虫调试与接口开发场景。
本文介绍了如何使用 Python 的 requests 库发送带有自定义 Header 和 Body 的 POST 请求。通过构建完整的 URL、定义请求头信息以及序列化数据体,展示了两种传递 Body 的方式:使用 data 参数配合 json.dumps 或使用 json 参数直接传入字典对象。
本文介绍在Python中使用Requests库获取网站Cookie时遇到的常见陷阱。通过调试发现,某些情况下服务器返回的Cookie可能存在于r.request.headers而非r.headers中。文章分析了请求头中Host和Referer字段对Cookie返回的影响,并推荐通过会话对象自动管理Cookie的最佳实践,帮助开发者解决模拟登录中的Cookie获取问题。
本文详解Python中模拟登录的两种主要方式:直接复制浏览器Cookie与使用Session维持会话。重点解析为何普通请求无法保持登录状态,并通过代码示例展示如何利用requests.Session对象自动管理Cookie,实现跨请求的身份验证与数据获取,解决多页面交互中的会话断开问题。
在使用Python requests库发送POST请求时,若data参数包含嵌套字典,默认form编码会导致数据解析异常。本文指出官方文档仅演示单层字典情况,并提供通过将内层字典转为JSON字符串作为解决方案,确保多层数据结构正确传输。
本文介绍如何在Python中利用requests库模拟浏览器行为发送HTTP请求。通过构造包含User-Agent、Accept等字段的Headers字典,并配置代理服务器,可实现与真实浏览器相似的请求特征。示例展示了GET请求的完整参数设置及状态码获取方式,适用于需要规避基础反爬机制的场景。
本文介绍如何使用Python的requests库高效提交HTTP表单数据。通过实例演示了无Cookie、显式添加Cookie及Session隐式维持Cookie三种场景下的POST请求实现。同时提供利用tcpdump进行网络抓包以辅助脚本调试的实用技巧,帮助开发者快速定位网络交互问题。
本文详细介绍如何使用Python编写爬虫程序抓取新浪新闻。通过安装requests和bs4库,模拟浏览器请求获取原始数据,并解决常见的乱码问题。接着利用浏览器开发者工具定位HTML标签,结合BeautifulSoup解析提取新闻标题、发布时间及链接,最终实现结构化数据的自动采集。
本文详解如何使用Python的requests库发送JSON格式数据。通过修改headers中的Content-Type为application/json,并利用json.dumps()将字典转换为JSON字符串,即可正确发送POST请求,适用于爬虫及接口测试场景。
本文总结了Python接口测试的基础知识,涵盖GET、POST等HTTP请求方法及JSON数据传递方式。通过对比urllib、urllib2与requests模块的使用实例,展示了如何构建API测试类并解析返回的JSON结果,帮助初学者快速掌握接口测试核心技能。
本文详细介绍Python爬虫中处理非200状态URL的重试机制。提供Python 2.7与3.5版本的同步requests实现及异步aiohttp方案,并封装可复用的重试装饰器。代码涵盖错误捕获、递归重试逻辑及异常处理,适用于需要提高爬虫稳定性的场景。