

Python爬虫实战:Requests模块GET请求参数与请求头处理详解
本文详解Python中Requests模块发起GET请求的两种常见场景:携带查询参数与自定义请求头。通过搜狗首页及搜索接口的实战代码,演示如何利用params字典传递URL参数,以及通过headers参数设置User-Agent以模拟浏览器访问,帮助开发者掌握基础爬虫请求构造技巧。
2026-10-13
6

本文详解Python中Requests模块发起GET请求的两种常见场景:携带查询参数与自定义请求头。通过搜狗首页及搜索接口的实战代码,演示如何利用params字典传递URL参数,以及通过headers参数设置User-Agent以模拟浏览器访问,帮助开发者掌握基础爬虫请求构造技巧。
本文介绍如何在Python3中利用requests库下载文件,并在控制台实时显示文件基本信息及下载进度。通过示例代码展示如何获取响应头信息、计算文件大小,并使用线程或迭代内容的方式实现进度条显示,适用于需要监控下载状态的场景。
本文详细介绍如何利用Python的requests模块结合多线程技术,从MySQL数据库中读取图片链接并批量下载至本地。通过封装Spider类、自定义计时器及线程池管理,实现了高效且带有进度统计的图片抓取功能,适用于需要批量处理图像资源的场景。
本文介绍如何使用Python的requests库结合面向对象思想,编写程序批量抓取百度贴吧指定吧前1000页的网页内容。通过封装URL生成、请求发送及HTML保存等方法,实现高效的数据采集流程,适合初学者理解爬虫基础逻辑与代码结构。
本文详细解析如何使用Python的Requests库结合正则表达式,抓取某段子网站的前20页文本数据。文章从抓包分析入手,梳理URL翻页规律,通过对比正则匹配结果优化提取逻辑,最终实现面向对象风格的完整爬虫代码,将内容保存至本地。
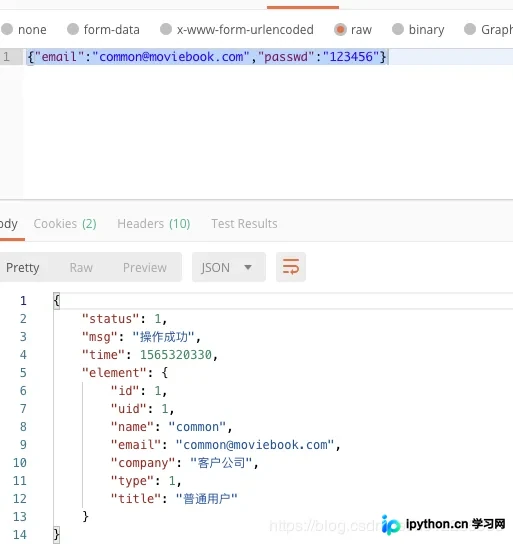
本文介绍如何使用Python的requests库中的session对象模拟用户登录接口。通过设置请求头、发送POST请求并传递JSON数据,实现保持会话状态以获取用户信息、菜单及配置选项。包含完整的代码示例和参数说明,适用于需要维持登录状态的接口调用场景。
本文总结了在Python接口测试中保持登录状态的三种常用方法。第一种为手动注入已获取的Cookie,适用于已知凭证的场景;第二种通过调用登录接口并从响应对象中提取Cookies供后续请求使用;第三种利用requests.Session()实例自动管理Cookie,实现跨请求的状态保持。这三种方式各有适用场景,可根据实际需求选择。
本文详细解析如何使用Python的requests库进行视频文件的流式下载,解决内存占用问题。通过引入contextlib.closing处理上下文管理器缺失,并优化文件写入策略以实时保存数据。最后结合多线程与队列机制,实现高效的多线程并发下载,包含断点判断与进度显示功能。
本文详细介绍Python中通过HTTP协议下载文件的两种常用方法。首先讲解利用requests库的get方法获取内容并写入本地文件,其次介绍使用urllib2模块进行下载的操作流程。文中包含具体的代码示例,适用于需要批量或单独下载网络资源的场景,帮助开发者快速实现文件下载功能。
本文详细介绍如何在Python中使用Requests库配置Socks5代理,以解决网络爬虫中因频繁访问导致的IP封禁问题。通过安装支持socks的requests版本,并正确设置代理地址协议(http/https),可轻松实现代理连接。
本文介绍如何在Python中使用requests库指定出口IP,适用于爬虫多IP轮询场景。通过安装requests_toolbelt模块,利用SourceAddressAdapter类绑定特定IP地址到Session对象,实现HTTP和HTTPS请求的出口IP控制。
本文介绍了在Python中通过指定源端口发起HTTP请求的两种方法。首先,通过继承requests库的HTTPAdapter自定义适配器,实现指定源端口(如54321)的功能,并配合Wiresh抓包验证。其次,演示使用pycurl库设置LOCALPORT参数实现相同效果。文章提供了完整的代码示例及curl命令行测试方法,适用于需要固定出口端口的网络场景。