

Python正则表达式re.group()方法详解与常见错误处理
本文详细解析Python中正则表达式模块re的group()方法。通过实例说明如何利用括号进行分组匹配,解释group()、group(0)与group(n)的区别。重点分析匹配失败返回None导致的AttributeError,以及未定义分组引发的IndexError,帮助开发者避免常见编码错误。
2026-10-16
5

本文详细解析Python中正则表达式模块re的group()方法。通过实例说明如何利用括号进行分组匹配,解释group()、group(0)与group(n)的区别。重点分析匹配失败返回None导致的AttributeError,以及未定义分组引发的IndexError,帮助开发者避免常见编码错误。
本文详解Python中正则表达式的使用,重点介绍re模块的核心函数如search、match、findall、split、sub等。涵盖基础语法符号、原生字符串处理及常见应用场景,帮助开发者快速掌握字符串匹配与处理技巧。
本文系统梳理Python中正则表达式的使用,涵盖re模块的核心方法如compile、match、search、split、findall、sub等,深入解析Pattern与Match对象的属性及用法。重点讲解数量词的贪婪与非贪婪模式、原生字符串处理反斜杠、以及各类匹配标志(flags)的应用,帮助开发者高效处理字符串匹配任务。
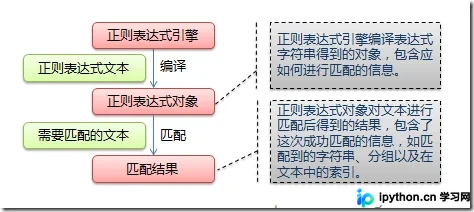
本文深入解析Python中re模块的核心功能,涵盖常用方法如match、search、findall及finditer的区别。详细讲解元字符、多字符匹配规则(贪婪与非贪婪)、分组匹配及边界匹配,并通过代码示例演示数据验证、文本替换与子串提取的实际应用场景。
本文详细解析Python中re模块的正则表达式功能,涵盖数量词、字符匹配、边界匹配及分组等核心元字符。深入讲解findall、match、search和compile等关键方法的差异与使用场景,并通过包含大小写处理、贪婪与非贪婪模式、分组提取及字符串替换的完整代码示例,帮助开发者掌握高效的文本处理技巧。
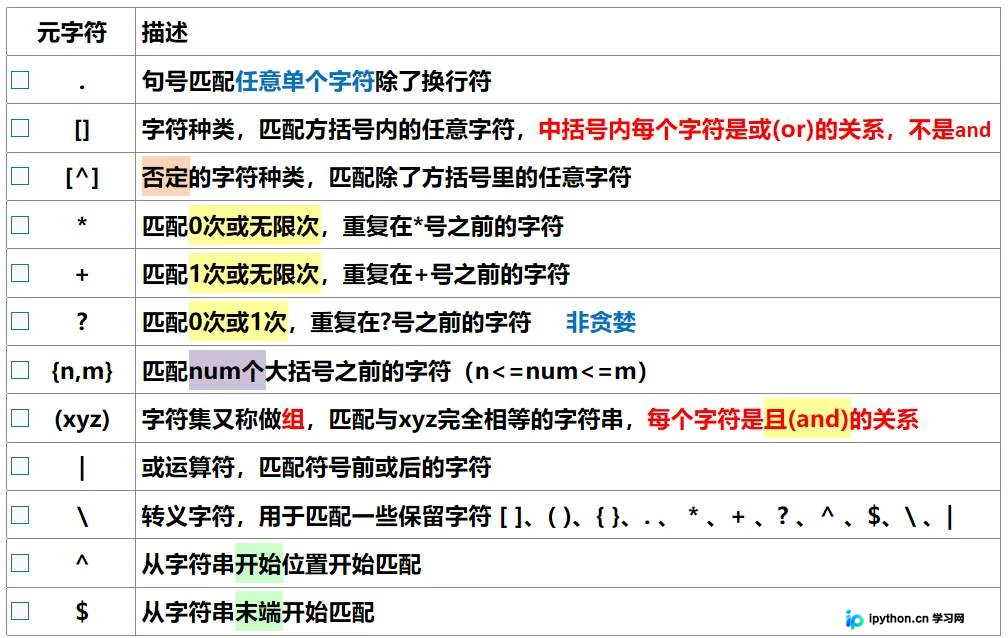
本文深入解析Python中正则表达式的应用,详细介绍re模块的核心函数如compile、match、search、findall及split的用法。通过用户名验证、手机号提取、网页抓取及内容过滤等实际案例,展示如何高效处理字符串匹配与替换,帮助开发者掌握正则表达式在Python中的最佳实践。
本文详细解析Python re模块中贪婪与非贪婪模式的匹配机制。通过对比示例,说明默认贪婪模式尽可能匹配最长字符串,而非贪婪模式通过添加问号“?”实现最少匹配。文章提供具体代码案例,展示如何正确处理数字提取等场景,帮助开发者精准控制正则表达式的匹配行为。
本文详细总结Python3中正则表达式模块re的核心用法。涵盖单字符与数量匹配规则、原始字符串raw在避免转义冲突中的应用、边界匹配技巧,以及分组、分组引用和命名分组的实战案例。通过手机号验证、数字范围匹配及HTML标签提取等示例,帮助开发者掌握正则表达式在爬虫与数据清洗中的关键技能。
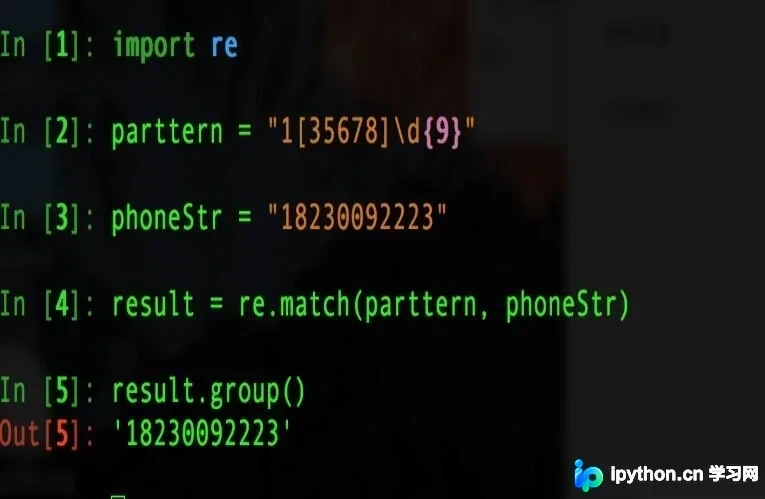
本文深入解析Python中re模块的核心功能,涵盖findall、search、match等查找方法的使用场景与返回值差异,以及split、sub、subn等字符串处理技巧。同时介绍compile编译优化与finditer迭代器节省内存的高级用法,帮助开发者高效处理文本匹配任务。
本文详细解析Python中re模块的六种核心字符串匹配方法。涵盖re.match从头匹配、re.search全局搜索、re.sub替换、compile预编译优化、findall返回列表及finditer返回迭代器的具体用法与区别,结合代码示例说明正则表达式在URL解析等场景中的应用。
本文介绍如何在Python3中利用正则表达式从混合字符串中精准提取中文字符。通过定义包含Unicode范围的匹配模式,并结合re模块的findall方法,实现过滤非中文内容并返回结果数组的功能。
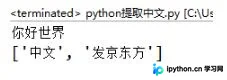
本文介绍在Python3中如何高效提取大段文本内两个指定关键字之间的内容。通过结合使用字符串查找或正则表达式模块re,可以精确捕获目标区间数据。文中提供了基于re.compile和findall方法的完整代码示例,适用于日志分析、数据清洗等场景,帮助开发者快速实现文本内容截取功能。