一篇文章彻底搞懂python正则表达式
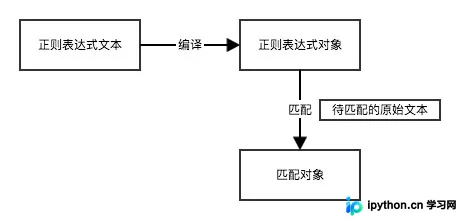
本文系统介绍Python中正则表达式的应用与核心语法。通过解析re模块的编译与匹配机制,详细讲解单字符、多字符及边界匹配规则,并结合findall、sub、split等常用方法,帮助开发者掌握在爬虫及文本处理中高效提取与清洗数据的技术。
2026-10-14
4

本文系统介绍Python中正则表达式的应用与核心语法。通过解析re模块的编译与匹配机制,详细讲解单字符、多字符及边界匹配规则,并结合findall、sub、split等常用方法,帮助开发者掌握在爬虫及文本处理中高效提取与清洗数据的技术。
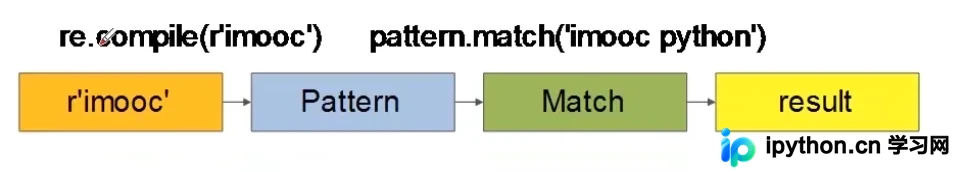
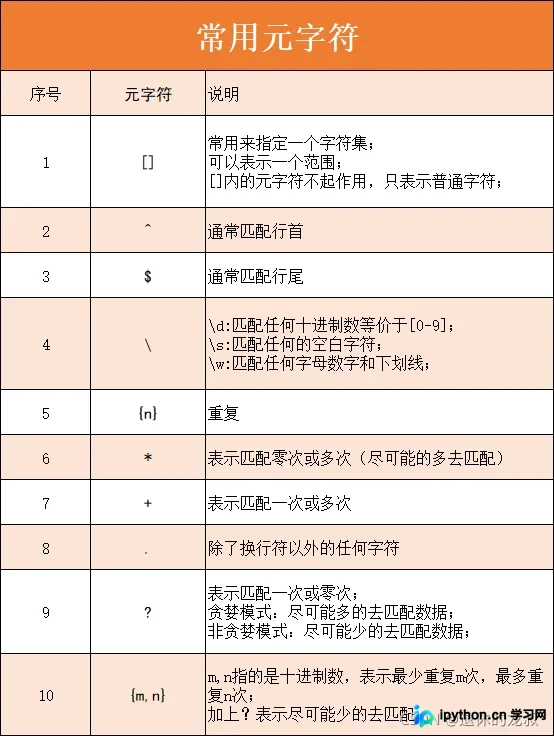
本文深入解析Python中正则表达式的应用,重点介绍re模块的导入与使用。详细讲解findall、search、match等核心函数的语法与区别,并系统梳理常用元字符如[]、^、$、\d、*、+、?等的匹配规则。通过compile编译优化及sub、split等高级操作实例,帮助开发者掌握高效字符串处理技巧。
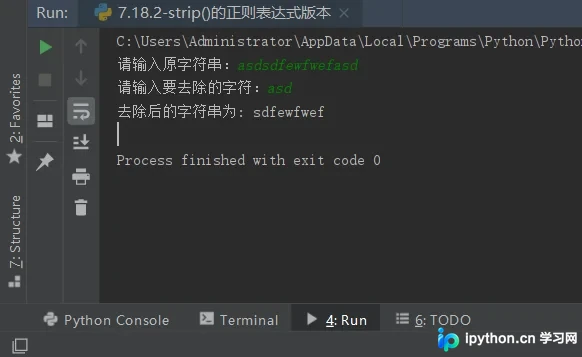
本文详细解析了如何使用Python的正则表达式模块re来模拟内置strip()函数的功能。通过构建包含首尾匹配符^和$的正则模式,结合format方法动态传入待去除字符,实现了灵活的字符串首尾清理。代码演示了如何处理默认空白字符及自定义字符的去除逻辑,为理解正则表达式在字符串操作中的应用提供了具体案例。
本文介绍如何使用Python正则表达式验证IP地址,提供完整的代码示例。通过re模块的compile、finditer及search方法,演示如何提取IP地址及捕获分组信息,适用于网络数据处理场景。
本文深入解析Python中正则表达式的应用,涵盖字符匹配、预定义字符、数量限定及断言等核心语法。重点讲解re模块中compile、match、search、findall、split和sub六大常用方法,结合代码示例演示如何高效进行数据验证与字符串处理,帮助开发者掌握正则表达式在爬虫及数据处理中的实战技巧。
本文详解Python中字符串的基础内置函数与过滤技巧。涵盖UTF-8编码下中文占位、字符串切片截取、split分割返回数组、count/find/index/startswith/endswith检索方法,以及利用re.sub进行关键词过滤的完整用法与代码示例。
本文详细介绍Python中正则表达式模块re的findall函数用法。通过解析参数含义、匹配模式(如re.S)及实际代码示例,展示如何从字符串中提取所有匹配子串并返回列表。涵盖基础调用、标志位使用及常见应用场景,帮助开发者高效实现文本处理与数据抓取。
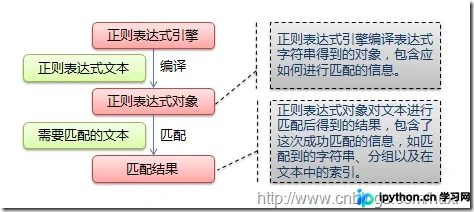
本文系统介绍Python中正则表达式的支持机制,涵盖re模块、Pattern编译对象及Match匹配结果的核心用法。详细解析数量词贪婪与非贪婪模式、反斜杠处理、匹配标志及各类常用方法,帮助开发者掌握字符串匹配与替换技巧。
本文介绍在Python中利用re模块检测URL是否包含IP地址的两种正则表达式写法。通过对比自定义的简练模式与网络常见复杂模式,验证两者均能正确提取IP。代码演示了如何遍历URL列表并输出匹配结果,为需要解析链接内容的场景提供参考。
本文详解如何利用Python内置的re模块进行高效的信息筛选。通过介绍compile、match、search及findall等核心函数,结合正则符号规则,演示了从原始日志中提取特定级别调试信息的完整流程。文章还展示了多级筛选策略及批量处理函数,帮助开发者快速处理大量元数据并提升日志可读性。
本文深入解析Python中re模块findall函数在处理包含括号的正则表达式时的行为差异。重点说明当正则表达式存在多个捕获组时,findall返回的是元组列表而非完整匹配字符串;单括号时返回括号内内容;无括号则返回整体匹配结果。理解这一机制有助于避免数据提取错误。
本文系统讲解Python中正则表达式的核心概念,涵盖原始字符串定义、基础与预设元字符、边界与重复匹配、逻辑分支及分组技巧。重点解析贪婪与非贪婪模式,并结合爬虫场景演示如何利用sub函数与正则表达式进行HTML标签处理与路径替换,帮助开发者高效处理文本提取与验证任务。