

Python xlwings 生成 Excel 图表完整指南与类型参数详解
本文详细介绍如何使用 Python 的 xlwings 库在 Excel 中生成各类图表。涵盖图表创建坐标设置、数据源指定及标题添加方法,并完整列出所有支持的图表类型参数值。通过具体代码示例,演示如何批量生成不同样式的图表,解决官方文档中参数缺失的问题,帮助开发者实现 Excel 自动化报表生成。
2026-10-13
13

本文详细介绍如何使用 Python 的 xlwings 库在 Excel 中生成各类图表。涵盖图表创建坐标设置、数据源指定及标题添加方法,并完整列出所有支持的图表类型参数值。通过具体代码示例,演示如何批量生成不同样式的图表,解决官方文档中参数缺失的问题,帮助开发者实现 Excel 自动化报表生成。
本文详细介绍如何使用Python和OpenCV库截取不规则区域图片。通过cv2.threshold进行二值化处理,利用cv2.findContours提取轮廓,结合cv2.fillPoly填充多边形生成掩膜,最后通过位运算(bitwise_and)实现不规则区域的精准截取。
本文介绍在 Ubuntu 16.04 虚拟机环境中,解决 pip3 默认指向 Python 2.7 的问题。通过手动安装 pip3 并指定 Python 版本,可实现 pip3 正确链接至 Python 3.5。建议避免修改系统自带 Python 环境,以确保系统稳定性。
本文介绍如何利用Python内置的SimpleHTTPServer模块,在无需额外软件的情况下快速实现不同操作系统间的文件夹共享。通过简单的命令行操作,Linux或Windows主机均可将指定目录发布为Web服务,其他设备只需通过浏览器输入IP和端口即可访问文件,操作简单且无需区分主从角色。
本文详细介绍Python中Selenium库的基本使用方法,涵盖从导入包、创建驱动对象到请求页面、获取源码及关闭浏览器的完整流程。重点解析find_element与find_elements的定位语法差异,以及如何通过ID、XPath等方式操作点击、输入和获取数据。此外,还包含Cookie处理、JS执行、窗口切换及弹窗处理等高级技巧,帮助开发者高效进行Web自动化测试。
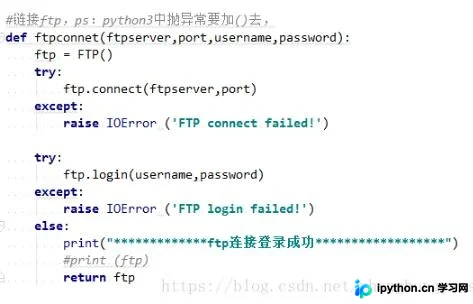
本文详细介绍Python中FTP模块的实际应用,涵盖建立连接、处理异常、批量下载、删除及上传文件的核心步骤。重点解析在循环操作中引入重试机制以避免500网络错误的方法,提供完整的代码逻辑参考,帮助开发者高效完成FTP文件管理任务。
本文详细介绍 Python 使用 pyhs2 库连接 Hive 的方法,重点讲解 Kerberos 环境下的认证配置。内容涵盖系统依赖安装、SASL 错误排查、HiveClient 封装类实现,以及对接 Superset 时 SQLAlchemy URI 和连接参数的具体配置,帮助开发者解决大数据环境下的连接难题。
本文详解如何利用Python标准库中的threading和Queue模块手动构建线程池。通过解析线程池存在的必要性、Queue核心API以及具体的代码实现步骤,帮助开发者掌握高并发场景下的资源管理与任务调度技巧,包含动态停止线程的高级用法。
本文介绍如何在Python中实现多线程的并发启动与顺序执行。通过利用threading模块的join方法,前一个线程阻塞等待后一个线程启动,从而保证执行顺序。示例代码展示了如何创建10个线程,并验证其按0到9的顺序输出结果及时间戳。
本文详细介绍如何使用 Python 连接并消费 Kafka 数据。内容涵盖 kafka-python 模块安装、压缩依赖处理、生产者发送消息示例,以及基于 KafkaConsumer 的消费者实现。重点讲解如何通过多线程机制并行处理不同分区数据,提升消费效率,并提供完整代码参考与官方文档链接。
本文详细介绍Python中lxml模块的安装方法及核心用法。通过etree.HTML将字符串转换为Element对象,利用XPath进行数据提取。文章演示了如何处理不规范HTML、解决属性缺失导致的对应错误,并展示通过节点分组实现更精准的数据抓取技巧,适合Python爬虫开发者参考。
本文介绍如何在 Python 中使用 kafka-python 库实现多线程 Kafka 消费者,并演示如何手动管理 Offset 提交。通过继承 threading.Thread 类创建自定义线程,分别处理不同分区的数据消费。代码展示了如何配置 Broker 列表、指定 Topic 和 Partition,以及在消费循环中手动提交 Offset 以确保消息处理的可靠性。该示例适用于需要高并发处理且对消息顺序或提交时机有特定要求的场景。