

Python使用Requests库获取网页源码的完整指南
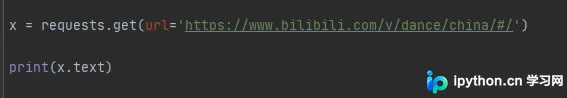
本文详细介绍如何使用Python的requests库查看网页源代码。通过导入requests模块,利用get()函数发送HTTP请求获取指定URL的HTML内容,并设置编码为utf-8后打印输出。文章包含完整代码示例及运行结果分析,适合初学者快速掌握网页数据抓取的基本方法。
2026-10-14
8

本文详细介绍如何使用Python的requests库查看网页源代码。通过导入requests模块,利用get()函数发送HTTP请求获取指定URL的HTML内容,并设置编码为utf-8后打印输出。文章包含完整代码示例及运行结果分析,适合初学者快速掌握网页数据抓取的基本方法。
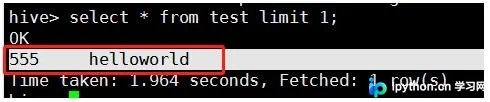
本文介绍如何利用Python脚本将Hive命令行输出转换为标准的Insert语句,解决Hive无法直接导出插入语句的问题。同时详细记录了通过impyla、HDFS及MySQL中转等多种尝试路径中的常见陷阱,重点警示批量插入的性能瓶颈,并提供实用的临时解决方案。
本文介绍如何利用Python将多条SQL语句封装在BEGIN...END块中一次性提交,以减少数据库连接与网络传输开销,显著降低模型运行耗时。针对Oracle数据库唯一约束冲突(ORA-00001)问题,提供了基于字典去重并保留高权重因子的解决方案。同时补充了PostgreSQL中使用%s占位符时必须添加引号的注意事项,旨在提供高效且稳定的数据库交互方案。
本文深入解析Django中HTTP请求的完整生命周期,涵盖FBV(基于函数视图)与CBV(基于类视图)的处理流程。详细阐述URL路由匹配、中间件处理及视图函数执行机制,并介绍Django Form表单系统的核心概念、字段验证、数据清洗及文件上传实现,帮助开发者掌握Django后端开发的关键技术点。
本文详解 Python 中引用包的两种主要方式:直接使用 import 包名导入整个模块,以及利用 from 包名 import 类名/函数名进行精准导入。通过 time 模块示例演示具体代码,并深入解析如何依据 __init__.py 文件的存在来区分普通目录与 Python Package,帮助开发者高效管理依赖与提升代码可读性。
本文介绍Python中输出整数的两种常用方法。第一种通过str()将数字转为字符串并检查是否包含小数点来筛选整数;第二种利用浮点数精度格式化(如%.0f)实现四舍五入输出。文章包含具体代码示例及执行结果分析,帮助开发者根据需求选择合适方案。
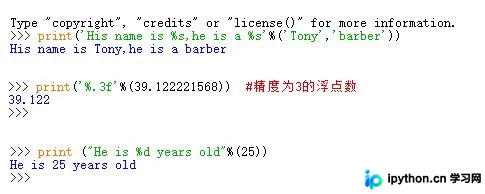
本文详解Python连接MySQL和PostgreSQL数据库时,SQL语句中%s、%d、%f参数的使用规范。重点解析在LIKE查询中处理普通百分号时的转义技巧,通过%%替代%防止格式化错误,确保数据查询准确无误,适用于增删查改操作中的字符串格式化场景。
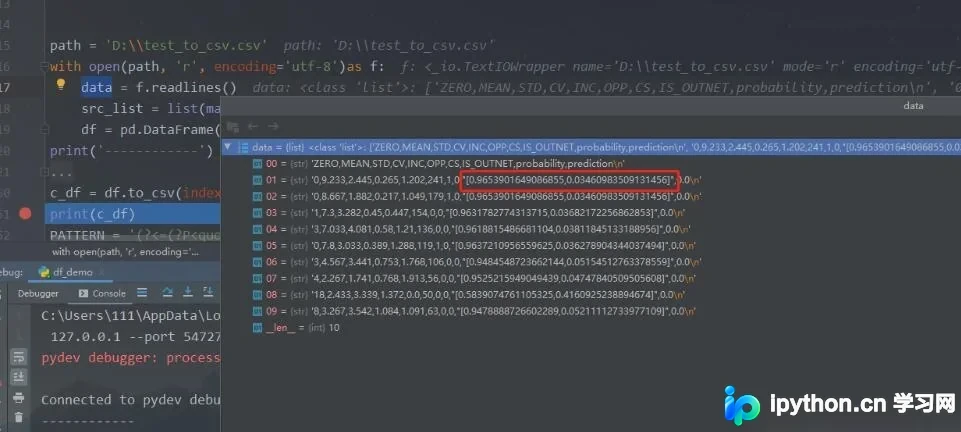
本文介绍如何使用Python的pyhdfs模块连接Hadoop集群,实现HDFS文件的读写与本地文件上传。重点解析在通过Pandas处理包含特殊引号格式的CSV数据时,因正则匹配保留引号导致的转义错误,并提供修正后的正则表达式与处理逻辑,确保数据准确转换。
本文详细介绍如何使用Python的hdfs3模块替代命令行操作HDFS,实现更优雅的编程体验。内容涵盖文件读取与写入的基本用法、多节点高可用环境的配置方法,以及HDFileSystem提供的常用API列表,如文件复制、权限修改和目录遍历等,帮助开发者高效管理Hadoop分布式文件系统。
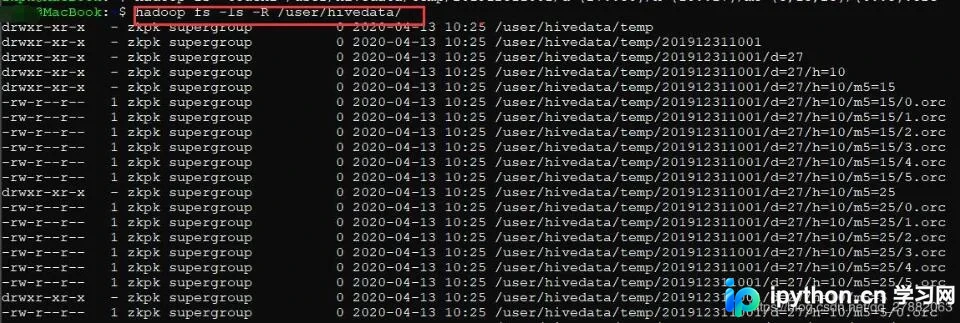
本文介绍Python读取HDFS上Parquet格式数据的多种方案,包括hdfs3、hdfs和pyhdfs库的使用及HA配置。同时提供PySpark中利用coalesce函数合并小文件、优化存储效率的实用代码示例。
本文详细介绍如何在Python环境中连接HDFS,实现文件的读取与写入。通过安装pyhdfs模块,演示了从HDFS读取二进制数据流并转换为CSV,以及利用Pandas将文本文件处理为Dataframe并导出为CSV的具体代码。涵盖Python 3.6与Hadoop 2.9环境下的实际操作步骤,包括本地文件上传至HDFS的方法,为大数据处理提供基础支持。
本文详细介绍如何使用Python通过hdfs库访问HDFS。涵盖pip安装步骤、核心代码示例(如Client初始化、文件下载),并重点解决WebHDFS服务未开启导致的连接失败问题。通过修改hdfs-site.xml启用dfs.webhdfs.enabled属性,并提供curl检测命令,帮助用户快速排查和配置Hadoop环境。