

Python爬虫与反爬虫技术解析:策略、成本与实战博弈
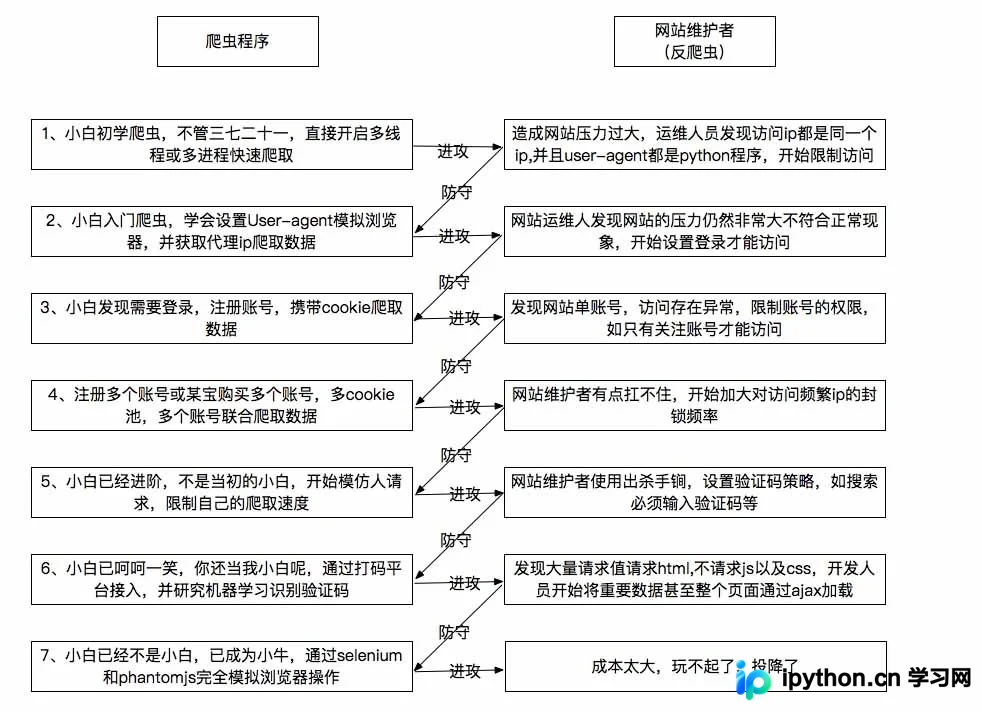
本文深入解析Python爬虫与反爬虫的对抗机制,涵盖自动获取数据原理、常见反爬策略如IP封禁的成本与误伤风险,以及数据保护与商业竞争背景下的防御目的。通过梳理实战中的攻防策略,帮助开发者理解如何在获取数据与防止滥用之间取得平衡,适用于Python及相关技术栈的开发者参考。
2026-10-14
8

本文深入解析Python爬虫与反爬虫的对抗机制,涵盖自动获取数据原理、常见反爬策略如IP封禁的成本与误伤风险,以及数据保护与商业竞争背景下的防御目的。通过梳理实战中的攻防策略,帮助开发者理解如何在获取数据与防止滥用之间取得平衡,适用于Python及相关技术栈的开发者参考。
本文详细介绍Python中进行程序性能测试的多种方法。涵盖使用Unix时间函数进行整体耗时测试,利用cProfile模块生成详细调用报告,以及通过自定义装饰器和上下文管理器针对特定函数或代码块进行精准计时。此外,还解析了timeit模块在微基准测试中的应用及参数配置,并对比了perf_counter与process_time的区别,帮助开发者选择合适的工具优化代码性能。
本文详解Python中正则表达式的贪婪匹配机制及其导致的错误结果,通过引入问号修饰符将模式转换为非贪婪模式,从而精确获取分隔符间的最短文本。文章提供具体代码示例与原理分析,帮助开发者避免常见匹配陷阱,提升正则处理的准确性。
本文介绍Python中如何使用imp.reload()重新加载已导入的模块,适用于开发调试阶段。重点解析reload()通过刷新模块字典更新代码的行为,并指出其无法更新“from module import name”形式导入的变量这一关键缺陷。建议在交互环境中谨慎使用,生产环境应避免依赖此机制。
本文介绍如何在 Python 分布式系统中利用 hmac 模块实现轻量级的客户端连接认证。通过服务器发送随机字节、双方计算 HMAC 摘要并使用 compare_digest 进行恒定时间比较,可有效防止时间分析攻击。方案适用于内部进程间通信,但需注意认证不等于加密,后续通信仍为明文。
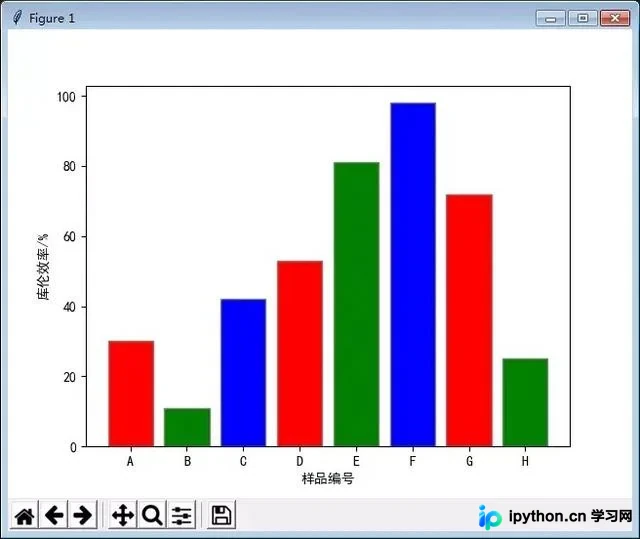
本文详解Python中Matplotlib库绘制各类柱状图的方法。涵盖普通垂直与水平柱图、堆积柱图以及带误差棒的并列与堆积柱图。通过具体代码示例,解析plt.bar、plt.barh及bottom参数的使用,帮助读者快速掌握不同场景下的图表绘制技巧。
本文介绍如何利用Python标准库中的abc模块定义抽象基类(ABC)和接口。通过示例演示如何强制子类实现特定方法,包括直接继承、注册方式以及注解静态和类方法。同时探讨了在动态语言中合理使用类型检查的注意事项,并列举了collections等内置模块的应用场景。
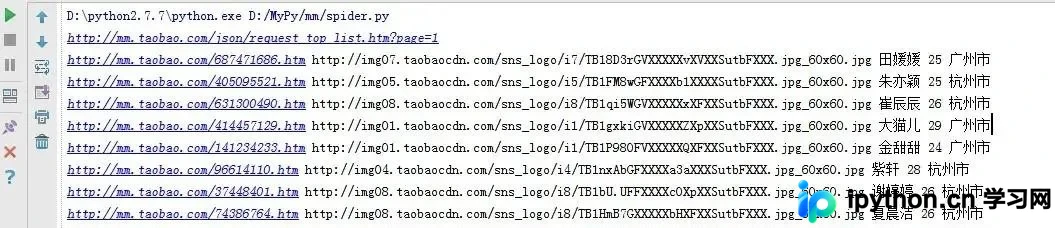
本文详解使用Python编写爬虫抓取淘宝MM首页信息的完整流程。通过解析HTML获取头像、姓名、年龄及详情页链接,利用正则表达式提取数据,并演示如何将图片与个人简介按文件夹保存至本地。代码涵盖页面请求、数据提取、文件创建及写入逻辑,适合Python初学者学习网络爬虫基础操作。
本文详细解析使用Python编写网络爬虫的基础流程。通过介绍HTTP协议的基本工作原理,演示如何利用requests模块发起GET请求并处理响应头。随后,结合BeautifulSoup库的find与find_all方法,展示如何从HTML文档中精准提取目标标签信息,帮助初学者快速掌握爬虫核心技能。
本文详解 Python Selenium 中键盘与鼠标的高级操作。通过 Keys 类模拟 Ctrl+A/V 等组合键及删除、清空输入框;利用 ActionChains 类实现右击、双击、拖动及元素悬停。结合具体代码示例,展示如何在 Web 测试中精准控制浏览器交互,提升自动化脚本的实用性与完整性。
本文解析了Python中基于multiprocessing模块的远程过程调用(RPC)实现机制。通过RPCHandler与RPCProxy类,客户端将函数名及参数序列化后通过网络发送,服务器端反序列化并执行对应注册函数,最后将结果或异常序列化返回。代码示例展示了服务端监听与客户端代理的核心逻辑,适用于理解分布式通信基础。
本文介绍如何在 Python 中构建一个灵活的计时器类。通过封装 time 模块,利用 contextlib 协议实现 with 语句支持,并提供 start、stop 和 reset 方法。文章对比了 time.time、time.clock 与 time.perf_counter 的精度差异,并演示了如何使用 time.process_time 仅统计 CPU 时间,帮助开发者准确评估代码执行耗时。