

Python爬虫中Requests设置Headers请求头的方法与反爬策略
本文详解Python爬虫中Requests库设置Headers请求头的技巧。针对网页反爬限制,通过抓取浏览器真实请求头并模拟User-Agent等关键信息,有效绕过禁止爬取提示。文章提供从获取Headers到代码实现的完整步骤,帮助开发者解决爬虫访问被拒问题。
2026-10-14
9

本文详解Python爬虫中Requests库设置Headers请求头的技巧。针对网页反爬限制,通过抓取浏览器真实请求头并模拟User-Agent等关键信息,有效绕过禁止爬取提示。文章提供从获取Headers到代码实现的完整步骤,帮助开发者解决爬虫访问被拒问题。
本文介绍如何使用Python 3.6环境,通过读取两个TXT文件的行数据,提取每行第一个元素并按行合并生成新文件。提供完整Python代码示例及操作前后文件对比,帮助开发者快速掌握文本处理技巧。
本文详细介绍在Python中获取命令行输入的两种主要方式:通过sys.argv直接获取参数列表,以及使用getopt模块解析带有短选项和长选项的复杂参数。文章包含具体代码示例、测试数据及执行结果,并指出getopt在处理未定义参数时的潜在限制,帮助开发者根据需求选择合适的方法。
本文详解Python扩展插件的下载与安装流程,重点解决Python 3.5.1环境下HTMLParser模块引发的ImportError错误。内容涵盖pip工具升级、管理员权限操作、默认路径查看及源码修改技巧,帮助开发者快速修复模块导入失败问题。
本文介绍如何使用Python实现基于百度语音开放平台的语音识别及图灵机器人对话功能。系统通过检测环境音量触发录音,将音频上传至百度API获取识别文本,并调用图灵接口生成回复。代码涵盖音频采集、Token获取、语音合成及播放模块,适用于树莓派等嵌入式设备或桌面端开发,提供完整的交互逻辑与实现细节。
本文详细解析Intersection over Union(IoU)在目标检测中的核心作用,并提供基于Python和NumPy的完整代码实现。内容涵盖矩形重叠面积计算逻辑、边界框处理及在车位占用检测中的实际应用场景,帮助开发者快速掌握IoU算法原理与工程落地方法。
针对国内网络环境下pip安装第三方库速度慢、易失败的问题,本文介绍了一种通过指定豆瓣PyPI镜像源来加速Python包安装的方法。通过命令行添加-i参数指向https://pypi.douban.com/simple/,可显著提升下载速度,例如19.2M的jieba库可在20秒内完成安装。该方法简单有效,适用于Windows及各类操作系统环境,是优化Python开发体验的实用技巧。
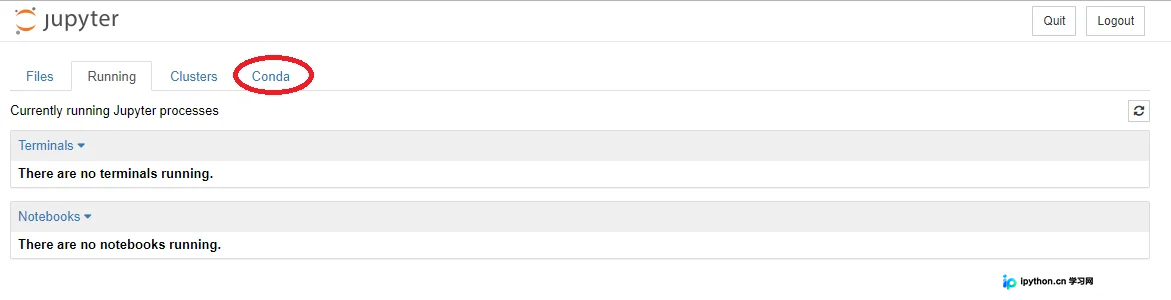
本文详细介绍如何在 Jupyter Notebook 中通过安装 nb_conda 插件来切换 Python 虚拟环境。涵盖从插件安装、虚拟环境中配置 Jupyter 到最终实现环境秒级切换的完整步骤,帮助用户解决默认使用 root 环境的问题,提升多环境开发效率。
本文介绍两种Python实现自动截图的方法。首先利用PIL库的ImageGrab模块结合time模块,实现指定间隔自动截取屏幕并保存为PNG文件,包含自动创建目录的逻辑。其次展示使用OpenCV和threading模块,通过定时器实现摄像头画面每隔一秒自动截图保存,适合本地部署与AI数据采集场景。
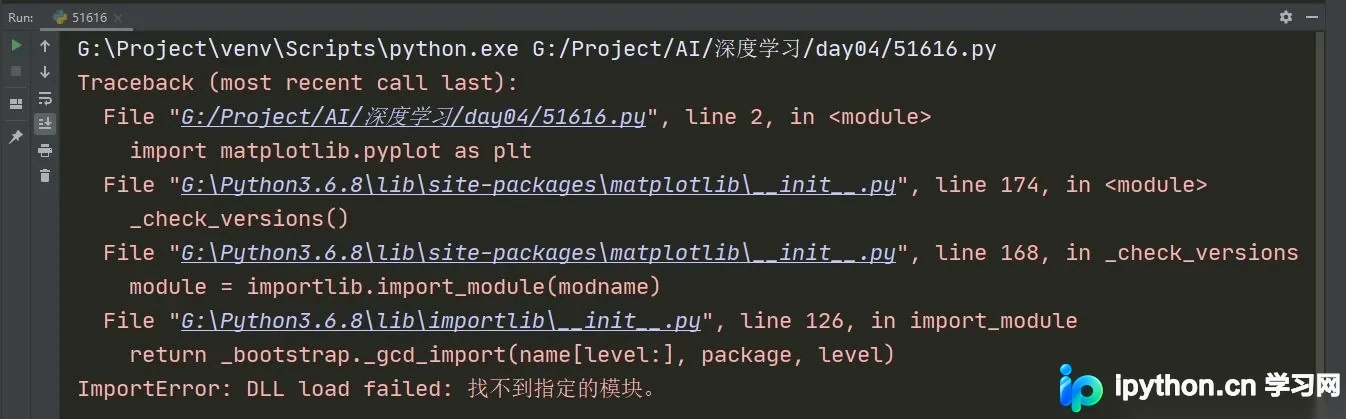
本文针对Windows环境下Python 3.6.8版本在导入matplotlib时遇到的DLL加载失败错误,提供了一套完整的排查与解决方案。重点介绍了通过Chris Gohlke的非官方库下载带有MKL支持的numpy离线安装包,以解决在线pip安装缺失DLL的问题,帮助开发者快速修复依赖库版本不匹配导致的模块导入错误。
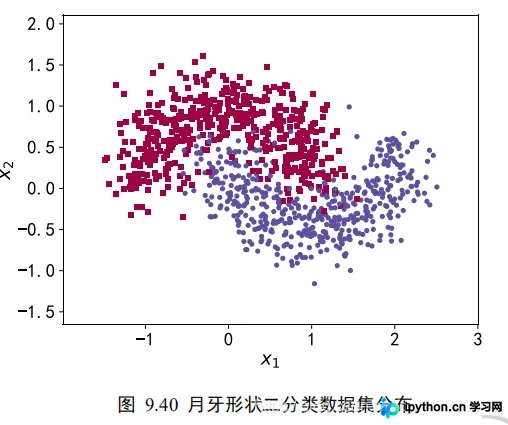
本文通过TensorFlow实战演示如何识别并解决过拟合问题。实验对比了不同网络层数、Dropout层数量及L2正则化系数对模型决策边界的影响。通过月牙数据集可视化,直观展示增加网络容量易导致过拟合,而合理引入Dropout和L2正则化能有效平滑决策边界,提升模型泛化能力。
本文通过10个Python爬虫实例,详解requests库的get、post、put方法及其传参技巧。内容涵盖环境安装、响应对象处理、编码设置、文件保存及图片抓取,并演示如何通过修改User-Agent绕过知乎的反爬机制,适合初学者快速掌握网络数据采集基础。