

Python Selenium XPath 根据文本内容查找元素的实战指南
本文详解在Python Selenium中如何利用XPath根据元素文本内容精准定位元素。针对无固定ID或Class的场景,深入解析text()精确匹配与contains()模糊匹配两种核心方法,并附带完整代码示例,帮助开发者解决动态页面元素查找难题。
2026-10-14
7

本文详解在Python Selenium中如何利用XPath根据元素文本内容精准定位元素。针对无固定ID或Class的场景,深入解析text()精确匹配与contains()模糊匹配两种核心方法,并附带完整代码示例,帮助开发者解决动态页面元素查找难题。
本文详解在Python爬虫中获取指定class样式的div标签的三种方法。对比字符串查找与正则表达式的局限性,重点介绍BeautifulSoup库的使用技巧。通过字典形式赋值attrs参数解决官方文档示例无效的问题,并提供完整代码示例及图片下载实战,帮助开发者高效准确提取网页数据。
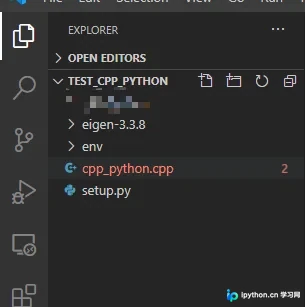
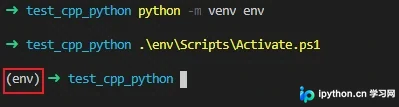
本文详解如何在 Python3 环境中利用 pybind11 调用 C++ 的 Eigen 库以解决循环计算性能瓶颈。内容涵盖从虚拟环境配置、依赖库安装到 C++ 代码编写、Python 接口定义及编译测试的全流程步骤,提供具体的代码示例与操作命令,帮助开发者实现高效的矩阵运算加速。
本文介绍如何使用Python结合xlwings库实现Excel表格的自动查重功能。通过读取指定列数据并比对,程序可自动高亮标记重复行,解决人工核对效率低的问题。此外,文章详细讲解了利用PyInstaller将Python脚本打包为独立EXE可执行文件的方法,方便无Python环境的办公电脑直接使用,提升数据处理效率。
本文介绍当Selenium的.text方法无法直接获取Script标签内的JSON数据时,如何结合BeautifulSoup提取源码,并通过json模块将字符串转换为字典对象,从而精准获取嵌套数据。
本文详细介绍如何在Windows环境下,利用pybind11将C++的Eigen库集成到Python项目中,以解决Python循环计算性能瓶颈。内容涵盖从环境准备、虚拟环境配置、依赖库安装到C++代码编写、Python接口定义及最终编译测试的完整步骤,帮助开发者实现高效的矩阵运算加速。
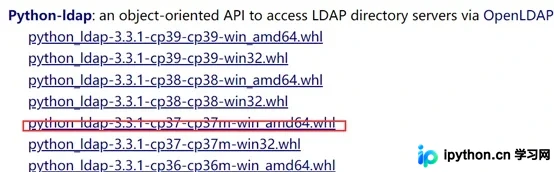
本文介绍如何在Django项目中集成LDAP实现统一用户登录验证,解决多平台账号管理难题。重点讲解Windows环境下Python-ldap库的安装避坑指南,以及settings.py中AUTHENTICATION_BACKENDS和LDAP连接参数的具体配置方法,帮助开发者快速实现基于LDAP的后端验证。
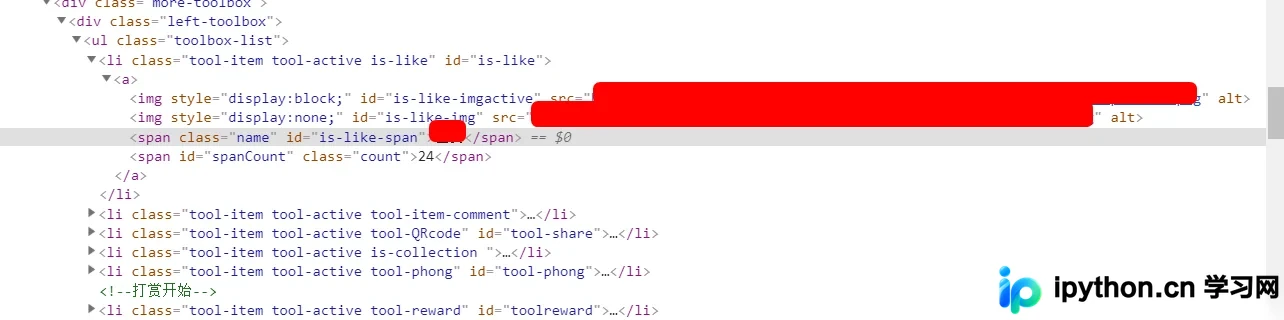
本文介绍如何在Python中使用BeautifulSoup库,通过指定标签名和ID属性来精准定位HTML页面中的特定元素。以span标签下id为is-like-span为例,展示find方法的用法,并说明如何调用get_text()提取其中的字符串内容,帮助开发者快速掌握DOM元素获取技巧。
本文详细介绍Python中二分查找法的实现原理,包括非递归与递归两种编码方式。文章指出二分查找适用于有序且无重复元素的顺序存储结构,时间复杂度为O(log2n),并通过具体代码演示了算法逻辑。
本文详细介绍Python中集合添加元素的两种主要方式:add和update。add方法将传入对象视为整体添加,适用于单个元素;update方法则迭代传入对象并去重,适合批量添加。通过具体代码示例解析两者在行为上的关键差异,帮助开发者根据需求选择合适的方法。
本文详细介绍如何使用Python语言求解一元二次方程。通过导入math模块计算判别式,判断根的情况并输出结果。文章提供完整代码示例,涵盖从系数输入到结果输出的全过程,帮助开发者掌握基础数学运算在编程中的实际应用。
本文详细讲解在Python中判断数字是否为质数的方法。首先阐述质数定义,随后通过两种代码实例展示实现逻辑:一是封装判断函数isprime,二是编写交互式脚本检测用户输入。内容涵盖代码逻辑、执行流程及典型运行结果,帮助开发者理解基础算法实现。