Python OpenCV高斯金字塔与拉普拉斯金字塔的实现
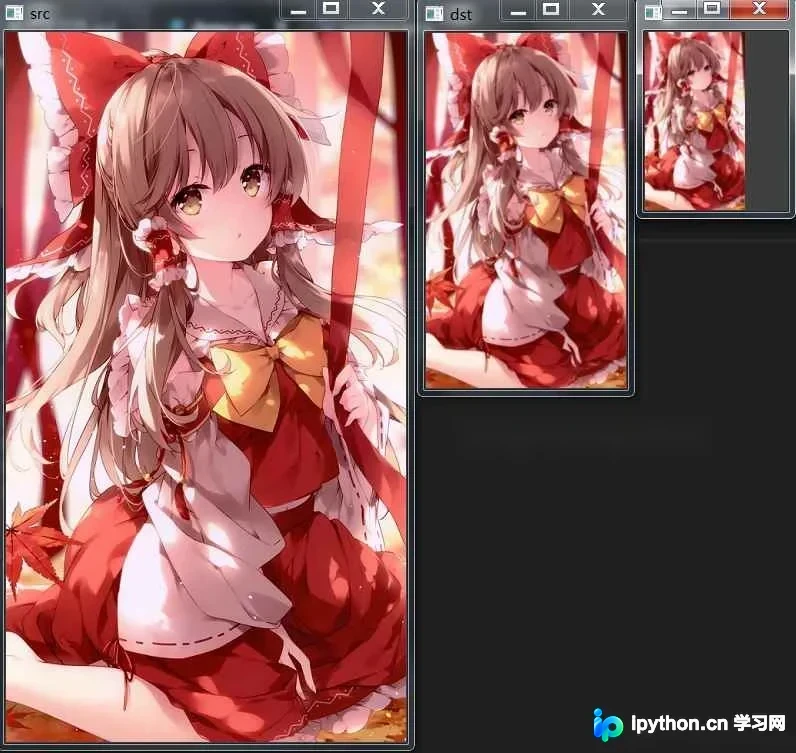
本文详解Python OpenCV中高斯金字塔与拉普拉斯金字塔的实现原理。通过cv2.pyrDown和cv2.pyrUp函数演示图像的下采样与上采样过程,分析尺寸需为2的整次幂的限制。重点介绍利用拉普拉斯金字塔进行图像细节还原的方法,解决常规上下采样的有损模糊问题,并附带完整代码示例。
2026-10-14
7

本文详解Python OpenCV中高斯金字塔与拉普拉斯金字塔的实现原理。通过cv2.pyrDown和cv2.pyrUp函数演示图像的下采样与上采样过程,分析尺寸需为2的整次幂的限制。重点介绍利用拉普拉斯金字塔进行图像细节还原的方法,解决常规上下采样的有损模糊问题,并附带完整代码示例。
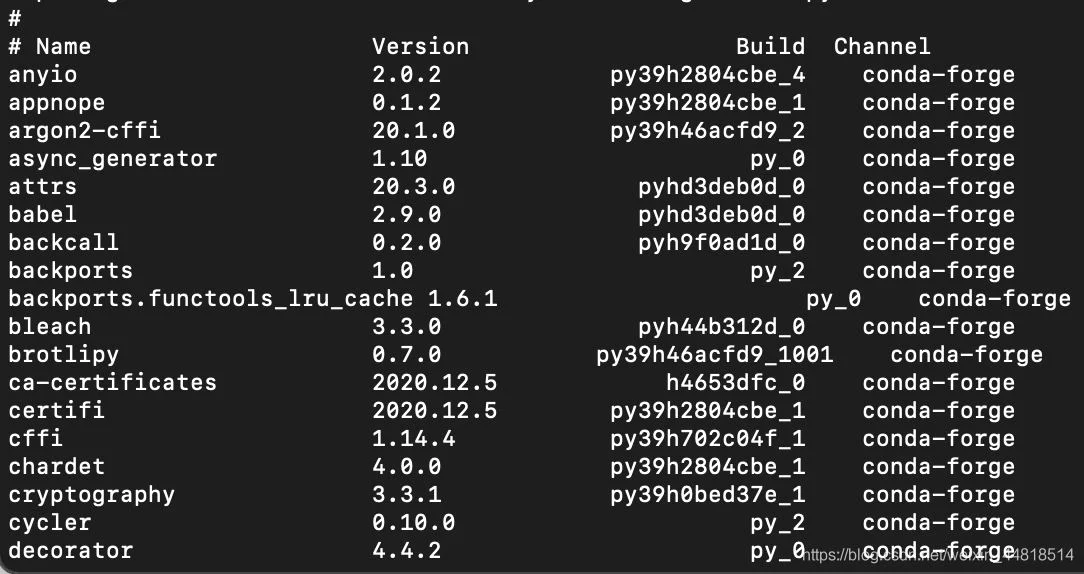
本文详细介绍在 MacBook M1 芯片设备上配置 Python 开发环境的完整流程。通过下载适配 ARM64 架构的 Miniforge 安装包,利用终端命令完成基础环境部署,并演示如何创建、激活及管理 Conda 虚拟环境。内容涵盖常用命令行操作及 Jupyter 等工具的安装方法,帮助开发者快速搭建稳定的本地开发环境。
本文介绍如何使用Python列表推导式通过一行代码完成数组的初始化,涵盖基础偏移与线性变换场景。同时补充了在For循环执行过程中,将每次获取的数据逐步存储到数组中的标准操作方法,帮助开发者高效处理数据收集任务。
本文详解Python中私有属性和私有方法的实现机制。通过双下划线__前缀,Python将属性或方法名进行名称改写,从而实现对外部访问的限制。文章介绍了私有成员在类内部的可访问性、对子类不可继承的特性,并通过具体代码案例演示了如何安全地封装数据及调用内部逻辑,帮助开发者更好地利用封装特性提升代码安全性。
本文介绍如何使用Python编写小程序,将学术文献的BibTeX格式自动转换为标准的IEEE引用格式。通过解析百度学术或谷歌学术导出的BibTeX数据,程序可处理会议论文与期刊论文,支持自动提取作者、标题、会议/期刊名、卷期号及页码等信息,并生成符合IEEE规范的引用字符串,有效避免手动排版错误。
本文详解Python OpenCV中基于图像边缘提取的轮廓发现技术。通过阈值分割与边缘检测提取目标,利用cv2.findContours函数获取轮廓点集及层次结构,并介绍RETR_EXTERNAL等检索模式及CHAIN_APPROX_SIMPLE等逼近方法。最后通过cv2.drawContours实现轮廓可视化绘制,附带完整测试代码与运行结果分析。
本文详细解析Python中合并列表的八种常见方法,包括使用加号、itertools.chain、解包操作符、extend方法、列表推导式、heapq.merge、魔法方法__add__结合reduce以及yield from生成器。文章强调在团队协作中,代码简洁性与可读性优于炫技,建议根据具体场景(如是否需要排序、性能要求等)选择最合适的合并策略,并指出理解多种写法有助于阅读他人代码。
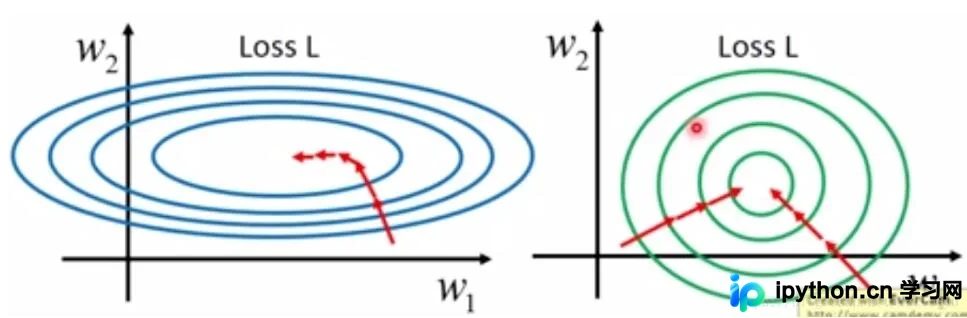
本文详解Python中常用的数据标准化方法,包括[0,1]最大最小归一化与Z-Score标准化。通过公式推导与代码实现,分析两者在加速梯度下降、防止梯度爆炸及处理异常值方面的差异,并明确树模型与距离模型对标准化的不同需求,帮助开发者选择合适的数据预处理策略。
本文详细介绍Python标准库shutil模块的核心功能,包括使用make_archive创建归档文件、通过unpack_archive解压归档包,以及执行快速文件复制、压缩和目录递归复制操作。文章结合具体代码示例,解析各函数的参数用法与路径处理,帮助开发者掌握高效的文件管理技巧。
本文介绍如何使用Python通过B站开放API获取用户粉丝数。提供基础查询与带异常处理、定时轮询的监控脚本示例,涵盖requests库安装、UID配置及数据解析步骤,帮助开发者实现粉丝数量变化的自动检测。
本文详细介绍如何利用Python实现基于空间相似度的K-means轨迹聚类。核心内容涵盖从Excel批量读取含经纬度、速度及方向的轨迹数据,定义并计算基于双向Hausdorff距离的多因素欧氏距离矩阵。通过融合空间、速度与方向权重生成综合距离,并采用非随机策略初始化聚类中心以优化结果。最后结合手肘法与SSE确定最佳聚类数,完成轨迹的高效分类与可视化分析。
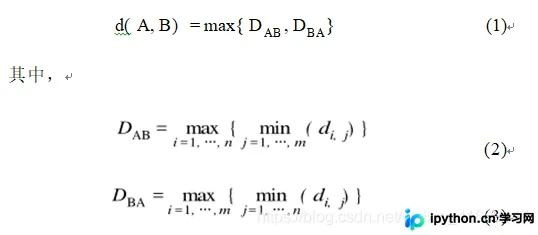
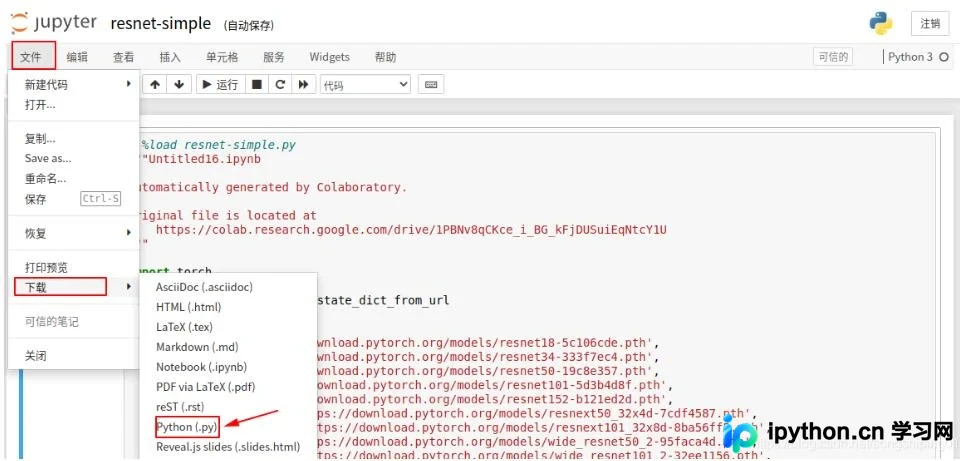
本文介绍在Jupyter Notebook中将.ipynb文件转换为标准.py脚本,以及将.py文件加载为.ipynb格式的方法。通过命令行工具nbconvert或Notebook内置的%load魔法命令,可实现两种格式的高效互转,便于代码复用与协作。