pandas实现分组聚合:将多列合并为列表或字典的方法
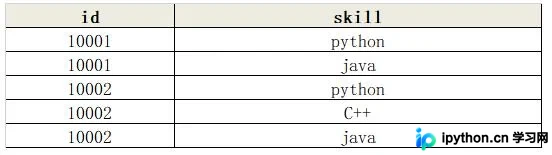
本文介绍在pandas中如何利用groupby对数据进行分组,并将其他列的值合并为列表或字典。通过apply结合list或lambda表达式,可实现单列或多列的聚合处理。同时补充字符串字段的拼接方法及常见字符串处理函数,帮助高效完成数据清洗与转换任务。
2026-10-14
7

本文介绍在pandas中如何利用groupby对数据进行分组,并将其他列的值合并为列表或字典。通过apply结合list或lambda表达式,可实现单列或多列的聚合处理。同时补充字符串字段的拼接方法及常见字符串处理函数,帮助高效完成数据清洗与转换任务。
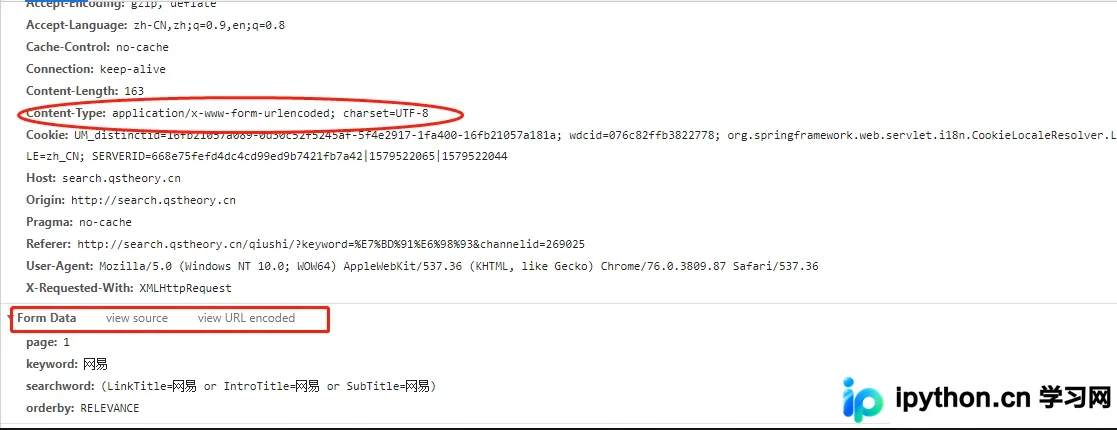
本文深入解析Python requests库中Post请求的两种主要参数形式:Form Data与Request Payload。通过Chrome开发者工具示例,详细对比了application/x-www-form-urlencoded与application/json两种Content-Type下的数据提交方式,并提供了对应的requests.get与requests.post代码实现,帮助开发者解决因参数格式错误导致的数据获取失败问题。
本文介绍如何使用Python pandas库进行分组排序并获取组内第二大或最大的数据。通过groupby结合apply函数,可自定义逻辑提取特定排名数值;对于按列排序后取最大行的需求,可利用sort_values配合groupby的first或head方法实现高效数据筛选。
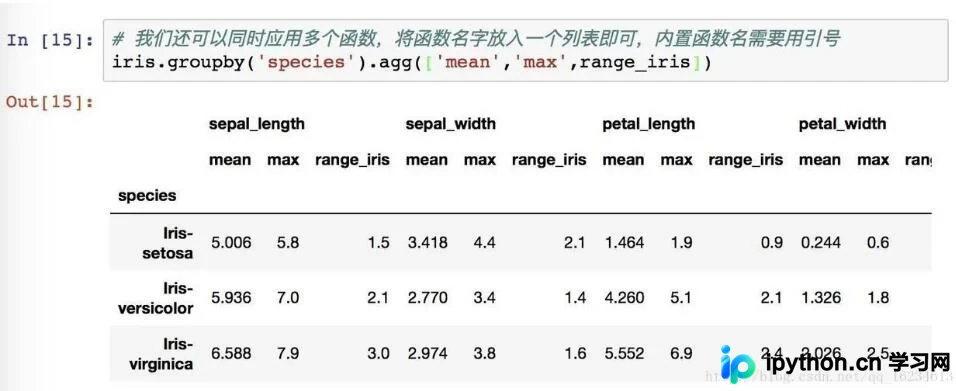
本文详细解析Pandas中groupby后的agg、apply和transform三个方法的核心区别。agg针对单列返回标量,apply接收整个DataFrame并支持复杂逻辑,transform则保持原索引进行广播。通过具体代码实例说明如何在不同场景下选择合适的方法,并解决groupby索引冗余等常见问题。
本文介绍如何使用pandas的concat函数在纵向拼接多个DataFrame时忽略原有索引。通过设置ignore_index=True参数,可生成连续的新索引,避免NaN值。同时涵盖横向拼接的axis=1用法,帮助处理不同列名的数据合并问题。
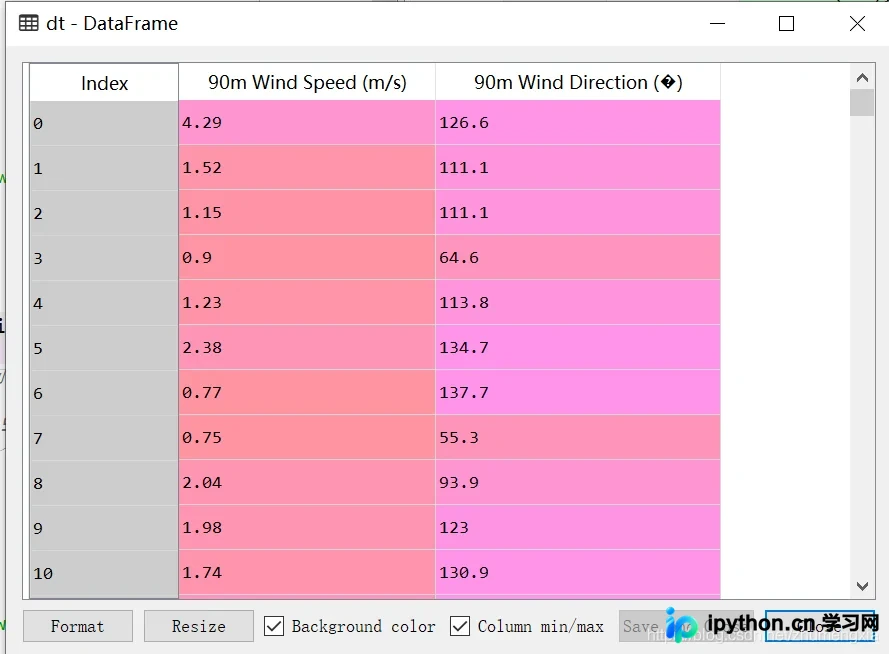
本文详细介绍如何使用Python的matplotlib库绘制风能玫瑰图。内容涵盖从原始测风数据读取、风速风向区间划分、频次统计到最终可视化的完整流程。重点讲解了将默认柱状图替换为面积图(fill)的方法,以及简化版风向玫瑰图的绘制技巧,帮助开发者掌握底层绘图逻辑,避免依赖第三方专用包。
本文介绍在Pandas中处理混合类型数据及过滤特定值的方法。通过示例展示如何处理read_csv读取时的类型警告,利用str.isdigit()筛选纯数字列,以及使用isin()和逻辑与操作符剔除包含特定数值或多条件组合的异常数据行。
本文详解使用Python进行简单人脸识别的实现过程。重点介绍OpenCV、face_recognition及dlib库的安装注意事项,包括国内镜像源更换及特定版本dlib的whl文件配置。通过三十行核心代码,演示如何加载图片、提取人脸特征编码、定位人脸位置,并结合视频流进行实时比对识别,提供完整的代码注释与逻辑解析。
本文深入解析Python中Lambda匿名函数的核心概念与实用价值。通过对比常规def函数,阐述Lambda在简化代码结构、减少重复代码及提升模块化方面的优势。文章结合具体代码实例,演示如何利用lambda进行数据映射与计算,帮助开发者掌握这一简洁高效的编程技巧。
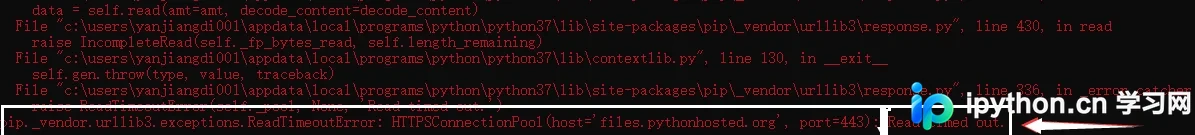
在使用PIP安装Python模块时,常因网络问题导致下载超时。本文详细介绍两种解决方案:一是通过修改pip.ini或pip.conf配置文件,将默认源更换为清华、阿里云等国内高速镜像;二是在受限网络环境下,利用有外网权限的机器搭建代理服务器,并在PIP中配置代理以突破访问限制,确保依赖包顺利安装。
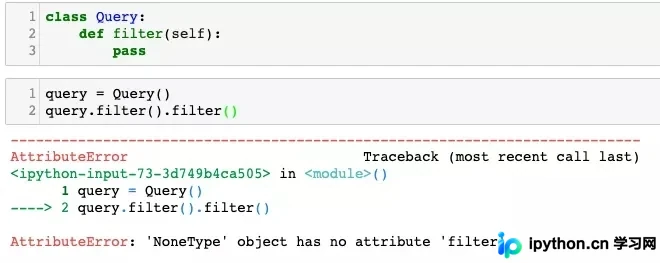
本文解析 Python 中链式调用的实现机制,指出关键在于方法返回实例自身(self)。通过修改 filter 方法返回 self,可消除 None 报错。进一步结合 **kwargs 缓存查询条件,模拟 Django 的惰性查询模式,仅在最终获取结果时执行数据库操作,提升效率。
针对M1芯片Mac上Anaconda不支持ARM架构及Python版本受限的问题,本文介绍使用Miniforge作为替代方案。详细讲解Miniforge的安装步骤,包括下载、终端执行安装脚本及库管理。同时提供配置清华镜像源的方法,解决国内用户下载速度慢的问题,确保开发环境稳定高效。