Python Pandas实现两个表格内容模糊匹配:全连接与字典遍历两种方案
本文介绍在Python中使用Pandas库对两个表格进行内容模糊匹配的方法。方法一通过全连接后筛选,逻辑简单但内存消耗大;方法二利用字典遍历,适合大数据集。文章提供了具体的代码实现、步骤解析及结果展示,帮助开发者高效处理文本匹配任务。
2026-10-14
6

本文介绍在Python中使用Pandas库对两个表格进行内容模糊匹配的方法。方法一通过全连接后筛选,逻辑简单但内存消耗大;方法二利用字典遍历,适合大数据集。文章提供了具体的代码实现、步骤解析及结果展示,帮助开发者高效处理文本匹配任务。
本文介绍如何使用 Python 的 collections.Counter 模块查找列表中的奇偶异常项。通过列表推导式结合取余操作提取各项奇偶性,并利用 Counter 的 most_common() 方法确定多数奇偶性,从而筛选出与大多数项奇偶性质不同的元素。该方法简洁高效,适用于数据清洗和异常检测场景。
本文解析如何利用 Python 的 functools.reduce 函数计算列表的最小公倍数。通过结合 math.gcd 与 lambda 表达式,实现多数值的最小公倍数迭代计算。文章同时指出该示例代码未包含异常处理及负数边界情况,适用于学习思路而非直接生产环境。
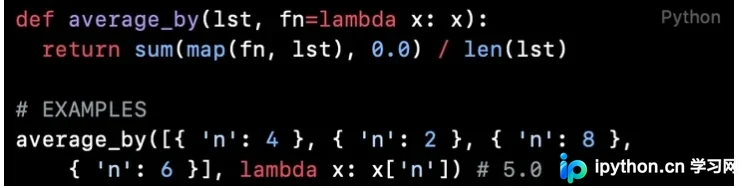
本文解析30-seconds-of-python库中的average_by函数,详解如何利用lambda匿名函数与map高阶函数提取列表数据并计算平均值。同时介绍max_by、min_by和sum_by等类似函数的用法,帮助开发者高效处理列表映射计算。
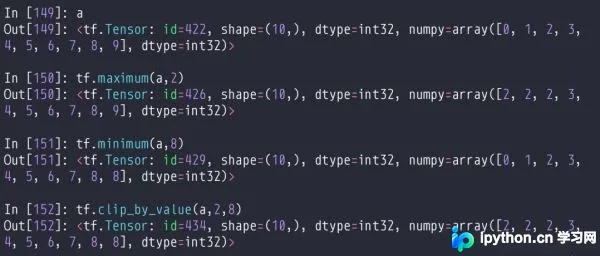
本文详细介绍TensorFlow中张量的核心高阶操作。涵盖按数值和范数进行张量裁剪以解决梯度爆炸问题,利用sort、argsort及topk进行数据排序与Top-K准确率计算。此外,解析tf.where条件筛选、tf.scatter_nd索引更新及tf.meshgrid网格生成等常用函数的具体用法与参数细节。
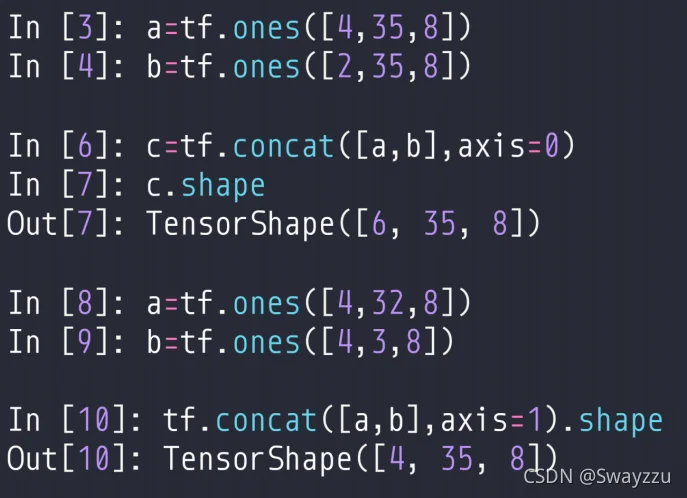
本文详解TensorFlow中数据合并与分割的核心函数,包括tf.concat、tf.split和tf.stack的维度处理规则。同时介绍数据统计操作,如tf.norm求范数、reduce系列求极值与均值,以及tf.argmax和tf.unique的使用方法与注意事项,帮助开发者掌握张量操作基础。
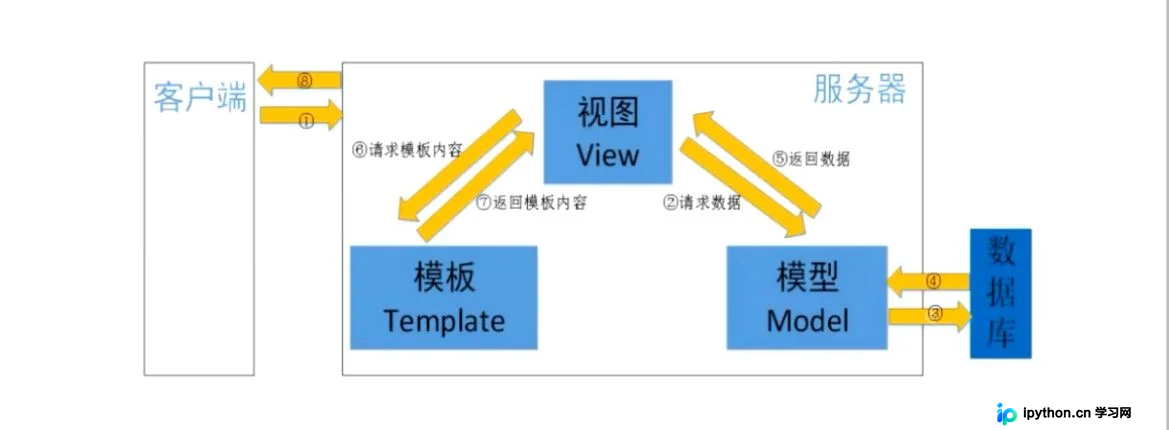
本文深入解析Django框架中的核心设计模式,详细对比MVC(模型-视图-控制器)与MTV(模型-模板-视图)架构的区别。通过剖析各组件的职责与数据流向,帮助开发者理解Django如何处理业务逻辑、数据库交互及页面渲染,掌握正确的开发规范。
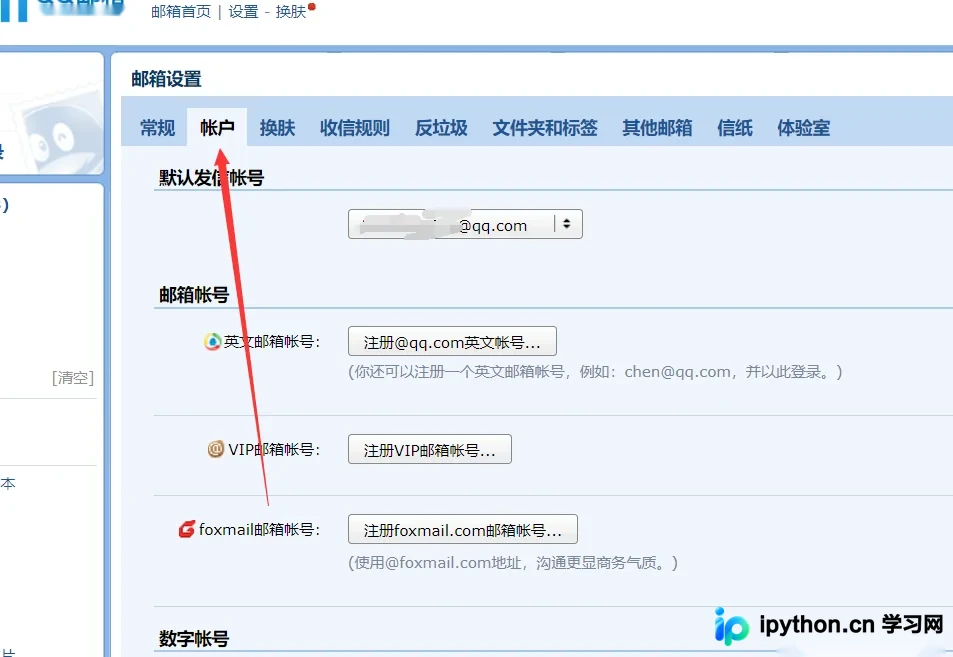
本文详细介绍如何使用Python自动发送QQ邮箱,涵盖从开启SMTP服务、获取授权码到编写发送脚本的完整流程。通过具体代码示例,演示如何发送纯文本及包含附件的邮件,并探讨结合爬虫实现自动化数据上报的进阶应用。
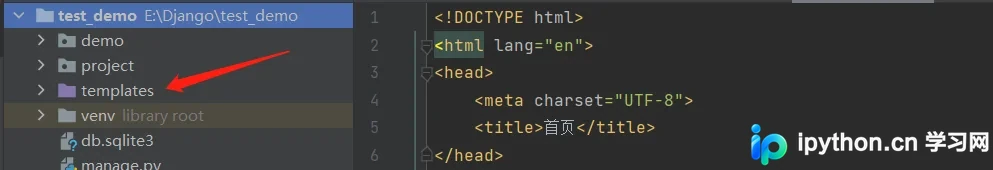
本文详细解析Django模板系统,涵盖模板路径配置、变量语法及静态文件引用。通过settings.py配置TEMPLATES,使用render函数在view.py中渲染HTML,并演示{{ }}变量、字典列表访问及静态资源加载方法,帮助开发者快速掌握Django前端交互核心。
PySnooper是一款GitHub热门Python开源调试工具,无需配置断点即可通过装饰器实现函数执行全量日志追踪。本文详解其安装方法、核心用法及局部代码块追踪技巧,展示如何快速获取变量变化与执行路径,是处理复杂逻辑与大型项目调试的高效替代方案。
本文介绍TensorFlow中Keras高层接口的核心应用。首先详解metrics模块,涵盖创建、更新、获取及重置状态的完整流程,用于训练过程中的数据跟踪。其次讲解快捷训练接口,包括compile配置优化器与损失函数,以及fit、evaluate和predict的具体用法与参数设置,帮助开发者高效完成模型训练与评估。
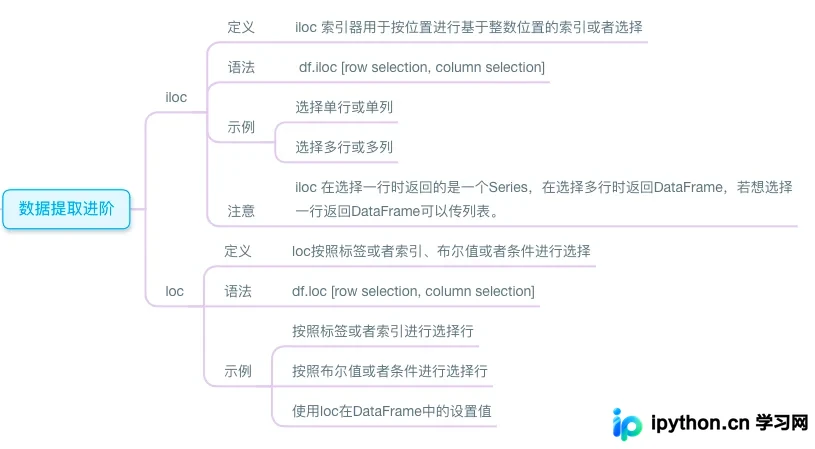
本文详解Python Pandas库中iloc和loc两种核心索引器的用法。iloc基于整数位置进行数据选取,返回Series或DataFrame;loc基于标签、索引或布尔条件进行筛选。通过具体代码示例,展示如何根据位置或标签选择单行、多列及设置值,帮助开发者高效处理数据。