

Pandas中创建Category类型数据的几种方法详解
本文详细介绍在Pandas中创建Category类型数据的两种主要方法。首先讲解如何直接指定预设类别创建分类数据,其次演示如何利用分箱机制(结合max、mean、min)动态生成Category类型。通过具体代码示例,展示如何处理空值、NaN及多字段数据分类,帮助开发者高效进行数据预处理与分类管理。
2026-10-15
6

本文详细介绍在Pandas中创建Category类型数据的两种主要方法。首先讲解如何直接指定预设类别创建分类数据,其次演示如何利用分箱机制(结合max、mean、min)动态生成Category类型。通过具体代码示例,展示如何处理空值、NaN及多字段数据分类,帮助开发者高效进行数据预处理与分类管理。
本文详细介绍如何使用Python和OpenCV实现基于模板匹配的图片数字识别。通过灰度化、二值化、形态学操作及轮廓筛选等步骤,精准定位并提取数字区域。文章包含完整的代码解析、环境配置说明及输出示例,帮助开发者掌握图像预处理与模板匹配的核心技术。
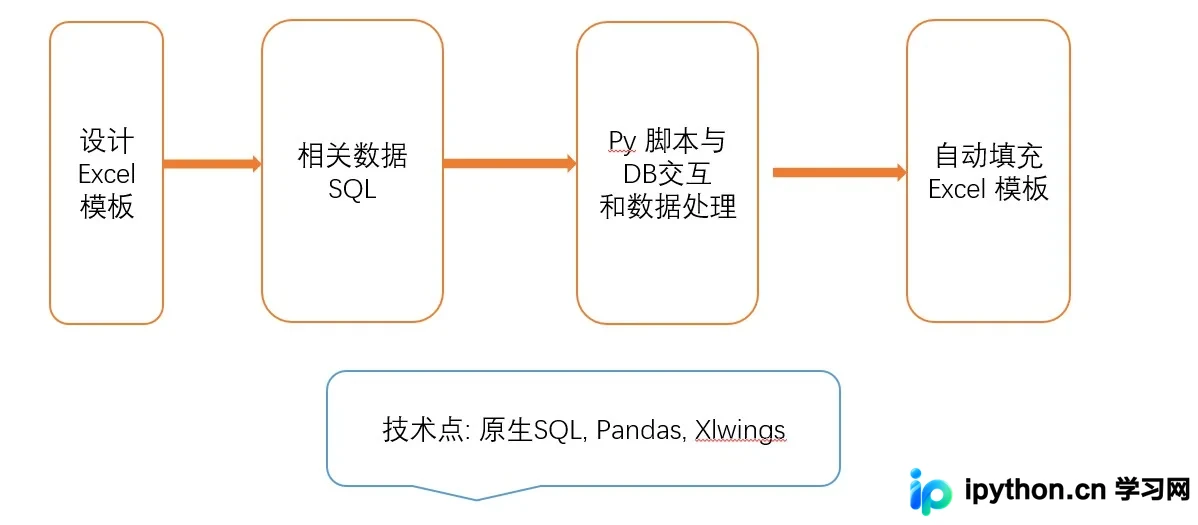
本文介绍如何使用 Python 结合 Pandas 和 Xlwings 库,通过 SQL 查询数据库并将数据自动填充至 Excel 模板,实现报表自动化。同时讲解如何利用 PyInstaller 将脚本打包为独立的桌面 EXE 程序,从而无需安装 Python 环境即可运行,大幅提升文员及业务人员的重复性工作效率。
本文介绍在Python中计算两个不等长列表对应元素乘积和的两种实现方式。首先通过遍历较短列表进行手动累加,其次利用内置zip函数将列表打包为元组后求和。文章还补充了计算列表元素总积的递归与迭代示例,帮助理解相关编程技巧。
本文详解如何在 Flask 应用中通过 threading.local 存储 logid,并利用 logging 模块的 Filter 功能自动将 logid 注入日志输出。方案使用 uuid.uuid1().time 生成趋势递增的唯一标识,无需手动修改每个日志打印点,实现请求上下文的自动关联与问题定位。
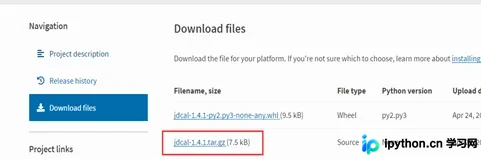
本文详细介绍在公司防火墙限制下,Python离线安装openpyxl模块的具体步骤。重点说明必须先手动下载并安装jdcal和et_xmlfile两个依赖包,否则将触发ModuleNotFoundError或Requirement.parse错误。通过官方PyPI页面获取压缩包,解压后执行setup.py install即可完成部署,适用于无法联网环境的Python开发场景。
本文详细介绍如何使用Python生成阿里云OSS的直传签名(Policy与Signature)并配置上传回调。通过示例代码展示如何构建上传策略、计算签名以及在后端服务中验证OSS回调请求的身份,确保文件上传的安全性与完整性。
本文详解Python中tempfile模块的安全用法,重点分析mktemp的不安全性及软链接劫持风险。通过对比不安全示例与正确代码,介绍mkstemp、TemporaryFile和NamedTemporaryFile的正确使用场景及清理机制,确保临时文件操作的系统安全。
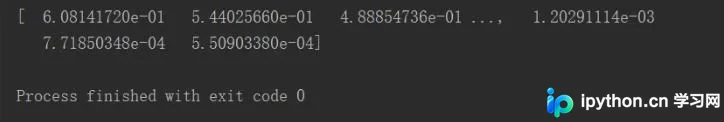
本文介绍Python中读取大型npy文件时print输出被截断的解决方法,通过调整np.set_printoptions阈值可完整显示数组。同时提供PyCharm打开大文件时仅显示部分内容的配置修改指南,通过修改idea.properties中的最大文件大小限制,实现大文件的全量查看。
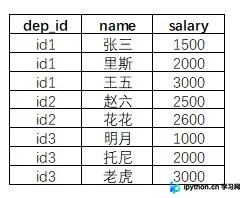
本文介绍如何在pandas中实现类似SQL row_number()的组内排序与排名功能。通过groupby结合rank或apply排序方法,可为DataFrame指定列按分组添加序号。示例涵盖薪资与班级得分场景,提供多种实现代码及注意事项,帮助开发者高效处理分组数据。
本文介绍Jupyter Notebook中代码突然无法执行的问题,主要原因为代码错误导致Kernel状态异常。通过观察右上角内核状态图标(空心与实心)判断执行状态,并给出重启Kernel、修正错误代码的解决方案。此外,还列举了无法读取CSV文件和快捷方式失效等常见错误及其路径检查的解决方法。
本文详细解析Python调用MATLAB的两种主要方式:mlab库与官方matlab.engine。对比指出mlab虽自动转换数据类型但存在自定义函数无法热更新的严重Bug;engine为官方推荐方案,需正确配置路径并处理变量类型对应。文章提供了安装步骤、参数传递技巧及解决“Too many output arguments”错误的实用建议,帮助开发者高效结合Python数据结构与MATLAB矩阵计算优势。