

使用Python自动化创建与导出Jupyter Notebook
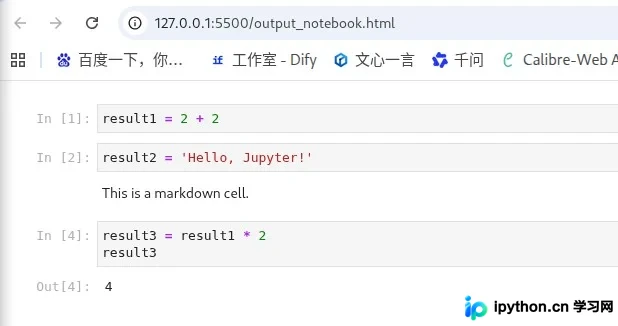
数据科学场景中常需自动化生成包含代码、Markdown及执行结果的交互文档。本文演示如何使用 nbformat 和 nbconvert 库通过 Python 脚本创建 Notebook 对象,配置单元格属性与模拟输出,最终将其稳定导出为可展示的 HTML 文件或可直接打开的 .ipynb 格式文件。
2026-10-10
26

数据科学场景中常需自动化生成包含代码、Markdown及执行结果的交互文档。本文演示如何使用 nbformat 和 nbconvert 库通过 Python 脚本创建 Notebook 对象,配置单元格属性与模拟输出,最终将其稳定导出为可展示的 HTML 文件或可直接打开的 .ipynb 格式文件。
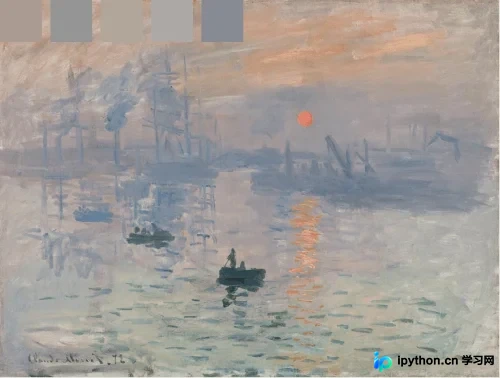
本文整理了9个Python自动化办公提效脚本,涵盖视频分段、文本情感分析、文件批量重命名与分类、主色提取、邮件自动发送、Office文档转PDF及PDF加水印等场景。通过引入ffmpeg、jieba、Pillow等常用库,配合标准路径操作与子进程调用,可大幅减少重复性手动操作。掌握这些脚本逻辑后,用户可根据实际目录结构灵活替换参数,快速搭建本地化办公自动化流程。
Python模块(Module)是组织与复用代码的核心单元。本文详细解析模块定义、四类导入语法、自定义构建流程、系统搜索路径配置及__name__执行守卫机制,提供从标准库调用到工程化包管理的完整操作指南,助力开发者规范书写高效代码。
本文系统梳理 Python 中字符串、列表、元组、集合及字典的常见遍历方式。通过直接迭代、索引计数、反向切片、条件过滤及标准库组合工具,提供各场景下的标准写法与内存优化方案,并附对比总结帮助开发者快速匹配高效遍历策略。
在Python开发过程中频繁测试库会导致运行环境臃肿,此时一次性卸载所有第三方包是最高效的清理手段。本文提供一套跨平台的安全操作方案,通过导出依赖清单配合系统级管道命令实现批量卸载,并详细说明不同终端的语法差异、高危操作规避策略及环境恢复方法。
本文详解利用Python与OpenCV进行身份证号码识别的完整流程。通过图像预处理、轮廓检测与位置筛选定位18位数字区域,结合自定义模板匹配逐字输出识别结果。提供核心代码实现、参数调整方法及常见误差排查指南,适用于身份验证自动化录入等基础场景。
在日常开发与运维中,手动管理Docker容器的生命周期效率较低。本文提供一套基于Python的自动化脚本方案,结合subprocess与psutil库,实现按名启动容器、通过chpasswd修改内部root密码、先stop后rm的安全清理,以及实时采集主机CPU、内存和磁盘使用率。脚本适用于Linux环境,可直接集成至运维平台或定时任务。
本文提供基于Python内置os模块的文件批量重命名脚本方案。通过配置目标路径、前后缀参数及字符替换规则,可高效处理大量文件名变更任务,同时保留原始扩展名并内置路径校验机制,适用于日常文档整理与资源归档。
在使用PyInstaller将XGBoost相关代码打包为独立可执行文件时,常会遇到运行时提示“super() has no attribute 'get_params'”的错误。该问题主要源于打包工具误识别了XGBoost内置的sklearn.py模块,导致与scikit-learn标准库发生命名冲突。通过手动重命名该冲突文件并重新打包,即可恢复依赖正常加载。
在技术文档流转场景中,常需将结构化的Markdown笔记导出为标准Word报告。本文演示如何利用Python库Spire.Doc.Free本地完成Markdown到Docx格式的转换。通过指定FileFormat参数加载源文件并调用SaveToFile输出,可实现单文件处理与批量文件夹转换。该方法无需依赖Microsoft Word,运行时需注意免费版页数限制及少数特殊语法的兼容性。
本文系统讲解 FastAPI 中的异常处理机制,涵盖基础 HTTPException 抛出规范、全局异常处理器统一响应格式、自定义业务异常类设计以及 WebSocket 长连接异常关闭策略。通过代码示例说明如何构建健壮的错误响应体系,并附带常见避坑指南,帮助开发者避免服务崩溃与前端调试困扰。
本文解析多进程同时读写文件时因操作非原子性导致读取残缺数据的竞态条件问题。提供临时文件加原子替换、第三方库filelock实现文件锁以及引入数据库三种解决方案,附带Python完整代码实现与跨平台兼容、缓存落盘等关键避坑细节,帮助开发者按场景选择稳定可靠的文件并发控制策略。