

基于Python开发的跨平台Nmap自动化扫描工具
本文详细介绍如何使用Python内置模块封装Nmap命令行指令,开发一套支持Windows、Linux和macOS的自动化网络扫描工具。通过正则解析gnmap格式、统一子进程管理及交互式菜单设计,解决手动敲命令繁琐、跨平台命令不兼容等问题,并提供完整代码实现、运行步骤及扩展优化方案。
2026-10-10
19

本文详细介绍如何使用Python内置模块封装Nmap命令行指令,开发一套支持Windows、Linux和macOS的自动化网络扫描工具。通过正则解析gnmap格式、统一子进程管理及交互式菜单设计,解决手动敲命令繁琐、跨平台命令不兼容等问题,并提供完整代码实现、运行步骤及扩展优化方案。
本文详解如何利用Python将Word文档转换为Excel格式。通过Spire.Doc库,您可以实现整文档转换、指定页面提取、表格导出以及加密文档处理。无需安装Microsoft Office,即可高效完成数据提取与格式转换,适用于报告生成、数据分析等多种场景。
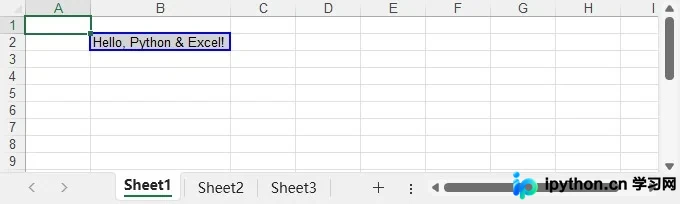
本文详解如何使用Python结合Free Spire.XLS库,通过程序化方式将文本、数值、日期、布尔值及字典列表等多类型数据高效写入Excel。涵盖格式设置、公式计算、图片插入与超链接创建等核心步骤,并提供资源管理与批量写入的最佳实践,帮助开发者快速构建稳定的报表自动化方案。
桌面应用常需多界面管理以提升体验与代码可维护性。本文以用户信息录入流程为例,讲解如何利用PyQt的QStackedWidget实现页面堆叠切换,并结合自定义信号槽完成跨页面数据传递与动态UI刷新。通过分步代码演示,展示输入校验、状态流转及解耦设计思路,帮助开发者快速构建结构清晰的多页面GUI程序。
本文详解Python中文本与二进制文件的读写原理及核心API。通过合理设置打开模式、使用安全上下文管理器与规范异常捕获机制,结合逐行读取、追加写入、文件复制及JSON数据交互等真实代码示例,帮助开发者高效且稳健地完成各类文件处理任务。
Python类中单下划线与双下划线属性的核心差异在于访问权限控制方式与底层实现机制。单下划线仅作为代码规范约定,提示内部使用但允许外部直接访问;双下划线会触发解释器的名称改写机制,在语法层面实现类域隔离。下文将逐一拆解两者的命名规则、内存存储变化、继承表现及工程实践建议,帮助开发者在类设计阶段做出准确选择。
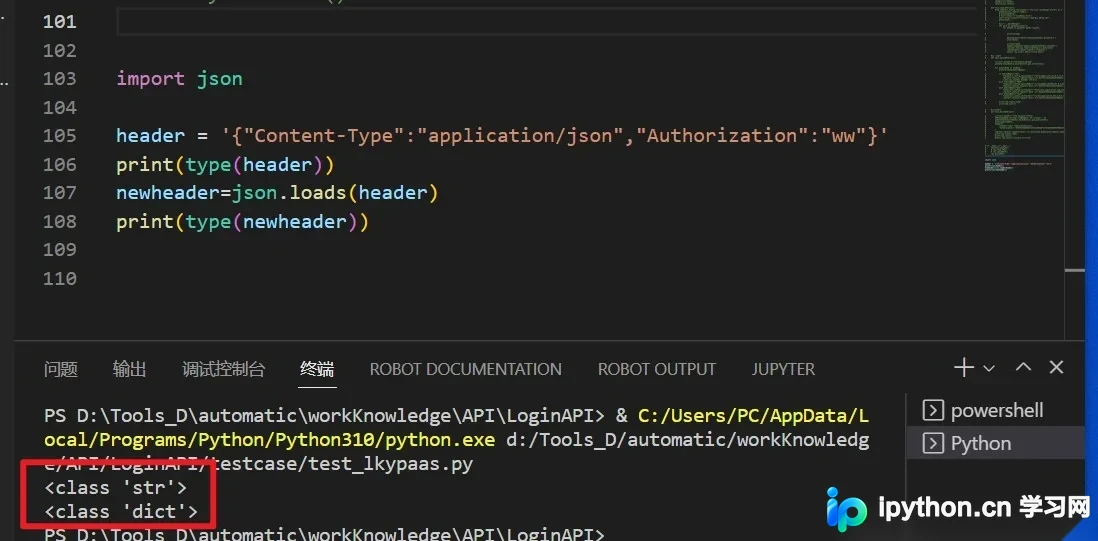
本文详解Python标准库中json模块的四种核心操作:loads、load、dumps与dump。通过对比数据流向与转换方向,提供完整的参数设置、代码示例与执行结果对照,帮助开发者快速掌握JSON数据的读写与格式转换技巧。
本文详解如何利用Python的re模块处理海量日志文件。通过具体代码示例,演示如何精准提取HTTP请求方法、URL、时间戳及状态码,并介绍使用列表推导式过滤特定关键词日志。此外,文章还涵盖了复杂日志的多字段解析、异常信息提取以及结合requests与定时任务实现日志处理自动化的完整流程。
简述Python中对象按创建后是否允许修改分为可变与不可变两类,涵盖字符串、数字、元组及列表、字典等类型的行为特征,并说明其在函数参数传递中的具体表现,帮助开发者避免内存引用误区。
本文详细解析了Python中实现单例模式的四种常见方式:类装饰器、__new__方法、工厂函数以及functools.lru_cache。通过代码示例对比了各方案的优缺点,并探讨了在工程实践中如何平衡透明性、可控性与可测试性,最终给出避免过度设计的建议。
在多进程环境下同时读写同一文件极易引发数据交错或结构损坏。本文基于Python标准库(fcntl、msvcrt)与第三方filelock工具,演示共享锁、排他锁及字节范围锁的配置方法,结合日志追加与序列化数据处理的完整流程,说明如何通过合理控制锁粒度、设置超时与防范死锁保障高并发系统的IO安全。
本文详解如何利用原生 Fetch API 结合 Flask 构建前后端分离的异步交互逻辑。通过拦截表单默认提交行为、统一使用 JSON 格式通信,并配合 HTTP 状态码检查与 DOM 动态渲染,实现登录无刷新跳转及业务数据即时更新,彻底告别传统页面重载。