

Python中利用for循环将字符串或字典元素添加至列表的方法
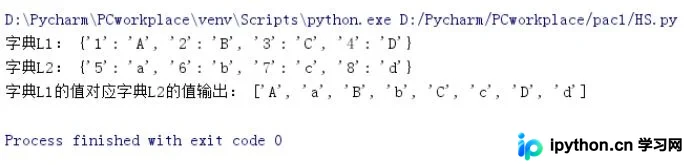
本文介绍在Python中如何使用for循环将字符串或字典元素添加到列表。通过迭代单个字符串、使用zip函数并行处理多个字符串,以及利用字典的keys()和values()方法,实现数据的灵活转换与列表构建。
2026-10-11
23

本文介绍在Python中如何使用for循环将字符串或字典元素添加到列表。通过迭代单个字符串、使用zip函数并行处理多个字符串,以及利用字典的keys()和values()方法,实现数据的灵活转换与列表构建。
本文详解Python中处理URL参数编码与解码的方法。通过urllib.parse模块,演示如何使用quote处理普通字符串编码,利用urlencode处理字典格式的查询参数,并结合unquote进行反向解码。文章包含完整代码示例与输出结果,帮助开发者掌握URL安全传输的关键技术。
在Python多线程开发中,准确获取当前线程名称是日志追踪、调试排错与资源监控的基础。通过threading.current_thread().name可快速获取对象属性。本文结合并发计算斐波那契数列与文件并行下载的代码示例,演示线程创建、命名设置及执行控制流程,并提供线程安全、死锁防范与性能调优等关键注意事项,帮助编写高可读、易维护的多线程程序。
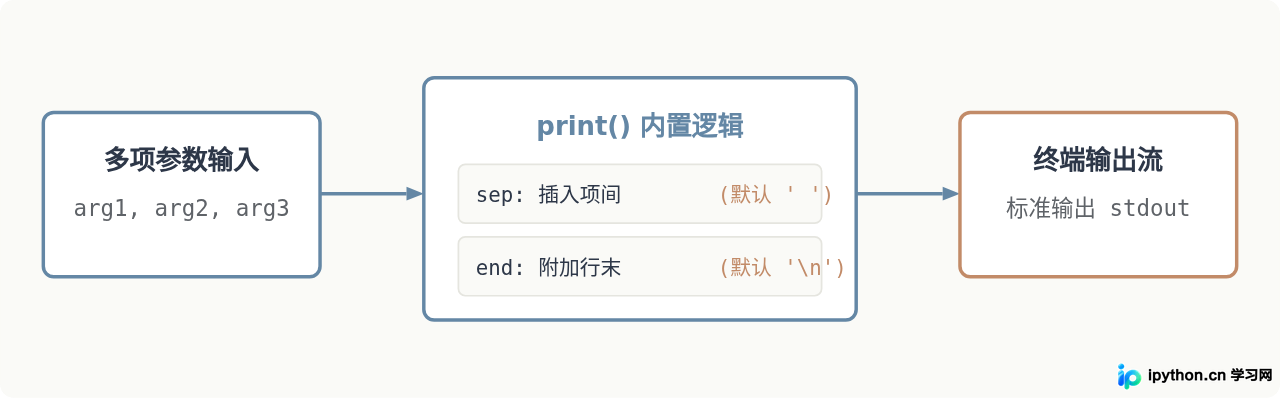
详细讲解Python高频内置函数print、input与核心列表操作函数的用法,包含参数解析、数据转换流程、实操代码与注意事项。
本文介绍使用Python3通过urllib库抓取微信网页版账单数据的方法。重点解析如何从Fiddler抓包获取exportkey、userroll_encryption及pass_ticket参数,解决SSL证书验证问题,并实现分页数据解析与数据库存储。
本文详细介绍如何使用Python和OpenCV库实现视频去抖动功能,包括基本帧差法与基于光流的运动估计算法。通过分步代码示例演示如何读取视频、逐帧处理并输出稳定后的视频,同时探讨性能优化策略和实际应用场景,帮助开发者快速掌握视频稳定化处理的核心方法。
本文介绍在 Python 3.x 环境下,利用正则表达式提取中文字符的两种常见场景:读取包含中文的文本文件以及处理给定的字符串。核心在于使用 Unicode 范围 [\u4e00-\u9fa5] 进行匹配,并需注意文件读取时的编码处理及字符串转义问题。
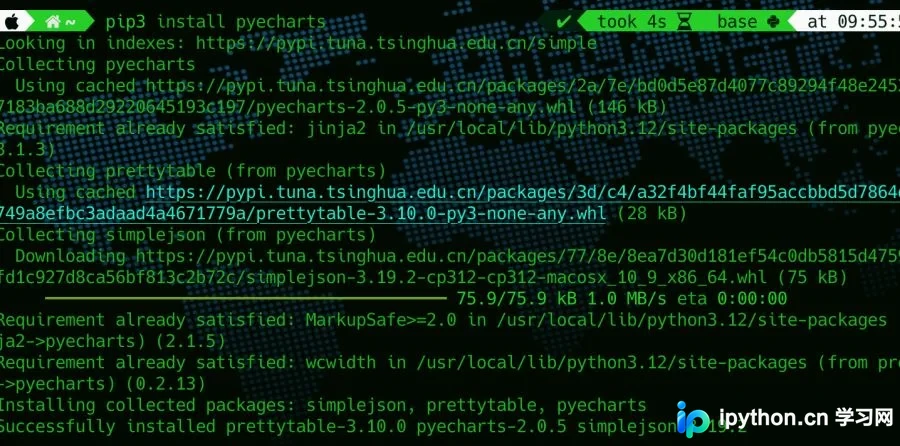
Mac通过Homebrew升级至Python 3.12后,直接使用pip3安装第三方库会触发外部托管环境报错。本文梳理标准隔离方案与解除限制的快捷操作,提供路径定位方法与版本兼容说明,帮助开发者快速恢复命令行包管理能力。
本文介绍如何使用Python的pymysql库连接MySQL数据库,遍历指定数据库下的所有表并统计数据条数。同时,利用numpy库提供的统计函数(如np.mean、np.sum等)处理提取的数据。最后,通过xlwt库将统计结果导出为Excel文件,实现数据库数据量的自动化统计与报表生成。
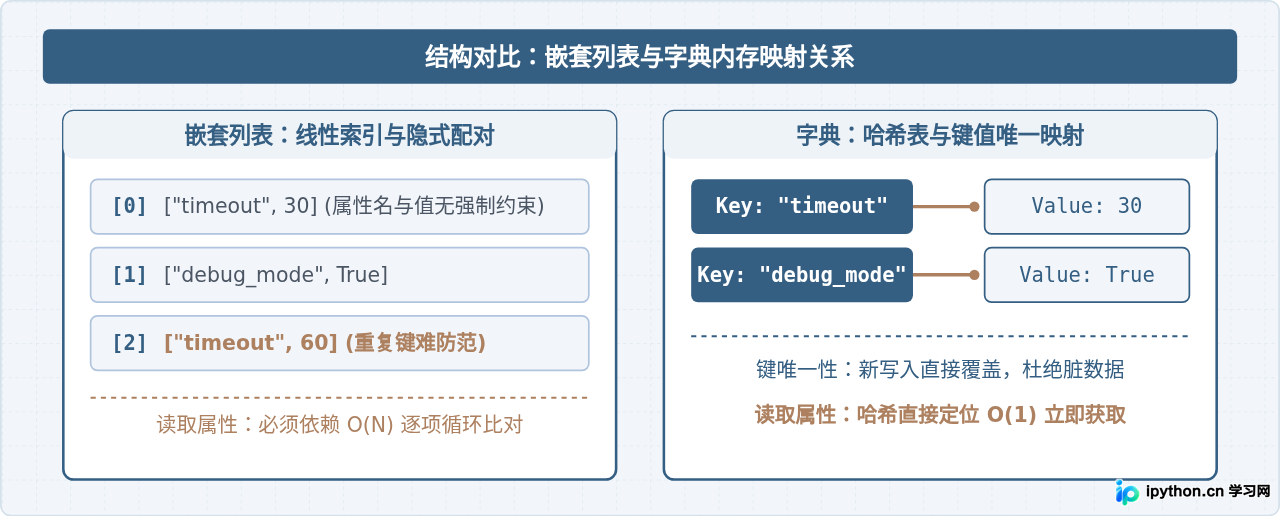
解析Python开发中用列表代替字典的典型误区,详细说明键值映射、唯一性约束、按名检索等典型场景下列表带来的性能与维护问题,给出清晰的判断标准与重构方法。
在使用Python的pandas库读取CSV文件时,常因文件编码格式(如GBK)与默认UTF-8不匹配而抛出UnicodeDecodeError。本文介绍如何通过指定encoding参数(如gbk)直接解决,以及利用文本编辑器转换文件编码的备用方案,确保数据顺利加载。
本文将演示如何使用Python生态库快速搭建情感分析流水线。通过NLTK清理基础语料,调用TextBlob与VADER算法量化文本极性,最后借助Matplotlib绘制得分对比柱状图与类别分布饼图,实现从原始文本到直观情感图谱的完整转化,助力业务系统低成本接入情绪识别功能。