

Python新手误区:什么时候不该用列表代替字典?

在Python开发中,列表(list)易于上手,许多初学者因此习惯将所有集合数据都放进列表。然而,一旦数据涉及“属性对应”、“唯一标识关联”或“频繁按名称查找”,继续使用列表会导致代码晦涩、逻辑臃肿且运行耗时成倍增加。本文将清晰拆解三种绝不应该使用列表代替字典的典型场景,并给出具体的判断标准与重构方案。
一、用嵌套列表模拟键值对:维护成本过高
新手最常见的写法之一,是用二维列表或由元组构成的列表来记录具有配对关系的数据。例如记录用户的邮箱、系统配置项,或者是员工的工号与部门信息。
# 常见误区:使用嵌套列表维护配对数据
user_configs = [
    ["timeout", 30],
    ["retry_times", 3],
    ["debug_mode", True],
    ["log_path", "/var/log/app.log"]
]

# 获取 debug_mode 的值需要写循环
debug_val = None
for item in user_configs:
    if item[0] == "debug_mode":
        debug_val = item[1]
break这种写法的首要问题在于代码表达意图不清晰。代码阅读者无法一眼看出 item[0] 和 item[1] 代表什么含义;其次,每次为了读取一个属性,都必须编写一段遍历匹配逻辑。如果键名拼写错误,排查起来往往只能通过跟踪调试,而无法在访问的第一时间触发明确的报错。
直接使用字典表达时,键与值形成了明确的语义绑定,代码精炼且意图直截了当:
# 标准做法:直接使用字典存储键值映射
user_configs = {
    "timeout": 30,
    "retry_times": 3,
    "debug_mode": True,
    "log_path": "/var/log/app.log"
}

# 直接取值,语义明确
debug_val = user_configs["debug_mode"]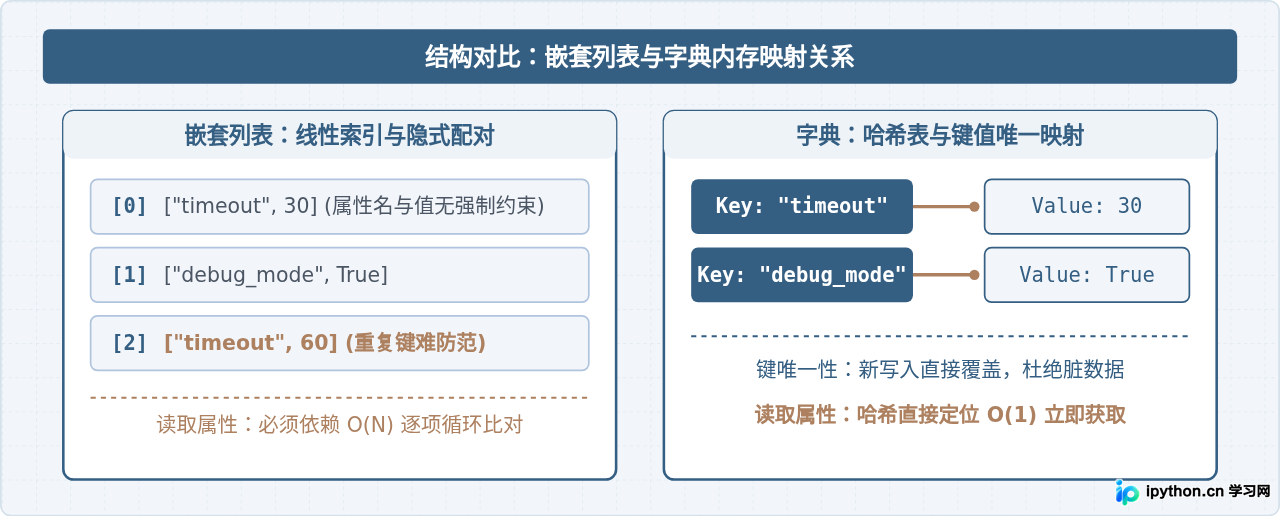
二、大规模数据频繁按“标识符”检索:出现性能瓶颈
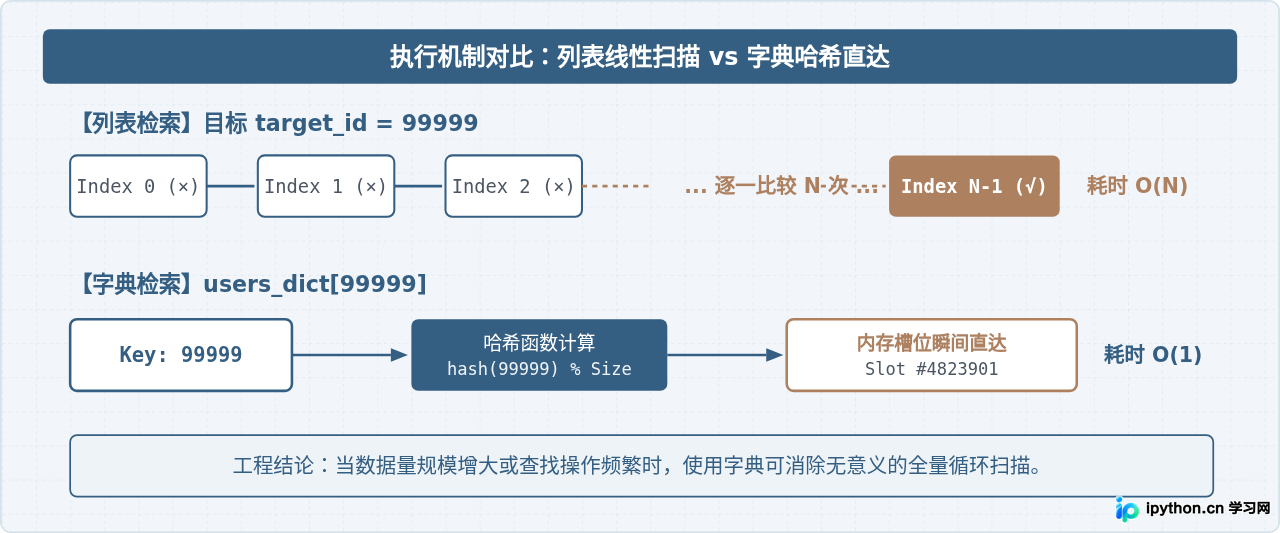
列表在底层是用连续内存块实现的动态数组。通过下标(如 lst[0])获取元素非常快,但如果需要通过具体的值(如学号、订单号、设备ID)查找对应项,Python 必须从头到尾逐个比对,这就是线性查找。
当列表中有 10 万条记录时,查找一个处于末尾的元素需要进行 10 万次比对。如果在一个处理流程中需要查找几千次,嵌套循环会直接让程序陷入卡顿。
# 场景:根据用户ID查找资料
# 假设 users_list 包含 100,000 个字典元素
users_list = [
    {"user_id": 10001, "name": "张三", "role": "admin"},
    # ... 此处省略 99,998 条记录 ...
    {"user_id": 99999, "name": "李四", "role": "user"}
]

# 在列表中查找用户 99999:平均需要比对 N/2 次,最差比对 N 次
def find_in_list(target_id):
    for u in users_list:
        if u["user_id"] == target_id:
            return u
return None字典的底层是高度优化的哈希表(Hash Table)。Python 会根据键的哈希值计算出内存存储位置,因此无论字典中存放的是 10 个元素还是 100 万个元素,获取特定键的值通常只需要一步计算完成,耗时几乎恒定。
三、需要保证业务标识“唯一性”:列表防重成本高
在许多业务逻辑中,一个主体(如商品编号、已注册手机号)只能存在一条配置或状态记录。若使用列表保存,每次写入新数据前,都必须手动执行防重排查:
# 常见误区:用列表维护不可重复的数据条目
registered_phones = []

def register_user(phone, name):
    # 每次插入前必须遍历整个列表做校验
    for item in registered_phones:
        if item[0] == phone:
            print("手机号已注册")
            return False
    registered_phones.append([phone, name])
    return True
这种逻辑存在两个隐患:
- 防御性代码冗余:业务核心本是“记录用户”,却需要花大量篇幅编写查重循环。
- 数据完整性容易失效:只要团队中有人漏写了查重判断,直接调用
append(),列表中就会悄然混入重复条目,引发难以预期的业务异常。
而在字典中,“键的唯一性”是由语言底层严格保证的天然特性。当对已存在的键赋值时,只会更新对应的值,绝不会产生重复键。
# 标准做法:利用字典天然保证键唯一
registered_users = {}

def register_user(phone, name):
    if phone in registered_users:
        print("手机号已注册")
        return False
    registered_users[phone] = name
    return True
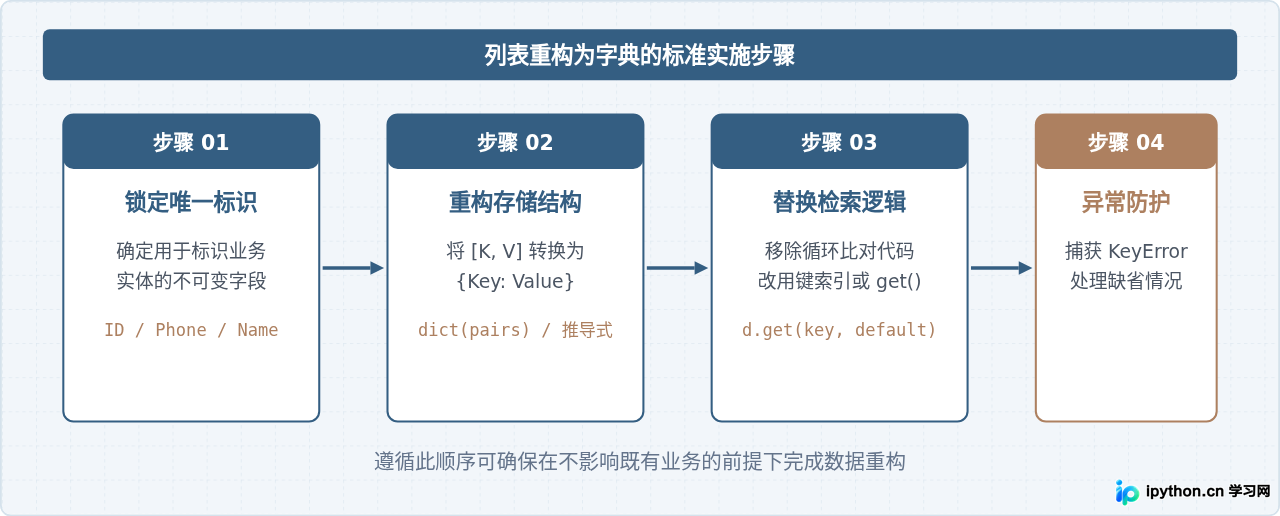
四、操作指南:将嵌套列表安全重构为字典
如果你手头已有一段使用列表模拟键值存储的代码,按照以下标准化步骤即可完成平滑迁移:
实战演练:重构现有的嵌套列表
假设你目前接收到的外部数据是包含键值对的元组列表,无需手写繁琐的循环赋值,Python 原生提供了多种精炼的转换机制:
# 原始输入数据(来自接口或文件)
raw_kv_list = [("max_connections", 100), ("timeout", 15), ("retry", 3)]

# 方式一:直接调用 dict() 构造函数完成转换
config_dict = dict(raw_kv_list)

# 方式二:对于对象列表,使用字典推导式快速重组
employee_list = [
    {"emp_id": "E101", "name": "王伟", "dept": "技术部"},
    {"emp_id": "E102", "name": "李敏", "dept": "财务部"}
]
# 以 emp_id 为键,重组为便于快速索引的字典
employee_map = {emp["emp_id"]: emp for emp in employee_list}

# 获取具体员工信息:一步直达
target_employee = employee_map.get("E101")[['tags'], 'data']),则无法直接用作字典的键,需要先转为元组(tuple)。
五、决策指南:什么场景保留列表,什么场景换用字典?
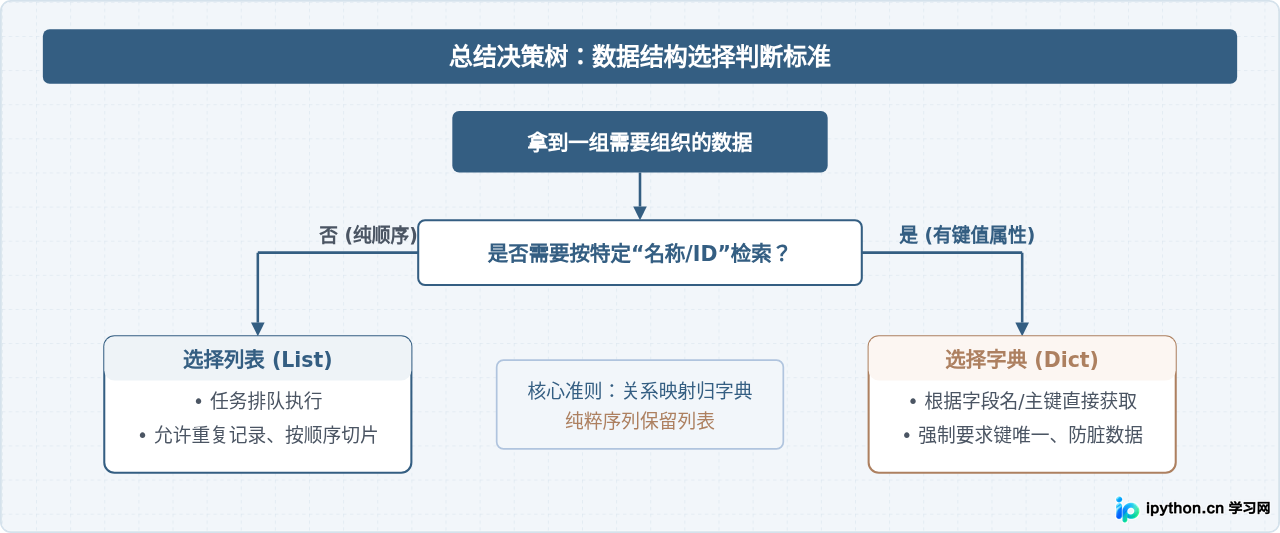
并不是所有集合数据都应该无脑换成字典。正确的数据结构选型,取决于数据的业务本质与访问特征:
| 判断维度 | 继续使用列表(List) | 应当换用字典(Dict) |
|---|---|---|
| 核心业务特征 | 元素是有序队列、时间线、流水记录 | 数据体现“属性与取值”、“主体与信息”映射 |
| 数据唯一性 | 允许相同的值出现多次(如多次日志输出) | 键必须具备排他性(如主键ID、唯一配置项) |
| 主要访问方式 | 按先后顺序逐一处理,或按位置切片 | 根据特定的名称、标识符(ID)精确检索 |
| 典型应用案例 | 任务排队、待办清单、测量数据序列 | 系统配置表、用户信息缓存、状态映射字典 |
结语
编程中选用哪种数据结构,本质上是在表达业务语义。当数据呈现“键值关联”、“必须按唯一标识查询”或“不可出现重复键”时,坚决避免使用列表模拟,改用字典能够以最少的代码量换取清晰的可读性与 O(1) 的检索性能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









