Python网络爬虫实战:抓取并保存中国大学排名数据
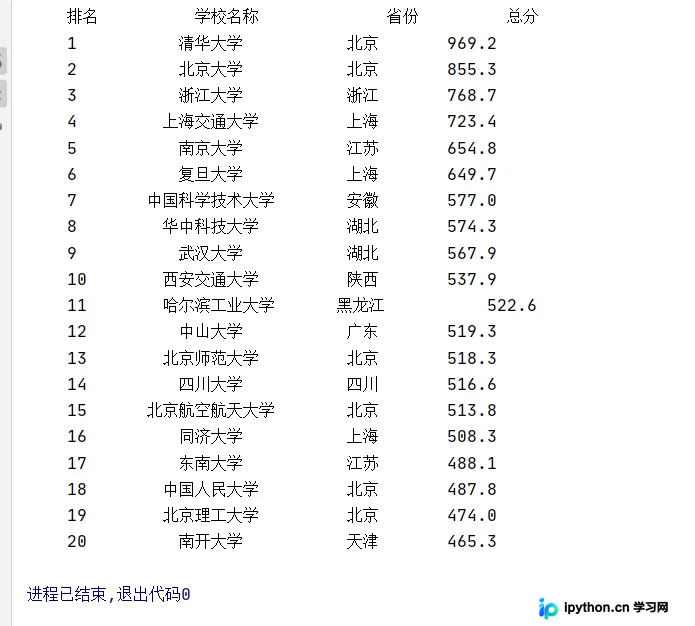
本文介绍如何使用Python编写网络爬虫,自动获取中国大学排名网站的前20所大学信息。通过requests库请求网页,利用BeautifulSoup解析HTML结构,提取学校名称、省份及总分等关键字段,并将结果格式化输出至控制台及本地文本文件,实现数据的自动化采集与持久化存储。
2026-10-15
7

本文介绍如何使用Python编写网络爬虫,自动获取中国大学排名网站的前20所大学信息。通过requests库请求网页,利用BeautifulSoup解析HTML结构,提取学校名称、省份及总分等关键字段,并将结果格式化输出至控制台及本地文本文件,实现数据的自动化采集与持久化存储。
本文介绍如何使用Python判断包含'(){}[]'的字符串是否有效。核心思路利用栈的先进后出特性,遍历字符串并匹配括号。若左括号入栈,遇到右括号则检查栈顶是否匹配,匹配则出栈。最终栈为空即为有效。文章提供完整代码实现及多个测试用例分析,适用于LeetCode相关题目求解。
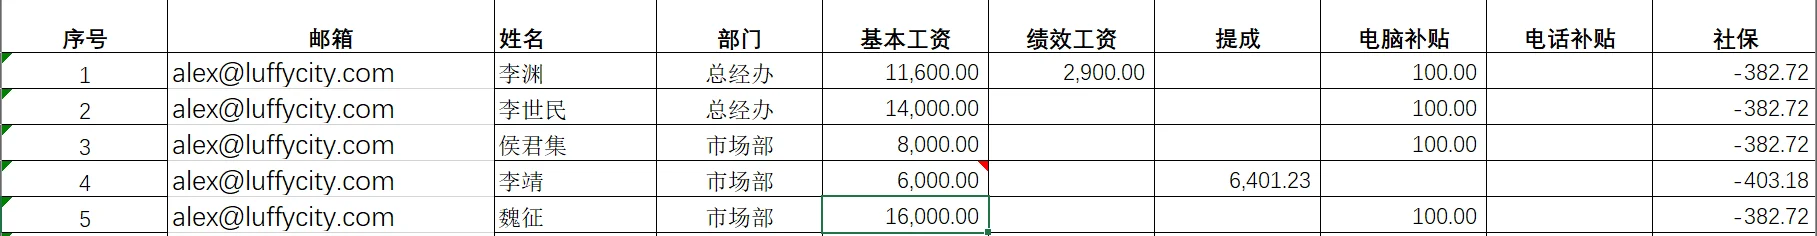
本文详细介绍如何使用Python批量向员工发送工资条邮件。通过读取Excel文件获取员工数据,利用smtplib库连接邮箱服务器,并构造HTML格式的工资条正文。重点解析了QQ邮箱等服务商使用授权码登录的配置细节,以及遍历Excel数据生成动态HTML表格的方法,帮助开发者实现高效的自动化办公流程。
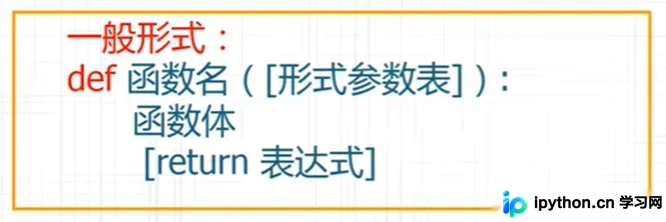
本文系统讲解Python函数的核心概念,涵盖自定义函数的定义规则、四种参数类型(必备、关键字、默认、不定长)的区别与应用,以及变量作用域和递归调用的实现原理。同时深入解析文件对象open函数的用法,结合具体代码实例演示如何读取、处理并写回文件数据,帮助开发者掌握Python基础编程技能。
本文详细介绍Python中安装第三方库的三种常用方法。首先讲解通过cmd使用pip进行在线安装、版本查看及卸载操作;其次演示如何下载wheel文件进行离线安装,包括匹配Python版本与系统架构;最后提供阿里云、清华等国内镜像源的临时与永久配置方法,解决下载缓慢问题,帮助开发者高效管理Python环境。
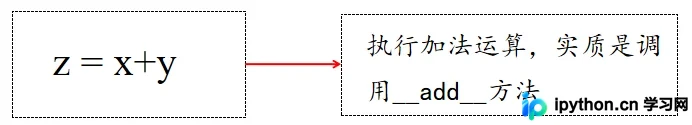
本文详细解析Python中的运算符重载机制,重点讲解如何通过实现__add__方法使自定义类支持加法运算。通过具体案例演示数组长度不等时的异常处理,并介绍如何定制对象的字符串表示形式,帮助开发者掌握Python面向对象编程的核心技巧。
本文整理了Python开发中高频使用的代码片段,涵盖日期生成与区间处理、CSV数据保存、基于Requests库的GET/POST请求发送,以及Redis、MongoDB和MySQL的连接与操作示例。此外,还分享了本地文件整合、多线程编程及异步爬取与文件保存的完整实现方案,旨在为开发者提供即拿即用的参考代码。
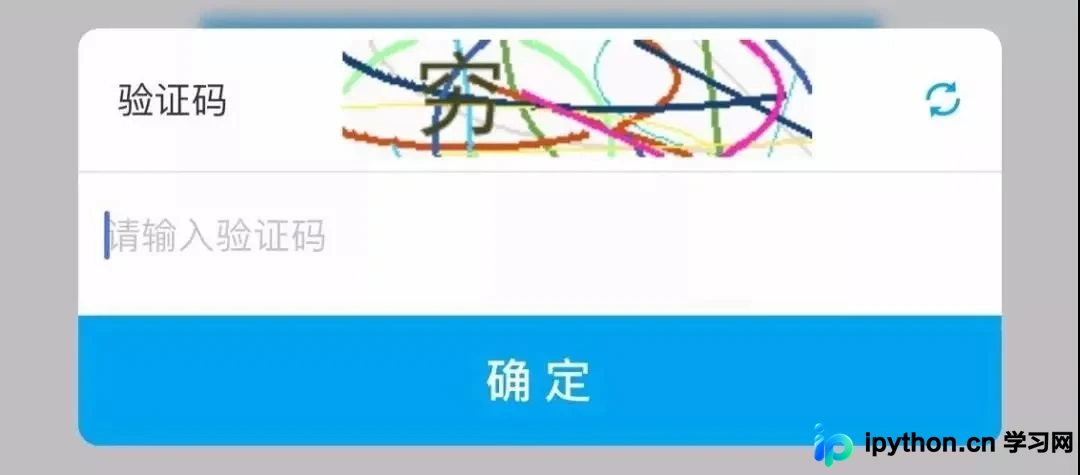
本文详细讲解如何利用Python的PIL库生成随机验证码。内容涵盖环境配置、画布与字体设置、字符绘制、以及通过random模块添加噪点和干扰线以提高识别难度。教程包含完整代码示例,演示如何封装函数生成不同颜色和位置的验证码,并支持批量保存至本地,适用于Web开发登录验证及AI模型训练数据准备。
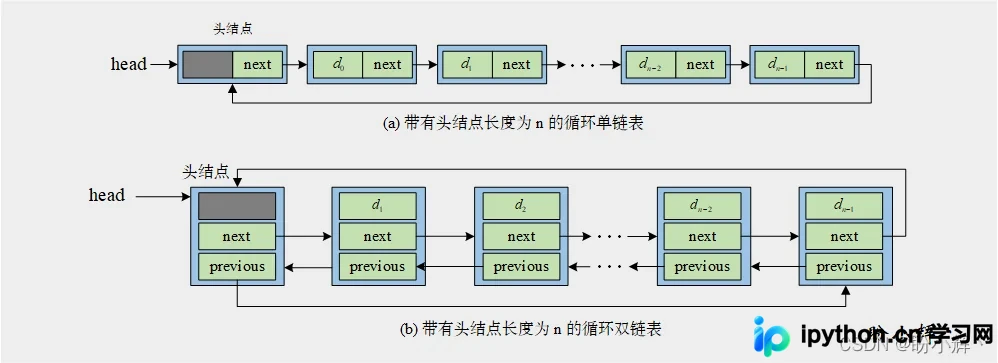
本文详细解析Python中循环链表与循环双链表的实现原理及代码。涵盖循环单链表的初始化、遍历、插入删除操作,以及利用继承简化实现的技巧。同时深入讲解循环双链表的节点指针处理及复杂操作,通过完整代码示例验证各项功能,帮助开发者掌握环形数据结构的核心逻辑。
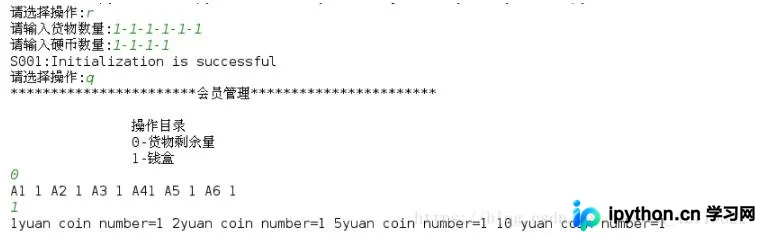
本文展示使用Python构建的简易自动售货机系统,涵盖初始化设定、管理员查询及顾客购买流程。系统限制硬币面额为一至十元,要求钱盒余额满足找零需求,并处理多次购买与余额计算逻辑,适合初学者理解状态管理与条件判断。
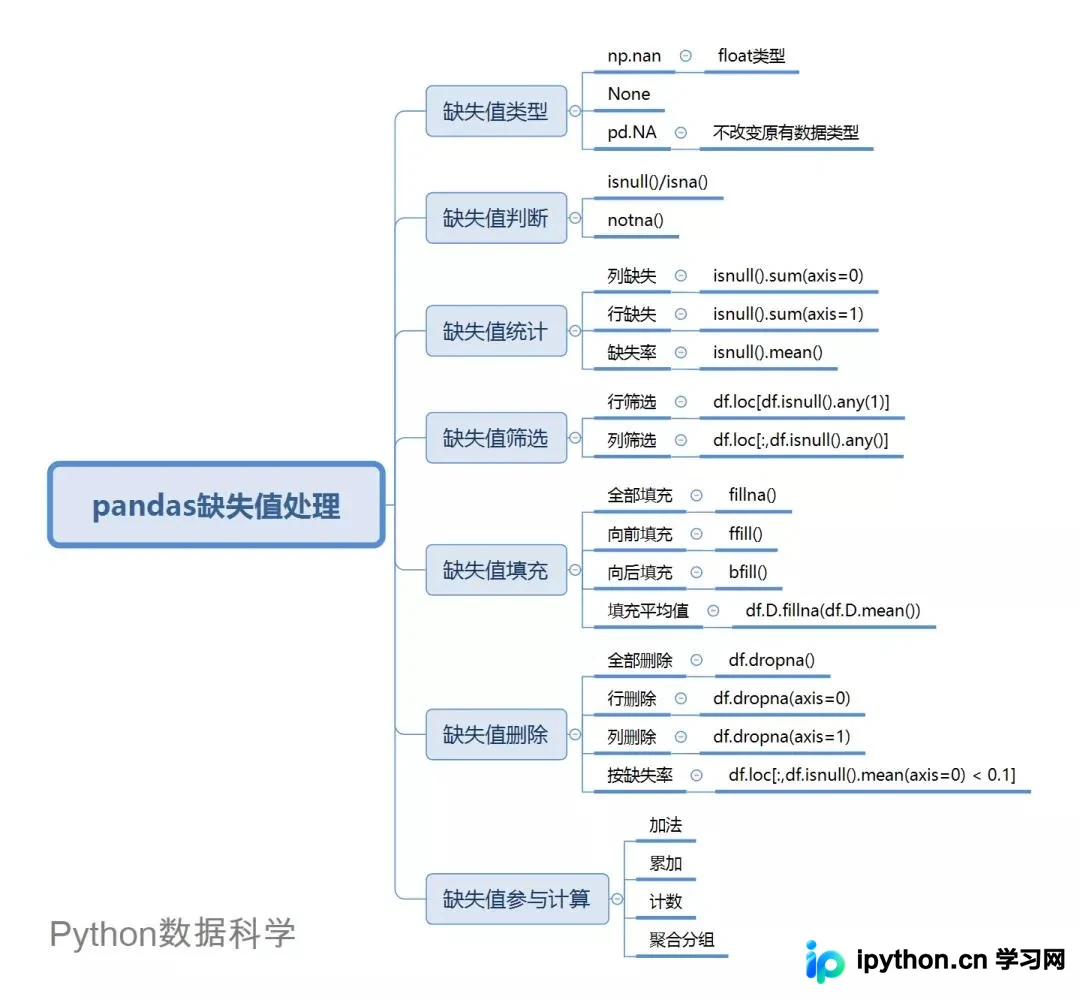
本文深入解析pandas中缺失值的三种表示形式(np.nan、None、pd.NA)及其对数据类型的影响。详细讲解isnull/isna判断、缺失率统计、基于loc的筛选方法,以及fillna填充(含ffill/bfill)、dropna删除和缺失值参与计算的逻辑,提供完整代码示例与参数说明。
本文详细介绍如何使用 Python Selenium 库实现豆瓣网站的模拟登录。重点解析了当登录入口嵌套在 iframe 中导致直接定位失败的问题,通过切换至 iframe 解决元素不可见错误。同时涵盖账号密码输入、清除默认文本、点击登录按钮(包括 JS 执行方式)以及获取 Cookie 的完整流程,提供关键代码片段与操作建议。