

Python h5py库基础详解:创建文件、数据集与组的操作指南
详细介绍Python h5py库的核心操作,涵盖HDF5文件的读写模式配置、一维及多维数据集的创建与NumPy数据对接,以及组的嵌套管理与路径映射机制。提供完整代码示例与运行结果对照,适用于数据存储与科学计算场景的快速上手。
2026-10-12
28

详细介绍Python h5py库的核心操作,涵盖HDF5文件的读写模式配置、一维及多维数据集的创建与NumPy数据对接,以及组的嵌套管理与路径映射机制。提供完整代码示例与运行结果对照,适用于数据存储与科学计算场景的快速上手。
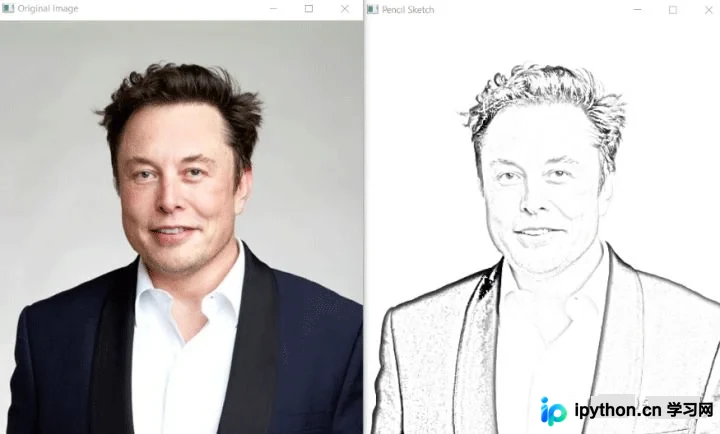
Python凭借简洁语法与丰富生态,成为编写自动化脚本的首选语言。本文整理5个实用自动化场景代码,涵盖网页新闻抓取朗读、图像素描生成、Excel联系人批量邮件发送、Dtale一键数据探索及Windows桌面定时弹窗提醒。提供完整依赖配置、核心代码块与运行环境说明,帮助开发者快速集成到日常工作流中提升效率。
本文系统梳理Python常用快捷语法与底层技巧,涵盖条件判断、集合翻转、进制转换、多维列表初始化、字符串处理、循环控制及内置函数调用。通过规范代码示例与参数说明,帮助开发者简化冗余逻辑,提升日常编写与调试效率。
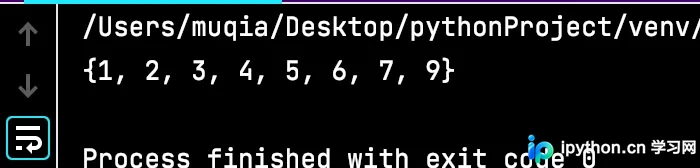
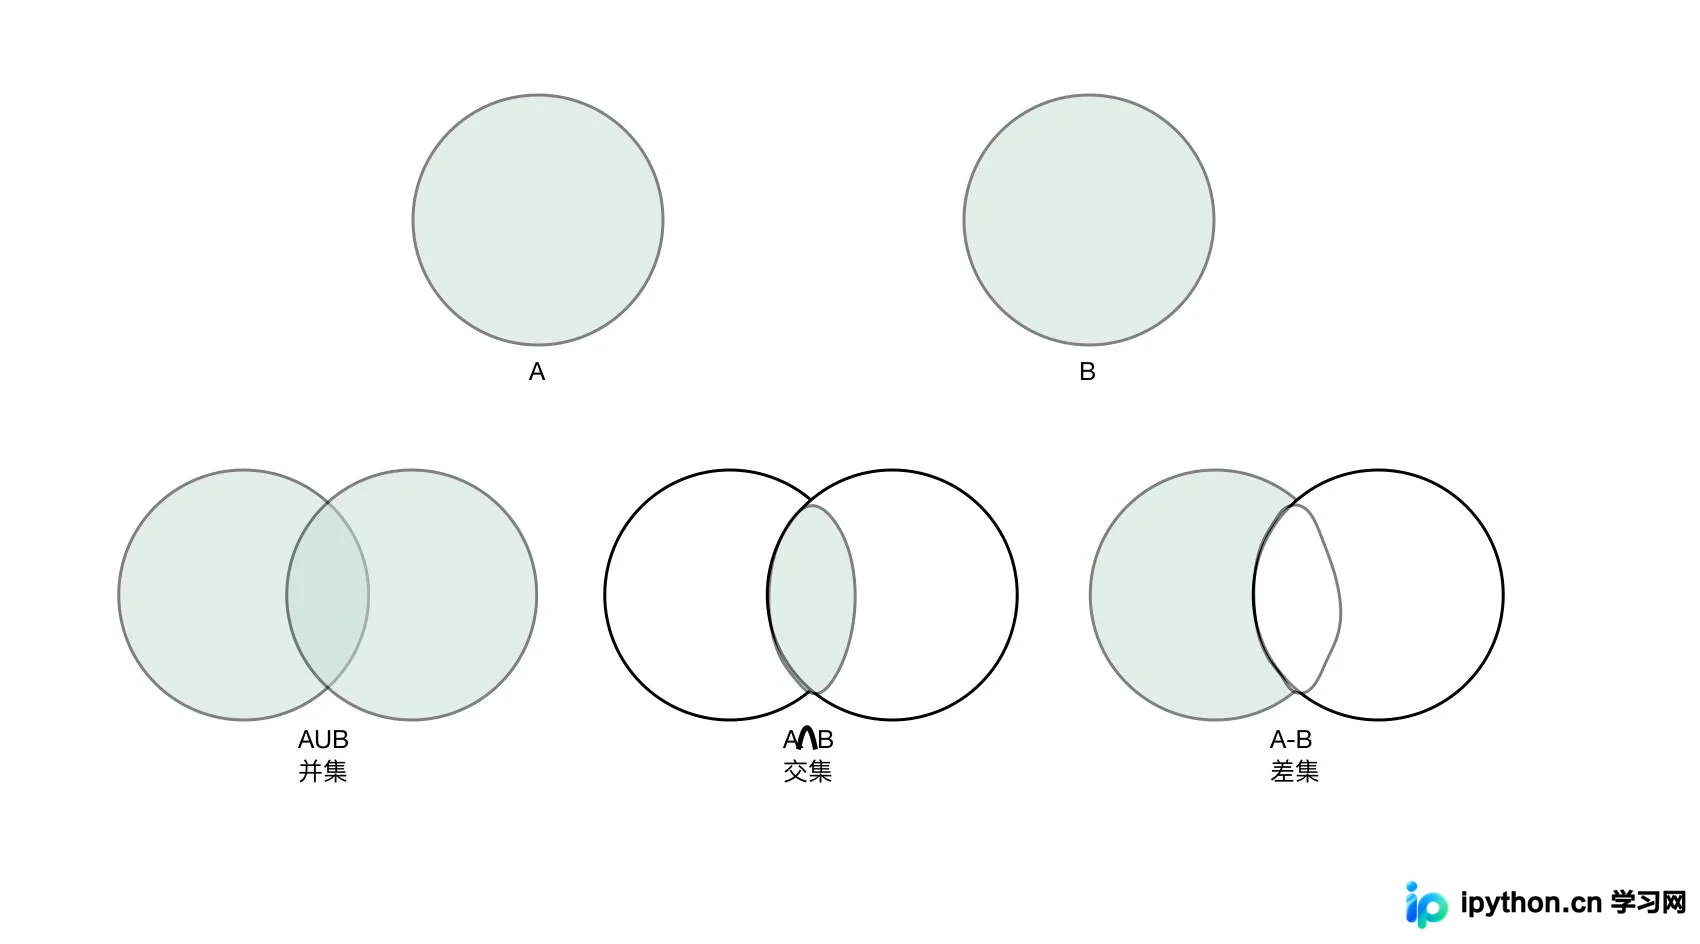
本文详解 Python 中集合(set)的定义特性与核心操作方法。通过实际代码演示初始化构建、add/update 添加、remove/discard/pop 删除及 clear 清空等步骤,并完整展示交集、并集、差集与子集判断等数学运算用法,帮助开发者高效实现数据去重与逻辑运算。
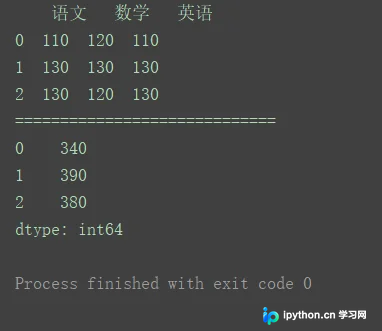
在Python数据分析中,pandas库提供了apply()、map()和applymap()三个核心函数,分别用于DataFrame的行列级操作、Series的逐元素处理以及DataFrame的逐元素清洗。本文通过实际代码示例与运行结果对比,明确三者的作用范围、参数配置及典型应用场景,帮助开发者快速掌握批量数据处理技巧。
本文详解如何利用Pipenv创建纯净虚拟环境配合Pyinstaller打包Python项目。通过隔离无用依赖库,可显著降低生成的exe文件体积。涵盖环境准备、虚拟环境管理、依赖安装、打包参数配置及常用命令,帮助开发者快速输出轻量级可执行文件。
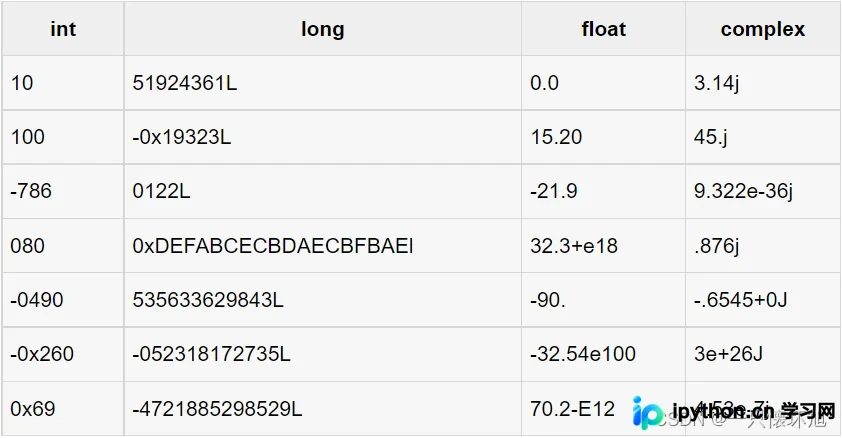
本文详细解析Python的五个标准数据类型:数字、字符串、列表、元组和字典。涵盖各类数据的创建方式、核心特性(可变性与不可变性)、常用操作及代码示例,帮助开发者快速掌握Python基础数据结构的使用方法与实际应用场景。
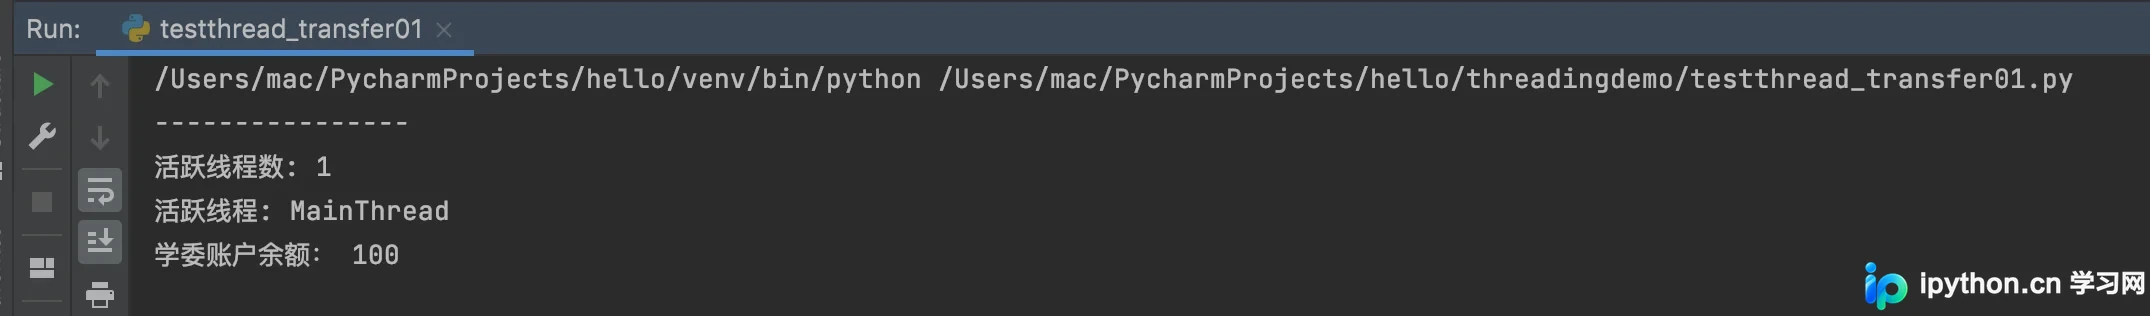
本文通过银行转账真实场景,演示Python多线程在并发修改共享余额时极易出现的脏数据问题。通过对比未加锁与使用threading.Lock的运行结果,详细讲解临界区概念与互斥锁的正确用法,帮助开发者掌握保障线程同步的核心技巧。
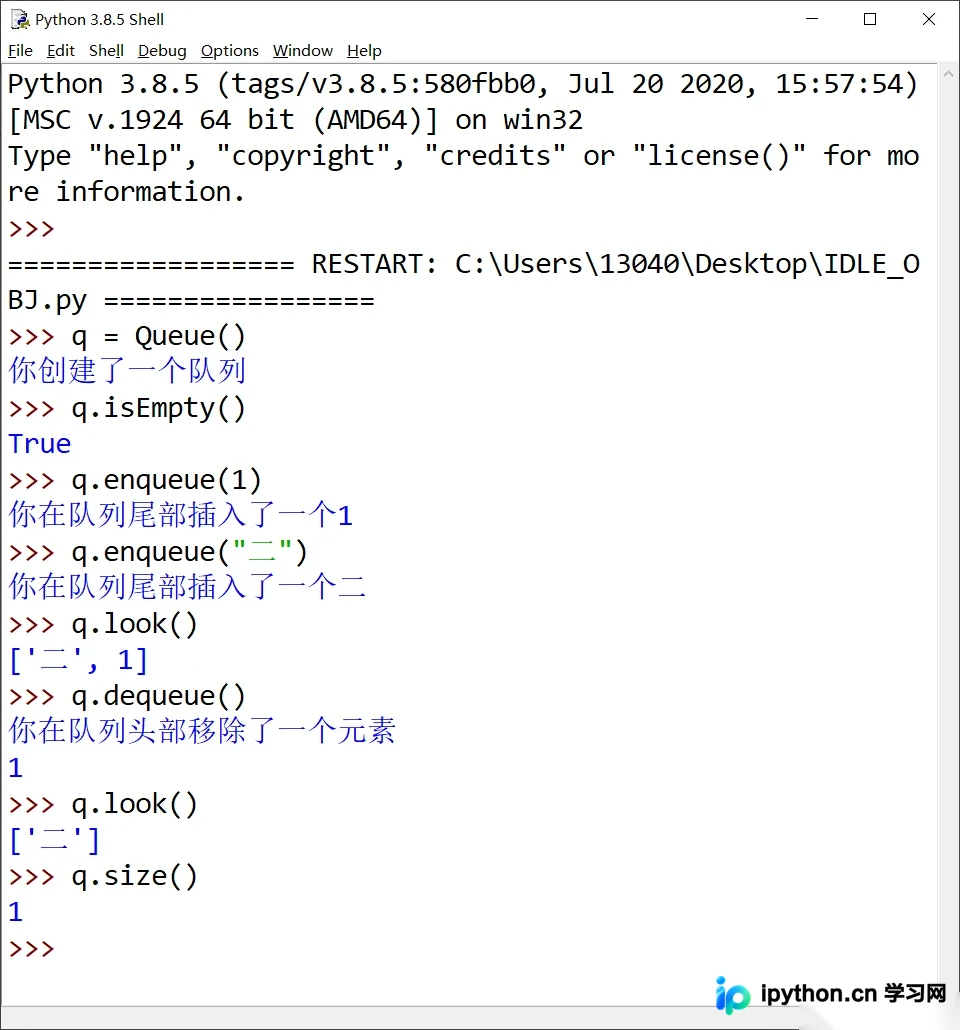
本文详解Python中先进先出(FIFO)队列的数据结构原理与操作规范。通过基于内置列表的完整类封装示例,演示如何实例化队列对象并掌握入队、出队、判空及长度查询方法,同时解析各项操作的底层执行逻辑与时间复杂度,为理解线性表数据组织形式提供基础代码参考。
本文详细讲解Python中集合(set)与冻结集合(frozenset)的交集与并集操作。通过实例演示 intersection()、& 运算符求交集,以及 union()、| 运算符求并集的标准写法,同时说明 intersection_update() 与 update() 的原地修改特性,以及与其他数据类型运算时的隐式转换规则与注意事项。
本文系统梳理了 Python 列表的基础运算符与核心方法。涵盖元素新增、插入、合并、删除、排序、反转及统计功能,并重点解析了 append 返回值特性与深浅拷贝的内存机制。通过标准代码示例与常见误区排查,帮助开发者高效掌握列表操作,提升数据处理效率。
本文详解Python科学计算库NumPy的配置与核心用法。涵盖从命令行安装到环境验证的流程,通过代码演示一维至多维数组的创建方法、常用属性查看技巧,以及元素级算术运算、统计函数应用与索引切片操作,助您快速建立数据分析与矩阵计算的基础工作流。