详解NumPy中np.nanmax与数组.max()的区别及避坑指南
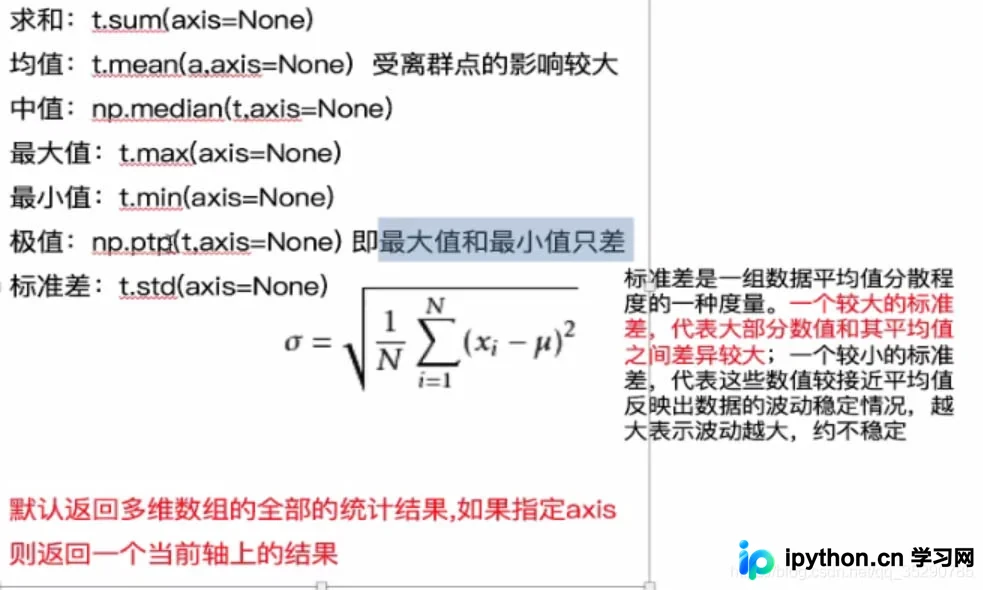
在数据分析与科学计算中,处理包含缺失值(NaN)的数值数组时,直接调用最大值或均值函数极易返回意外结果。本文深度对比np.nanmax与数组.max()的底层差异,解析自动过滤NaN的计算逻辑,提供多场景执行效率参考,并系统梳理常见统计函数的正确调用方式,帮助开发者规避数据处理陷阱。
2026-10-12
19

在数据分析与科学计算中,处理包含缺失值(NaN)的数值数组时,直接调用最大值或均值函数极易返回意外结果。本文深度对比np.nanmax与数组.max()的底层差异,解析自动过滤NaN的计算逻辑,提供多场景执行效率参考,并系统梳理常见统计函数的正确调用方式,帮助开发者规避数据处理陷阱。
本文详细演示如何使用Python内置的re模块及正则表达式从杂乱文本中精准提取数字序列与年月日信息。通过对比match、search与findall函数的差异,掌握核心编译参数与匹配逻辑,并提供直接可用的数字提取与日期抽取代码片段,满足日常数据处理需求。
本文详解 Python 字典(Dictionary)的创建语法、键值对增删改操作及核心内置方法。通过代码示例演示如何安全访问数据、处理 KeyError 异常、理解键的不可变特性,并整理 Py3 环境下的高频 API 使用规范,帮助开发者快速掌握字典数据结构。
通过约束不同类别的协方差矩阵相等,可将高斯贝叶斯分类器简化为线性决策边界的分类器。本文以UCI鲍鱼数据集的两类预测任务为例,详解如何使用Python重新对齐数据中心并计算全局协方差矩阵,进而完成线性分类模型的训练、概率推演与准确率评估流程。
本文详细讲解如何使用Python的paramiko库通过SSH协议远程调用Linux服务器指令。内容包含基于SSHClient的快捷执行脚本与支持交互式回显的面向对象封装类,提供完整的参数配置、连接重试机制及常见编码超时问题排查指南,帮助开发者快速集成自动化运维任务。
在Python多进程与多线程混合开发的场景中,直接让各进程向同一文件写入日志极易引发数据覆盖或乱码。本文介绍通过 multiprocessing.Queue 结合独立日志线程的标准方案,实现并发环境下的安全写盘与自动轮转,附带可运行的完整代码结构与关键避坑指南。
本文详解 Python 循环结构的核心逻辑,涵盖 while 与 for 的基础语法、range 参数规则、break 与 continue 的控制差异,以及 else 子句和嵌套循环的实际应用。通过累加求和、密码验证与九九乘法表等完整代码示例,帮助开发者快速掌握自动化迭代的实现方法。
本文详细讲解如何利用Python列表推导式,一键从多层嵌套的数据结构中筛选出长度大于5的名字。通过拆解遍历顺序、对比常规循环写法,并提供可直接运行的测试代码与结果验证方法,帮助用户快速掌握高效的数据清洗技巧。
本文系统整理Python中常用数据类型的转换方法,涵盖int、float、str、list、tuple及bool之间的转换规则。通过标准内置函数与字符串方法,结合实操代码示例,提供清晰的输入输出结果与异常处理建议,帮助开发者快速完成数据格式清洗与类型校验。
本文系统梳理Python中字符串的定义规范及高频处理方法,涵盖大小写转换、长度与零填充、子串定位统计、前后缀校验、字符过滤替换、类型诊断以及进阶切片规则。搭配可直接运行的代码示例,帮助开发者快速掌握文本处理的核心技巧。
本文详细解析Python列表中元素增加与删除的核心方法。通过对比append、extend、insert三种添加方式,以及pop、remove、del、clear四种删除操作的语法结构、返回值差异与典型应用场景,配合完整代码示例,帮助开发者快速掌握序列数据处理技巧,有效规避索引越界与类型混淆问题。
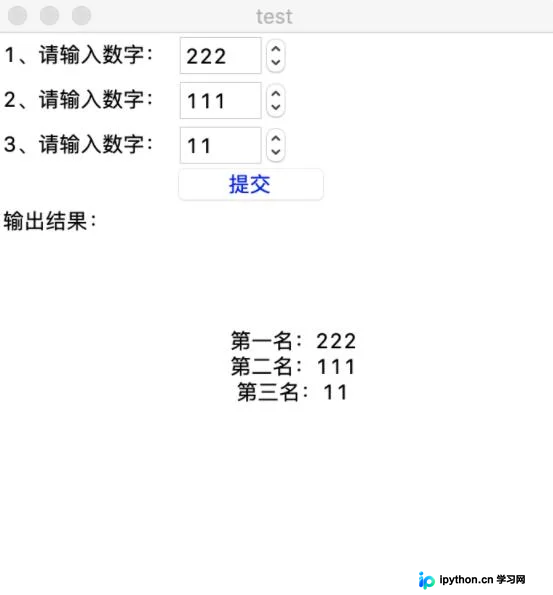
本文介绍了使用Python标准库tkinter搭建轻量级图形界面的方法。通过结合Spinbox输入框、Button按钮与Text文本框,实现了多组数据的捕获、排序与动态刷新输出,附带完整源码及常见报错排查指南。