Python趣味挑战之turtle库绘画飘落的银杏树
本文介绍如何使用Python的turtle库绘制一棵动态飘落的银杏树。通过结合斐波那契数列控制树枝生长,利用随机数生成自然分叉与叶子分布,实现每次运行结果不同的视觉效果。文章详细解析了叶子绘制、树枝生成及飘落动画的核心代码逻辑,适合Python初学者进行图形编程练习。
2026-10-12
21

本文介绍如何使用Python的turtle库绘制一棵动态飘落的银杏树。通过结合斐波那契数列控制树枝生长,利用随机数生成自然分叉与叶子分布,实现每次运行结果不同的视觉效果。文章详细解析了叶子绘制、树枝生成及飘落动画的核心代码逻辑,适合Python初学者进行图形编程练习。
本文详细介绍Python中Matplotlib库的核心绘图功能。内容涵盖基础绘图命令、颜色与线型设置、中文及特殊符号显示、子图布局、坐标轴与标题定制、图例管理、数据标注及图片保存等关键操作。通过具体代码示例,帮助开发者快速掌握高质量图表的绘制技巧,解决常见显示问题。
本文系统梳理Python PEP 8编码规范,涵盖缩进、行长度、空行、命名、字符串及注释等核心规则。详细解析4空格缩进、79字符行限制、变量命名禁忌及文档字符串写法,帮助开发者编写清晰、一致且符合社区标准的Python代码。
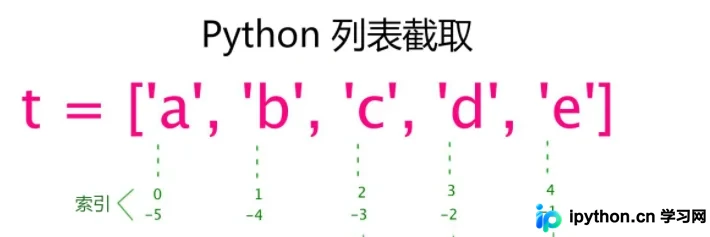
本文深入解析Python中列表(List)的切片操作机制。详细讲解正向索引从0开始、反向索引以-1结尾的规则,涵盖仅设头下标、仅设尾下标及同时设置头尾下标的三种截取模式。此外,还介绍了引入步长参数实现隔值截取的方法,并通过完整代码示例展示具体输出结果,帮助开发者准确掌握列表数据提取技巧。
本文详解如何在Scrapy框架中集成Selenium以解决动态加载数据的爬取难题。通过配置Spider与下载中间件,利用浏览器对象执行页面滚动并获取渲染后的HTML源码,成功抓取网易新闻多个版块的动态内容。文章提供了完整的代码实现、配置步骤及注意事项,帮助开发者高效处理复杂动态网页。
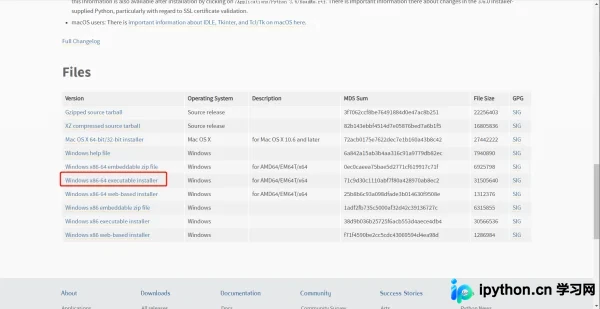
本文提供Windows系统下安装Python 3.6.0的完整图文指南。从官网下载amd64安装包开始,详细讲解如何勾选Add Python 3.6 to PATH、选择自定义安装路径及用户权限。最后通过cmd命令行输入python -V验证安装是否成功,确保开发环境配置无误。
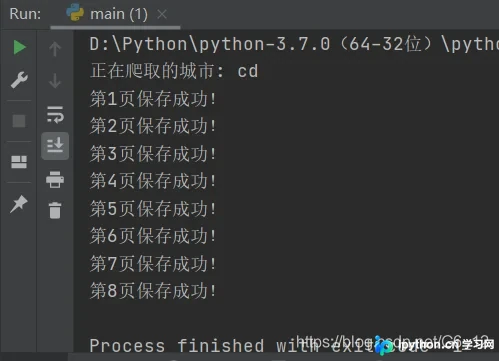
本文详细介绍如何利用Python的urllib.request库实现贝壳找房房源数据的自动化爬取。教程涵盖请求库引入、URL构建、随机代理IP配置及反爬策略(如随机休眠),并通过完整代码示例演示如何批量保存不同城市的多页网页数据,为后续大数据分析提供数据源。
本文详细讲解在Python中如何为数据添加标签、根据条件判断标签值以及从HTML结构中获取特定标签内容。通过Pandas的merge与apply方法实现复杂逻辑打标,并结合lxml库利用XPath表达式精准提取网页元素属性,适用于数据分析和网络爬虫场景。
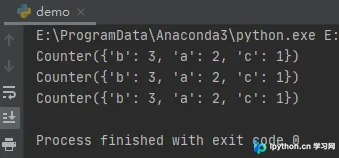
本文详细解析Python中collections.Counter容器的使用方法。涵盖三种初始化方式、空Counter的update填充、字典式访问及elements()迭代器的特性。重点介绍most_common()统计高频元素,并结合英文文档统计示例展示其在NLP中的应用。最后演示Counter容器间的加减交集并集等算术运算,帮助开发者高效处理可散列对象的频率统计。
本文系统梳理Python内置logging模块的核心功能,详解CRITICAL至DEBUG五级日志的适用场景与默认行为。通过basicConfig函数演示控制台与文件输出的配置方法,包括格式定制、文件名管理及日志轮转策略。结合代码示例展示如何记录程序异常堆栈信息,帮助开发者实现生产环境下的精细化日志管理。
本文介绍如何在 Python3 中使用 goto-statement 库实现类似 C 语言的代码跳转功能,解决异常处理中重复代码的问题。通过安装库、定义标签与跳转指令,演示具体代码示例及输出结果。同时补充 Pycharm 中查看代码浏览历史、快速返回上一函数位置的实用技巧,提升开发效率。
本文详解NumPy中np.nditer迭代器的用法,重点解析flags参数中的multi_index选项,用于获取多维数组元素的索引元组。通过示例说明如何结合op_flags=['readwrite']实现读写操作,并对比f_index、order参数对迭代顺序的影响,帮助开发者高效处理多维数组遍历。