

NumPy中np.nditer与flags=[multi_index]用法详解

本文详解NumPy中np.nditer迭代器的用法,重点解析flags参数中的multi_index选项,用于获取多维数组元素的索引元组。通过示例说明如何结合op_flags=['readwrite']实现读写操作,并对比f_index、order参数对迭代顺序的影响,帮助开发者高效处理多维数组遍历。
在研读CS231n课程代码时,遇到了这样一行代码片段。
it = np.nditer(x, flags=['multi_index'], op_flags=['readwrite'])
经查阅资料发现,np.nditer是NumPy数组内置的迭代器工具。此处通过一个简单示例来演示np.nditer的具体使用方法。
首先构建一个3行4列的矩阵。
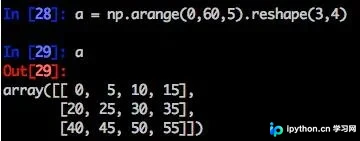
接着输入相应的命令。

参数flags=['multi_index']表示对数组a启用多重索引功能,具体含义可参考后续代码示例。
参数op_flags=['readwrite']表示该迭代器不仅允许读取数组a的内容,还允许写入修改,即在创建迭代器时已设定好读写权限。
接下来进行迭代测试。
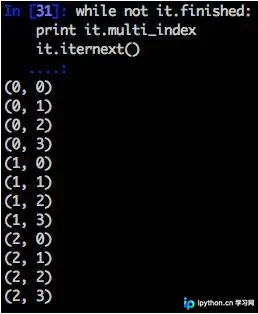
通过print语句输出it.multi_index,可以查看当前元素的索引值,输出结果均显示为索引坐标。
it.iternext()用于推进到下一次迭代。若省略此语句,输出结果将始终停留在初始索引(0, 0)处。
补充说明:迭代器初始化语句为it = np.nditer(x, flags=['multi_index'], op_flags=['readwrite'])。
在分析cs221n相关代码时,曾遇到一行类似的代码。
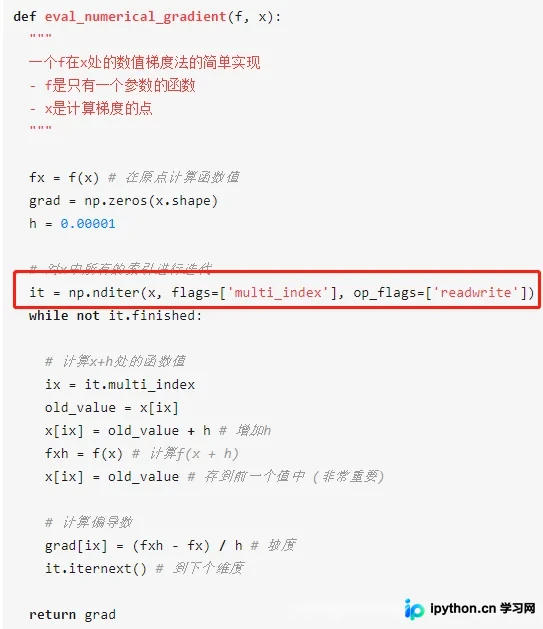
it = np.nditer(x, flags=['multi_index'], op_flags=['readwrite'])
对np.nditer()函数进行详细解析。
class np.nditer()
主要参数说明如下:
op:接收ndarray或array_like序列,指定需要迭代的数组。
flags:字符串序列,可选参数,用于控制迭代器的行为模式。
“buffered”:在必要时启用缓冲机制。
“c_index”:启用以C语言顺序跟踪索引。
“f_index”:启用以Fortran语言顺序跟踪索引。
“multi_index”:启用以多重索引或每个迭代维度一个索引元组的形式跟踪索引。
“common_dtype”:将所有操作数转换为公共数据类型,并在必要时进行复制或缓冲。
“copy_if_overlap”:使迭代器判断读操作数是否与写操作数重叠,必要时进行临时复制以避免冲突。某些情况下可能出现误报(即不必要的复制)。
“delay_bufalloc”:延迟缓冲区分配,直到调用reset()方法。这允许“allocate”操作数在值复制到缓冲区之前进行初始化。
“external_loop”:使返回的值成为包含多个值的一维数组,而非零维数组。
当同时使用“buffered”和“external_loop”时,“grow_inner”允许值数组大小大于缓冲区大小。
“ranged”:允许将迭代器限制为iterindex值的子范围。
“refs_ok”:允许迭代引用类型,例如对象数组。
“reduce_ok”:允许迭代广播的“readwrite”操作数,也称为缩减操作数。
“zerosize_ok”:允许迭代器的size为零。
op_flags:字符串列表,可选参数。这是针对每个操作数的标志列表。至少必须指定“readonly”、“readwrite”或“writeonly”之一。
“readonly”:表示仅读取操作数。
“readwrite”:表示对操作数进行读取和写入。
“writeonly”:表示仅写入操作数。
“no_broadcast”:阻止操作数被广播。
“contig”:强制操作数数据保持连续。
“aligned”:强制操作数数据对齐。
“nbo”:强制操作数数据以本机字节顺序排列。
“copy”:允许在需要时创建临时只读副本。
“updateifcopy”:允许在需要时使用临时读写副本。
若在op参数中指定为None,“allocate”将导致分配新数组。
“no_subtype”:阻止“allocate”操作数使用子类型。
“arraymask”:表示此操作数是在写入设置了“writemasked”标志的操作数时用于选择元素的掩码。迭代器不强制执行此操作,但当从缓冲区写回数组时,仅复制由该掩码指示的元素。
“writemasked”:表示仅写入所选“arraymask”操作数为True的元素。
“overlap_assume_elementwise”:可用于标记仅在迭代器顺序中访问的操作数,以便在存在“copy_if_overlap”时允许采用较不保守的复制策略。
op_dtypes:dtype或tuple,可选参数。指定操作数所需的数据类型。如果启用了复制或缓冲,数据将转换为原始类型或从原始类型转换。
order:{‘C', ‘F', ‘A', ‘K'},可选参数。
控制迭代顺序。‘C'表示C语言顺序,‘F'表示Fortran顺序,‘A'表示若所有数组均为Fortran连续则采用‘F'顺序,否则采用‘C'顺序,‘K'表示尽可能接近数组元素在内存中的出现顺序。这也影响“allocate”操作数的元素内存顺序,因为它们被分配为与迭代顺序兼容。默认为‘K'。
casting:{‘no', ‘equiv', ‘safe', ‘same_kind', ‘unsafe'},可选参数。控制进行复制或缓冲时可能出现的数据转换类型。建议不要将此设置为“unsafe”,因为它可能对累积产生不利影响。
“no”:表示完全不应强制转换数据类型。
“equiv”:表示仅允许更改字节顺序。
“safe”:表示仅允许保留值的强制转换。
“same_kind”:意味着仅允许安全的类型或类型内的类型转换,如float64到float32。
“unsafe”:表示可以进行任何数据转换。
op_axes:整数列表列表,可选参数。如果提供,则是每个操作数的int或None列表。操作数的轴列表是从迭代器的维度到操作数的维度的映射。可以为条目放置值-1,从而将该维度视为“newaxis”。
itershape:整数元组,可选参数。迭代器的理想形状。这允许“allocate”具有由op_axes映射的维度的操作数不对应于不同操作数的维度,以获得该维度不等于1的值。
buffersize:int,可选参数。启用缓冲时,控制临时缓冲区的大小。设置为0表示使用默认值。
示例1:
默认情况下,nditer将视待迭代遍历的数组为只读对象(read-only)。为了在遍历数组的同时实现对数组元素值的修改,必须指定op_flags=['readwrite']模式。
基本迭代参数flag=['f_index'/'multi_index'],可输出自身坐标it.index/it.multi_index。
“multi_index”表示对x进行多重索引处理。
print("%d <%s>" % (it[0], it.multi_index))表示输出元素的索引,可以看到输出的结果都是index。
下面分别举例子说明:
import numpy as np
x = np.arange(6).reshape(2,3)
it = np.nditer(x, flags=['multi_index'], op_flags=['readwrite'])
while not it.finished:
 print("%d <%s>" % (it[0], it.multi_index))
 it.iternext()
# 0 <(0, 0)>
# 1 <(0, 1)>
# 2 <(0, 2)>
# 3 <(1, 0)>
# 4 <(1, 1)>
# 5 <(1, 2)>
it.iternext()表示进入下一次迭代,如果不加这一句的话,输出的结果就一直都是0 <(0, 0)>且不间断地输出。
0 <(0, 0)>
0 <(0, 0)>
0 <(0, 0)>
0 <(0, 0)>
0 <(0, 0)>
0 <(0, 0)>
......
......
示例2:
import numpy as np
x = np.arange(6).reshape(2,3)
# 单维迭代
it = np.nditer(x, flags=['f_index'])
while not it.finished:
    print("%d <%s>" % (it[0], it.index))
    it.iternext()
# 0 <0>
# 1 <2>
# 2 <4>
# 3 <1>
# 4 <3>
# 5 <5>
import numpy as np
x = np.arange(6).reshape(2,3)
# 多维迭代
it = np.nditer(x, flags=['multi_index'])
while not it.finished:
    print("%d <%s>" % (it[0], it.multi_index))
    it.iternext()
# 0 <(0, 0)>
# 1 <(0, 1)>
# 2 <(0, 2)>
# 3 <(1, 0)>
# 4 <(1, 1)>
# 5 <(1, 2)>
示例3:
import numpy as np
x = np.arange(6).reshape(2,3)
# 列顺序迭代
it = np.nditer(x, flags=['f_index'], order='F')
while not it.finished:
    print("%d <%s>" % (it[0], it.index), end=' | ')
    it.iternext()

# 0 <0> | 3 <1> | 1 <2> | 4 <3> | 2 <4> | 5 <5> |
import numpy as np
x = np.arange(6).reshape(2,3)
# 行顺序迭代
it = np.nditer(x, flags=['f_index'], order='C')
while not it.finished:
    print("%d <%s>" % (it[0], it.index), end=' | ')
    it.iternext()

# 0 <0> | 1 <2> | 2 <4> | 3 <1> | 4 <3> | 5 <5> |
以上为个人经验,希望能给大家一个参考,也希望大家多多支持本站。如有错误或未考虑完全的地方,望不吝赐教。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









