

Python爬虫实战:使用Scrapy与urllib爬取百度图片
本文详解Python环境下Scrapy框架的安装配置及常见错误解决,并通过两个实例演示如何使用urllib和re模块爬取静态网页图片及处理百度图片滚动加载的反爬虫机制,提供完整代码与注意事项。
2026-10-13
25

本文详解Python环境下Scrapy框架的安装配置及常见错误解决,并通过两个实例演示如何使用urllib和re模块爬取静态网页图片及处理百度图片滚动加载的反爬虫机制,提供完整代码与注意事项。
本文分析Python多线程程序中频繁出现的[Errno 24] Too many open files错误。该错误通常由系统默认的文件描述符限制(如1024)低于程序需求引起。通过修改/etc/security/limits.conf文件并重新登录,可将限制提升至更高数值(如10240),从而解决高并发扫描时的资源耗尽问题。
本文系统梳理Python面向对象编程核心机制,涵盖类与实例定义、命名规范、新旧式类区别、self参数原理、__init__初始化逻辑、绑定与非绑定方法差异、类与实例属性管理、双下划线私有化实现及__slots__内存优化策略。通过具体代码示例解析关键概念,帮助开发者深入理解Python对象模型并提升代码规范性与性能。
本文详解Python中字符串使用单引号、双引号及三引号的规则。重点解析如何在字符串内包含引号字符,通过反斜杠进行转义的具体写法,以及利用print函数区分字符串表示与显示值的差异。同时涵盖包含特殊子串时的replace替换操作注意事项,帮助开发者避免常见语法错误。
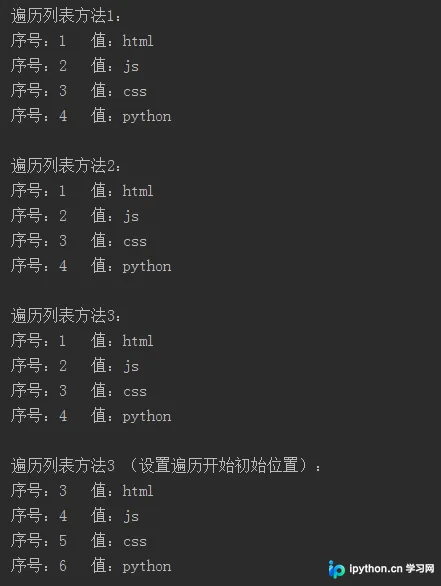
本文详细介绍在Python中遍历列表并同时获取索引与值的三种常用方法。通过对比for循环结合index、range以及内置enumerate函数的实现方式,重点解析enumerate函数的用法及其起始参数设置,帮助开发者提升代码效率与可读性。
本文详解Django中logging模块的配置方法,涵盖Logger、Handler、Formatter和Filter四大核心组件的工作流程。通过解析settings中的LOGGING配置,介绍如何设置控制台、文件及邮件通知处理器,并强调开启SMTP服务及权限管理的重要性,帮助开发者实现安全的线上日志监控。
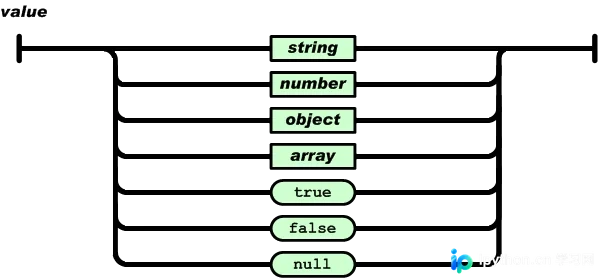
本文详解Python中JSON数据的编码与解码方法,重点介绍json.dumps、loads及文件读写函数。针对复杂数据类型,深入解析如何通过object_hook参数和自定义函数实现Python对象与JSON字典的双向转换,涵盖类实例化与属性映射的具体实现逻辑。
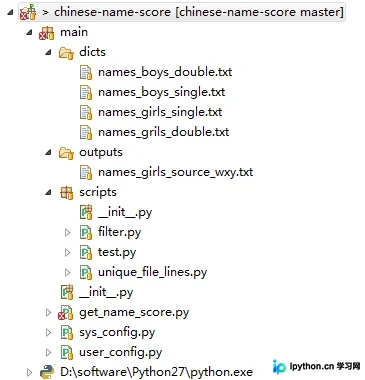
本文介绍一个使用Python编写的宝宝起名程序,通过爬虫自动提交表单获取指定网站的八字与五格评分。支持自定义家谱限定字、扩充词库,并批量生成带评分的名字列表。程序基于urllib2和BeautifulSoup4实现,提供配置示例与运行结果,旨在为家长提供一份结合传统命理与个性化限制的参考名单。
本文详细对比了Python 2与Python 3在版本迭代、函数接口及字符编码处理上的核心差异。重点解析了print函数变更、第三方库支持现状,以及Python 3中str与bytes类型的明确分离机制,帮助开发者理解从Python 2迁移至Python 3的技术要点与编码优化逻辑。
本文深入讲解Python Pandas库在数据清洗中的核心操作。涵盖merge函数的多种连接方式(inner, outer, left, right)及列名指定;介绍combine_first处理重叠数据的方法;详解数据重塑与轴向旋转;演示删除重复行、替换值及分段统计(cut/qcut);最后解析随机排列与采样技巧,助力高效数据预处理。
本文详解Python中SyntaxError: non-keyword arg after keyword arg错误的成因,指出在函数定义中*arg与**kwargs的顺序至关重要。正确做法是将*arg置于**kwargs之前,否则触发语法报错。文章提供代码示例及修正方案,帮助开发者快速定位并解决此类参数传递问题。
本文介绍在 Python 3 中解决 MySQLdb 不支持的问题。由于 MySQLdb 仅支持 Python 2.x,Python 3 环境下推荐使用 pymysql 作为替代。针对 Django 默认调用 MySQLdb 导致的 ImportError,通过在 __init__.py 中添加 pymysql.install_as_MySQLdb() 实现兼容,确保项目正常运行。