

Python解决中文字符串比较为False的问题:UTF-8与UTF-8-SIG编码差异

发布时间:2026-10-13| 6人浏览过
本文分析Python中两个看似相等的中文字符串比较返回False的原因。通过chardet库检测发现,差异源于文件编码格式不同:一个为UTF-8-SIG(带BOM),另一个为UTF-8。解决该方法是将文件保存为UTF-8无BOM格式,从而确保字符串编码一致,使比较结果正确返回True。
在Python中,判断两个内容相同的中文时字符串可能返回False。即使将两个待比较字符串的Unicode编码均设置为“utf-8”,问题依然存在。具体原因分析如下:
1. 首先,需要查看待比较的两个字符串的实际编码格式,执行以下命令:
import chardet
......
string_code = chardet.detect(string_word)
对比两个字符串的编码检测结果,如下图所示:
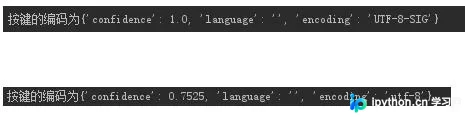
结果显示,一个字符串的编码格式为“UTF-8-SIG”,而另一个为“utf-8”。由于两者的编码格式不一致,导致比较结果为不相等。
出现“UTF-8-SIG”编码格式的原因是,文件在存储时以UTF-8格式(带BOM)保存。若将文件以UTF-8无BOM格式存储,读取出的数据编码格式将自动变为“utf-8”。
2. 将文件以UTF-8无BOM格式重新保存后,再次比较两个相等的字符串,返回值变为True,即判定两个字符串相等。
以上关于Python判断中文字符串是否相等的实例分享完毕,希望能提供有效参考,欢迎支持本站。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









