

Python技巧:使用命名元组(namedtuple)优化字典替代方案
本文介绍在Python中如何利用命名元组(namedtuple)替代字典存储结构化数据。通过对比普通元组与命名元组的用法,详解如何为元组元素赋予语义化名称,从而解决索引取值晦涩难懂的问题,提升代码的可读性与维护性。
2026-10-13
20

本文介绍在Python中如何利用命名元组(namedtuple)替代字典存储结构化数据。通过对比普通元组与命名元组的用法,详解如何为元组元素赋予语义化名称,从而解决索引取值晦涩难懂的问题,提升代码的可读性与维护性。
本文介绍如何在Python中实现指定递归深度并忽略特定目录的文件查找功能。通过自定义函数,解决默认递归导致的最大深度报错问题,支持灵活设置查找层级和排除目录列表,适用于不同项目结构下的文件定位需求。
本文提供Python递归遍历指定目录及其所有子目录下文件的完整代码示例。通过os.listdir结合递归调用实现文件路径收集,并展示如何对获取的文件列表进行正则过滤筛选特定文件,适用于批量文件处理场景。
本文介绍如何在Python中按名称顺序读取文件夹下的文件。通过os.listdir获取文件列表并使用sort()排序,可确保按字母或数字顺序处理文件。代码示例展示了路径拼接与遍历过程,适用于需要按序处理文件的场景。
本文详解Python3中一组数值的归一化处理,以1为最大值、0为最小值进行百分比换算。通过求最大最小值差值、减最小值、除以差值三步实现。重点展示利用NumPy对矩阵每列进行归一化的完整代码,包含autoNorm函数实现及示例输出,适用于数据预处理场景。
本文详细介绍利用Python和KNN算法实现手写数字识别的完整流程。内容涵盖数据读取、Max-Min及L2范数归一化方法、基于余弦相似度的最近邻搜索策略,以及使用OpenCV进行图像预处理。同时针对识别率低的问题,分析了图像缩放、二值化及笔画粗细对结果的影响,并提供了相应的优化建议与OpenCV环境配置指南。
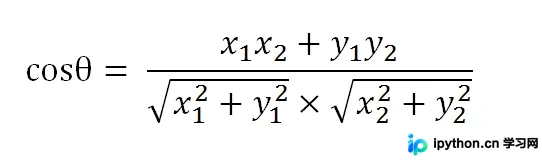
本文介绍如何使用Python语言批量修改文件夹内的文件名称。通过遍历指定目录下的文件列表,结合os模块的rename函数,实现将任意命名的文件按顺序重命名为指定格式(如00.txt至09.txt)。该方法适用于需要整理大量无序文件的场景,代码简洁且易于扩展。
本文介绍使用NumPy对矩阵进行归一化的具体实现方法。核心在于将均值、最大值和最小值的计算结果预先存储为变量,避免在循环中重复计算,从而显著提升处理速度。文章提供了简洁的五行代码示例及关键注意事项,适用于需要高效数据预处理的Python开发场景。
本文详细解析数据归一化的核心概念及其必要性,包括加速梯度下降与提升模型精度。重点介绍线性归一化、标准差标准化及非线性归一化(如Log变换)三种类型,并提供基于Python NumPy的具体实现代码,帮助开发者掌握不同场景下的数据预处理技巧。
在使用pandas读取CSV文件时,常因索引列处理不当出现“Unnamed: 0”列。本文介绍利用列索引重命名或drop方法处理此类冗余列的技巧,并汇总了DataFrame选取行与列的多种常用方法,包括切片、索引器及特定行/列获取函数,帮助提升数据处理效率。
本文深入解析 Python 中日期与时间数据的处理机制,涵盖 datetime 模块基础、字符串与日期互转方法及 Pandas 的 to_datetime 应用。重点讲解以时间戳为索引的 Series 和 DataFrame 的构建、算术对齐、高级切片技巧,以及针对重复时间索引数据的聚合处理方案,助力高效进行时间序列数据分析。
本文介绍如何使用 numpy.std() 函数计算矩阵的标准差。通过示例展示了全局标准差、按列(axis=0)和按行(axis=1)计算标准差的具体用法及结果,帮助开发者快速掌握该函数的应用。