Python logging模块重复记录日志问题的原因与解决方案
本文深入解析Python logging模块中常见的重复记录日志问题。通过示例代码展示因未移除Handler导致的日志重复现象,并提供四种有效解决方案,包括移除Handler、判断已有Handler及优雅的处理方式,帮助开发者快速定位并修复日志异常。
2026-10-13
21

本文深入解析Python logging模块中常见的重复记录日志问题。通过示例代码展示因未移除Handler导致的日志重复现象,并提供四种有效解决方案,包括移除Handler、判断已有Handler及优雅的处理方式,帮助开发者快速定位并修复日志异常。
本文介绍Python中跳过文件第一行读取内容的两种实现方式。传统方法通过行号判断过滤首行,但存在额外时间开销;推荐做法是利用itertools模块中的islice函数,通过切片机制直接定位起始位置,从而提升读取效率并简化代码逻辑。
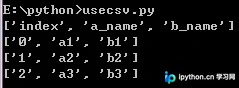
本文介绍Python中如何使用csv模块进行CSV文件的读写操作。重点解析写入时因换行符导致的多余空行问题,并提供通过设置newline=''参数的解决方案。包含完整的写入与读取代码示例,帮助开发者快速掌握Python处理CSV数据的核心技巧。
本文介绍如何利用Python读取保存训练ground_truth的文本文件,通过splitlines()方法逐行获取图片标签数据,并按空格分割提取边界框坐标。
本文介绍Python实现网页截图的两种方法。方法一利用PyQt4的QtWebKit组件,通过QWebView加载页面并保存为图片,需注意字体像素警告及32/64位安装包下载。方法二使用Selenium库驱动Firefox浏览器,需配合geckodriver.exe使用,并提供了相应的pip安装命令及路径配置说明。
本文介绍 Python 中读取文件并替换字段的三种常见方法。第一种通过新建文件写入实现字符串替换;第二种利用 re 模块进行正则替换并输出到新文件;第三种演示如何在原文件中通过 seek 定位指针实现原地修改,同时指出长度不一致时的潜在问题。
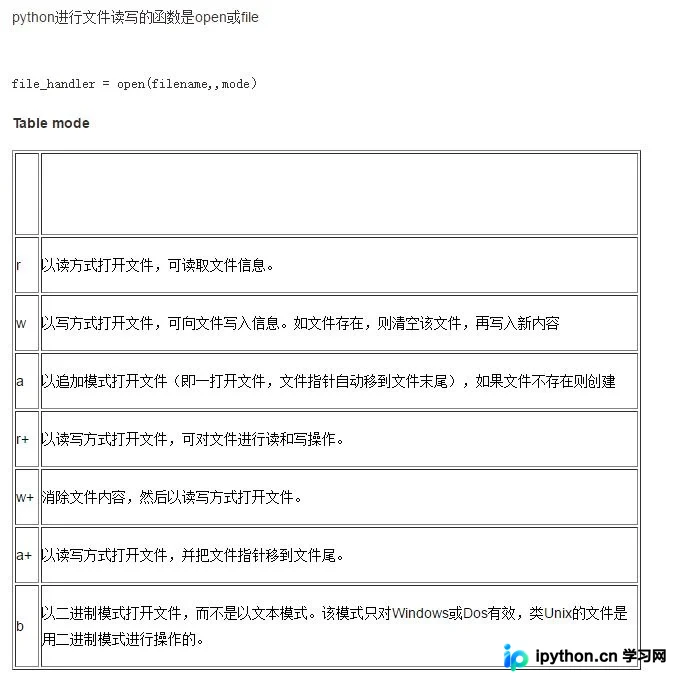
本文介绍在 Python 中如何高效地按行读取文件内容,并通过列表索引修改特定行的数据,最后将更新后的内容写回原文件。主要涉及 open 函数的读写模式、readlines 获取行列表以及 writelines 批量写入的操作流程,适用于需要局部更新文本文件的场景。
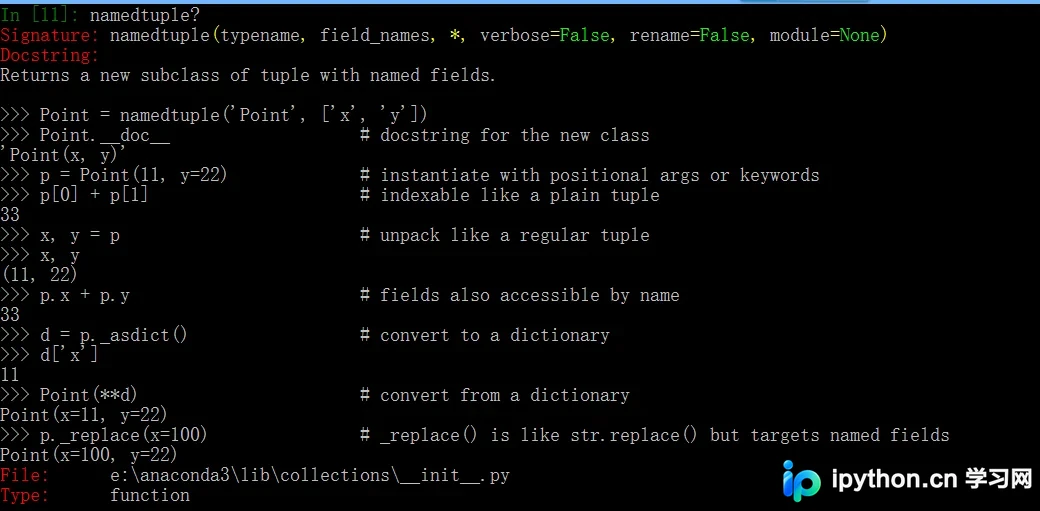
本文详细介绍Python中元组的创建方法及元素命名技巧。通过对比单元素元组的括号写法,引出对元组元素进行命名的两种常用方式:一是通过解包索引值赋予变量名,二是利用collections模块中的namedtuple类创建具名元组。文章结合代码示例,演示了如何通过属性访问方式操作namedtuple实例,帮助读者提升代码可读性与维护性。
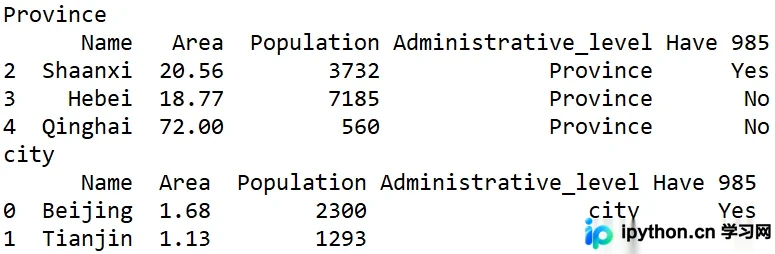
本文介绍Python中pandas库DataFrame的groupby分组功能。通过创建包含行政级别和985高校信息的示例数据,演示如何按单个属性(行政级别)及多个属性(行政级别与是否有985高校)进行分组聚合。代码展示了groupby的基本用法及结果输出,帮助开发者掌握数据分组的核心操作。
本文详细介绍了在Python中实现字符串翻转的五种不同方法。内容涵盖传统的循环与列表反转方式,以及利用切片、内置函数和高阶函数reduce实现的简洁写法。通过对比分析各方法的代码结构与执行逻辑,帮助开发者根据实际需求选择最合适的字符串反转方案,提升代码效率与可读性。
本文详细介绍在Python 3.7环境中安装OpenCV库的方法。针对直接pip安装失败的情况,提供从UCI网站下载对应cp37版本whl文件的步骤,并通过命令行指定路径完成本地安装。同时包含解决平台不支持错误的排查代码,确保64位或32位系统用户能顺利配置环境。
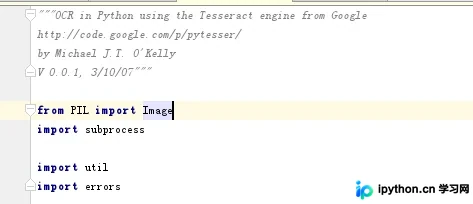
本文详细介绍在Python2环境下利用pytesser和PIL库实现图片文本识别的方法。涵盖从pytesser下载、解压安装到修改__init__.py文件的关键配置,以及PIL库的安装避坑指南。通过具体代码示例,指导用户解决常见报错,完成图片识别测试,并分析该方法的局限性及优化建议。