

Python爬虫urllib异常处理详解:URLError与HTTPError实战
本文详解Python爬虫中urllib模块的异常处理机制。重点解析URLError(主机错误)与HTTPError(路径或参数错误)的区别与捕获顺序,通过具体代码实例演示如何构建健壮的爬虫程序,确保在网络请求失败时能正确识别错误类型并执行相应处理逻辑。
2026-10-15
8

本文详解Python爬虫中urllib模块的异常处理机制。重点解析URLError(主机错误)与HTTPError(路径或参数错误)的区别与捕获顺序,通过具体代码实例演示如何构建健壮的爬虫程序,确保在网络请求失败时能正确识别错误类型并执行相应处理逻辑。
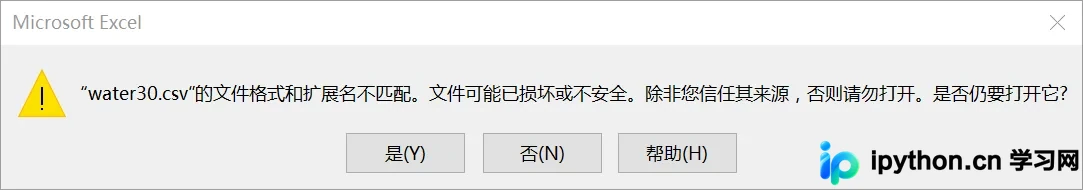
本文记录Python中读取CSV文件时常见的两个错误:CParserError提示字段数不匹配以及line contains NULL byte。通过对比直接修改后缀与“另存为”不同编码格式的操作,分析发现Excel另存为ANSI编码可解决此类解析问题。同时提供了csv模块与pandas模块对应的修正代码示例,供遇到类似编码导致解析失败的场景参考。
本文详解Python爬虫中如何使用lxml库结合XPath技术高效提取网页局部内容。涵盖XPath基础语法、谓词与属性查询,以及lxml库在PyCharm中的安装配置。通过本地文件解析、服务器响应处理及百度关键词搜索等完整代码示例,展示从数据抓取到节点定位的全过程,帮助开发者快速掌握精准数据提取技巧。
本文介绍Python中获取字典关键字与值的两种主要方式。通过values()方法可直接提取所有值,而items()方法则返回键值对元组。文章还对比了使用普通字典与defaultdict构建键值列表的两种代码实现,展示了从文件列表生成分类字典的实际应用案例。
本文深入解析Python中类的私有属性与公共属性。通过双下划线前缀定义私有属性,Python会在内部进行名称改写(Name Mangling)以限制访问。文章展示了直接访问私有属性及子类继承时的异常行为,并对比了单下划线与双下划线的区别,帮助开发者理解Python的封装机制。
本文详细介绍pandas中Series对象的三种创建方式,包括通过字典、一维数组和标量值构建Series,并深入解析Series的常用操作方法,如创建、追加、删除、修改及查询。文章通过具体代码示例展示了不同场景下的正确用法,特别是嵌套Series追加时的常见错误与修正方案,帮助开发者高效掌握Series的核心功能。
本文详细介绍如何使用Python调用腾讯云实名认证接口来验证身份证与姓名的一致性。通过获取SecretId和SecretKey,构建签名并发送HTTP请求,程序可返回认证结果。若返回description为“一致”,则表明身份证与姓名匹配,认证通过;否则认证失败。
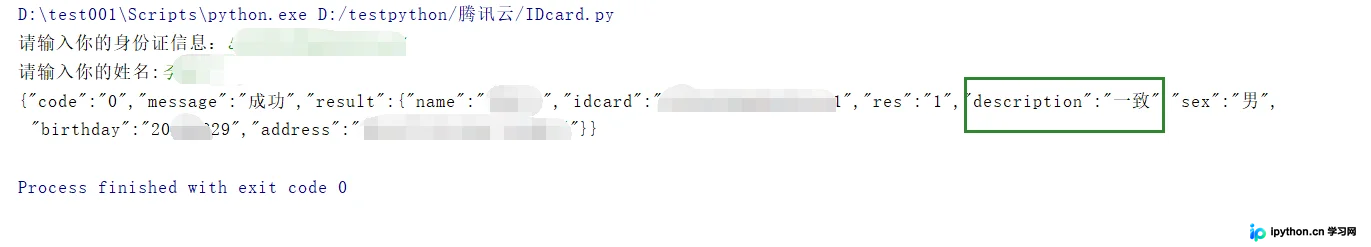
本文详细介绍在 pandas 中如何对 DataFrame 进行列和行的增删改查。涵盖通过直接赋值、assign、insert 方法添加新列,利用 concat 进行水平或垂直连接,以及使用 append 添加行的技巧。同时讲解如何根据条件筛选特定列和行,修改列值及处理缺失数据,提供完整代码示例。
本文详解如何在 Python matplotlib 中指定图像大小,通过 figsize 参数调整画布尺寸,利用 dpi 控制像素分辨率,并演示如何修改横纵坐标及图例的字体大小,解决默认图片内容压缩问题。

本文介绍如何使用Python快速批量修改大量文件名。通过结合os模块与正则表达式,实现高效去除文件名中的特定前缀或后缀。文章提供了完整的代码示例、性能分析以及目录信息获取技巧,帮助开发者解决手动重命名的低效问题,适用于处理成百上千个文件的场景。
本文详细解析Python中range()函数的三种参数形式:单参数生成从0开始的等差数列,双参数指定起始与结束值,三参数额外定义步长。通过具体代码示例展示其语法结构及在for循环中的应用,帮助开发者准确掌握整数序列生成方法。
本文详细解析Python中for循环与range函数的配合使用,重点讲解如何通过range(start, stop, step)参数控制循环步长。通过具体代码示例,展示从指定起始值、结束值及步长生成序列的方法,帮助开发者掌握高效遍历列表或生成数字序列的技巧。