Python写入大量文件时数据丢失的排查与解决方案
本文探讨Python在合并大量TXT文件时出现的写入不完整问题,即预期十万行仅写入4k多行。分析指出这可能是由于程序执行过快导致文件关闭时内容未完全落盘,或IDE显示限制造成的误解。文章提供了两种解决方案:通过flush和os.fsync强制刷新缓冲区,以及在循环中引入sleep机制确保写入完成,帮助开发者解决大文件处理中的数据完整性问题。
2026-10-13
20

本文探讨Python在合并大量TXT文件时出现的写入不完整问题,即预期十万行仅写入4k多行。分析指出这可能是由于程序执行过快导致文件关闭时内容未完全落盘,或IDE显示限制造成的误解。文章提供了两种解决方案:通过flush和os.fsync强制刷新缓冲区,以及在循环中引入sleep机制确保写入完成,帮助开发者解决大文件处理中的数据完整性问题。
本文通过实例对比Python中两种常见的文件读取方式:逐行迭代读取与readlines一次性读取。测试结果显示,逐行遍历虽然内存占用低,但耗时较长;而使用readlines将内容一次性加载至列表后处理,在速度上具有明显优势。文章提供了具体的代码实现及性能差异说明,帮助开发者根据实际需求选择高效的文件读取策略。
本文分析Python多线程爬虫中因多个线程同时读写全局变量导致的文件名覆盖问题。通过引入锁机制保护全局变量操作,确保每个线程获取唯一的文件编号,从而解决文件被重复覆盖的bug,保障多线程环境下的数据完整性。
本文解决Python循环向CSV写入数据时发生覆盖的问题。核心原因是在使用open函数时错误地使用了'w'(写入)模式,导致每次写入都清空原文件。通过将模式参数改为'a'(追加)即可实现逐行累加写入,保留历史数据。
本文介绍使用Python的OpenCV库批量将彩色图片转换为灰度图并保存的方法。通过遍历指定目录下的图片文件,利用cv2.cvtColor进行颜色空间转换,并使用cv2.imwrite保存处理后的结果,适用于图像预处理等场景。
本文详细介绍如何在Atom编辑器中配置环境以运行Python文件。涵盖Atom的安装与启动方法,重点讲解通过安装platformio-ide-terminal插件在Atom内部调用终端执行Python脚本的步骤。同时介绍了分屏功能及多文件管理技巧,帮助开发者提升编码效率,实现从编辑到执行的无缝衔接。
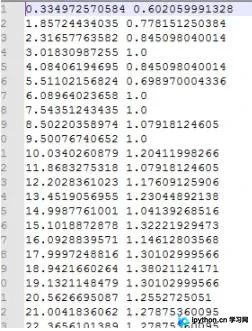
本文介绍如何使用Python生成符合Gnuplot格式要求的绘图数据。通过Python的文件写入功能,生成包含x和y坐标值的文本文件,供Gnuplot直接读取绘图。
本文介绍如何利用Python的pyheatmap库绘制热力图,并通过pyautogui和pyHook库监控鼠标点击位置。内容涵盖读取日志数据生成热力图、实时获取鼠标坐标以及监听鼠标事件的具体代码实现,适用于数据可视化与交互行为分析场景。
本文介绍了如何在Python中使用Pandas库创建一个空的DataFrame,并通过循环方式逐步添加数据。主要展示了两种初始化空DataFrame的方法:无参数初始化和指定列名初始化,以及利用append方法将新数据帧合并到现有空数据帧中,实现动态赋值。
本文介绍在Python中消除序列重复值并保持原有顺序的三种方法。首先通过集合直接去重但无法保序;其次利用生成器和集合判断实现保序去重,要求元素可哈希;最后针对字典等不可哈希对象,通过自定义key函数进行去重。
本文分享一个基于Python的大文件去重示例代码,支持GB级别数据。通过正则表达式提取词元并利用集合去重,实现高效处理。代码包含文件读取、去重逻辑及结果保存功能,适用于需要处理海量文本数据的场景。
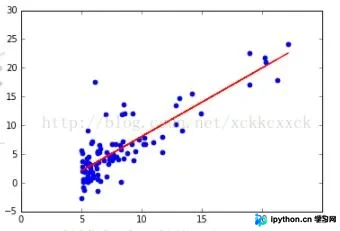
本文介绍如何利用Python的sklearn库实现单变量线性回归。通过读取数据文件,使用LinearRegression进行模型训练,并展示预测与可视化结果。重点解析fit、predict及score方法的应用,适合机器学习初学者参考。