

Python利用Scipy插值法绘制平滑曲线详解
本文介绍如何使用Python的numpy、scipy和matplotlib库绘制平滑曲线。重点讲解interp1d函数的nearest、zero、slinear、quadratic及cubic等插值方法,并区分插值与拟合的概念。通过完整代码示例,展示如何生成xnew数组并计算ynew,同时强调xnew范围需覆盖原数据且间距要小于原数据精度,以确保曲线平滑。
2026-10-13
17

本文介绍如何使用Python的numpy、scipy和matplotlib库绘制平滑曲线。重点讲解interp1d函数的nearest、zero、slinear、quadratic及cubic等插值方法,并区分插值与拟合的概念。通过完整代码示例,展示如何生成xnew数组并计算ynew,同时强调xnew范围需覆盖原数据且间距要小于原数据精度,以确保曲线平滑。
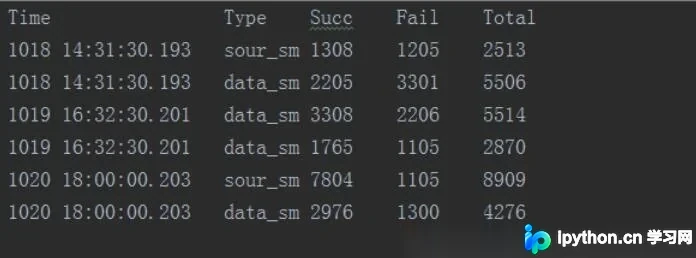
本文介绍利用Python脚本将非结构化日志数据转换为标准表格格式的方法。通过读取包含时间、类型及成功失败计数的多行文本,自动计算总和并输出为制表符分隔的CSV风格文件,适用于日志分析与数据预处理场景。
本文通过Python的scipy.optimize库,对比使用fsolve和leastsq两种方法求解非线性方程组。展示了基于初始值[1,1,1]的求解过程,两者均得到近似解[-0.70622057, -0.6, -2.5],并详细列出了残差向量值,验证了两种优化算法在解决此类问题上的有效性与结果一致性。
本文详解Django抽象基类中related_name的冲突问题及解决方案。通过在相关名称中使用%(app_label)s和%(class)s占位符,可自动生成唯一的反向关联名,避免子类字段命名冲突。同时介绍未指定related_name时的默认行为及验证机制。
本文介绍如何利用Python的requests库判断计算机是否拥有网络连接。通过安装requests第三方库,编写简单函数尝试访问百度并设置超时时间,若成功则返回真,否则捕获异常返回假。该实例代码简洁,适合初学者参考学习网络状态检测的基本方法。
本文介绍使用Python实现基于最大概率法的汉语分词方法。核心思路包括预处理语料库、按标点分割长句、生成候选词集,并利用2-gram语言模型结合加一平滑计算切分概率。通过取对数将乘法转为加法,并优化词数阈值以提高效率,最终输出概率最大的分词结果。
本文详细介绍 Django ORM 中通过 related_name 属性进行反向查询的方法。以用户与等级模型为例,对比正向查询与反向查询的代码实现,展示如何从关联模型获取主模型数据,帮助开发者高效处理数据库关系。
本文通过实际测试对比Django中ForeignKey反向查询的两种常用方式:使用_set.all()与objects.filter()。实验结果显示,在10000次查询下,filter方法耗时略少,效率更高。文章提供了完整的模型定义、数据构造及timeit测试代码,帮助开发者在SEO和性能敏感场景下做出更优选择。
本文介绍了Django中通过外键实现Model间数据互相读取的方法。以Entry、Blog和Author为例,展示了如何在Entry中获取关联的Blog和Author信息,以及如何在Blog和Author中反向查询关联的Entry集合,帮助开发者理解Django ORM的外键操作。
本文介绍如何使用Python在嵌入式开发中分割二进制文件。通过读取源文件并转换为字节数组,利用切片操作提取指定地址区间的数据(如0x0至0x4000等),并将结果写入指定目录。代码包含目录创建、文件读写及数组转换逻辑,适用于需要将Binary文件按区域拆分的场景。
本文详解Django中Model外键的两种特殊用法:自关联与引用未定义Model。针对部门上下级关系,通过设置ForeignKey参数为'self'实现自引用;针对用户与部门的相互引用,通过将目标Model名改为字符串形式解决定义顺序依赖问题。
本文详解Python中同一文件夹下不同.py文件交叉引用时出现的AttributeError错误。通过分析执行流程与sys.modules机制,指出直接import导致的问题,并提供通过__name__判断解决循环导入的有效方案。