Python使用jieba库进行中文分词与词频统计并导出Excel及TXT
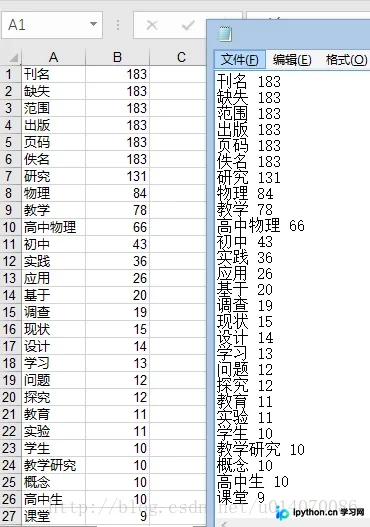
本文介绍如何利用Python的jieba库对中文论文题目进行分词与词频统计。通过安装jieba和xlwt库,读取文本文件后提取关键词并计算频率,最终将结果分别保存为txt和xls格式文件,适用于学术数据处理场景。
2026-10-13
5

本文介绍如何利用Python的jieba库对中文论文题目进行分词与词频统计。通过安装jieba和xlwt库,读取文本文件后提取关键词并计算频率,最终将结果分别保存为txt和xls格式文件,适用于学术数据处理场景。
本文详细介绍Python中两种主流的关键词提取技术:TF-IDF与TextRank。通过解析词频-逆文档频率原理及基于图排序的TextRank算法,结合jieba库实现代码示例,对比两者在提取民营企业、贷款等关键词时的权重差异,帮助开发者根据场景选择最优方案。
本文详细解析Python jieba模块的安装配置与核心用法,涵盖精确/全/搜索引擎三种分词模式、自定义词典加载、TF-IDF与TextRank关键词抽取、词性标注及词位置获取等实战操作。提供完整代码示例与性能对比,指导开发者针对NLP场景优化文本处理流程。
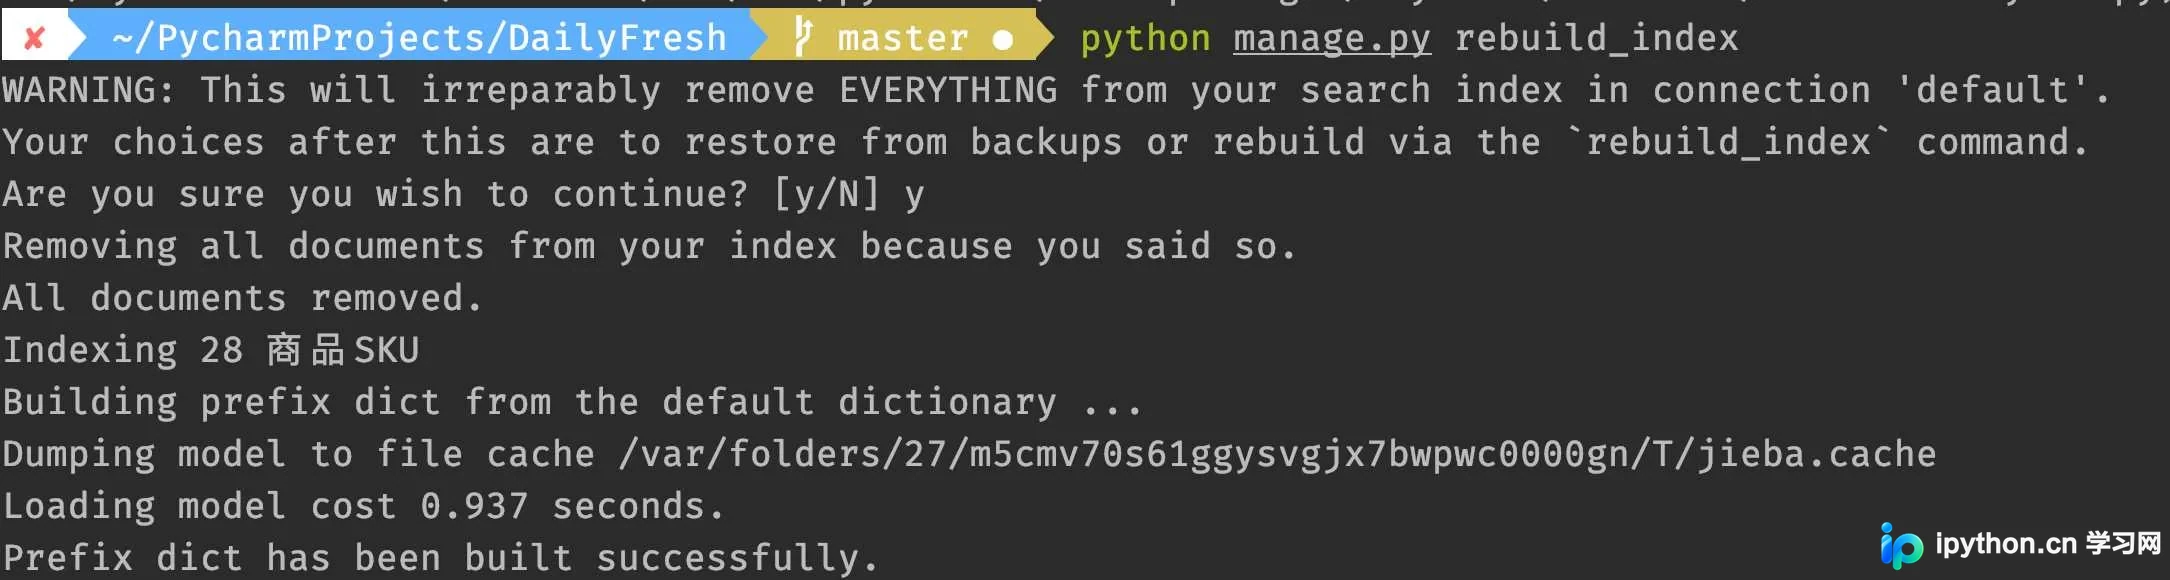
本文介绍如何在Django项目中集成Whoosh搜索引擎,并通过修改haystack源码实现Jieba中文分词。步骤包括安装依赖、创建ChineseAnalyzer、替换后端配置及重建索引,解决Django默认Whoosh不支持中文的问题。
本文介绍如何利用Python的jieba库进行中文分词,结合wordcloud库生成可视化词云。通过多线程爬取漏洞平台标题数据,统计SQL注入、命令执行等高频漏洞类型,直观展示安全趋势。
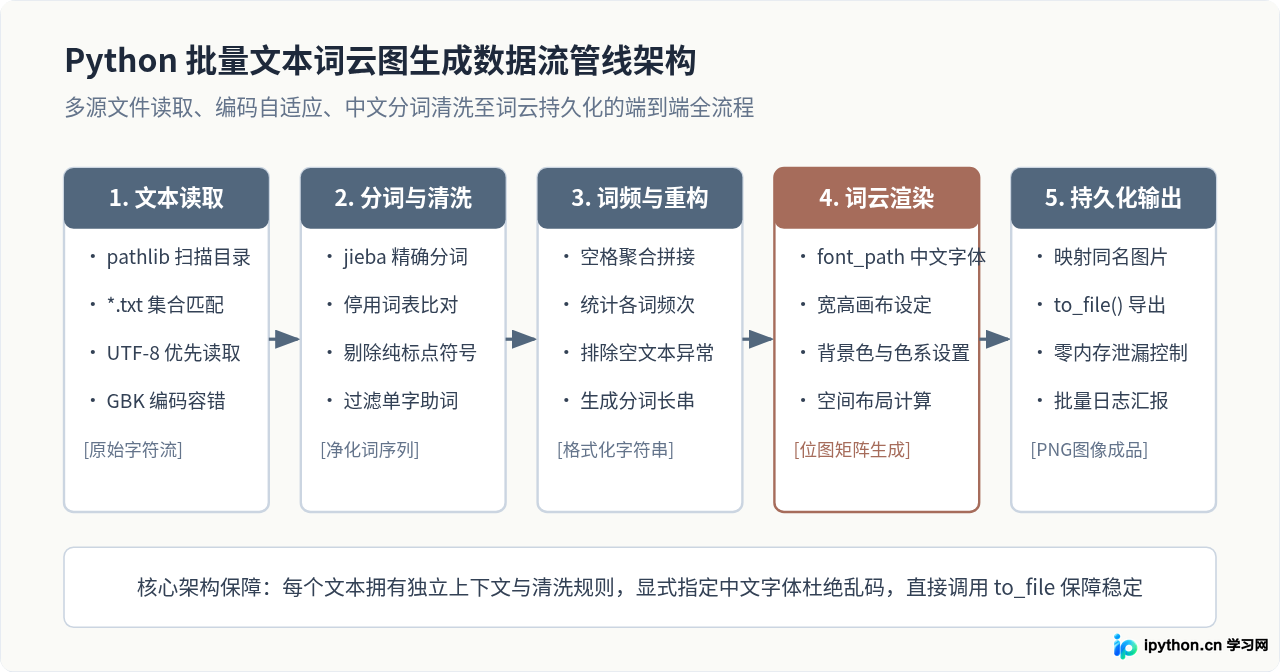
深入讲解如何使用Python自动化批量读取多个文本文件并生成对应词云图的完整方法。涵盖pathlib文件扫描、jieba分词清洗、停用词过滤、wordcloud中文字体适配及防内存泄漏的生产级实践。
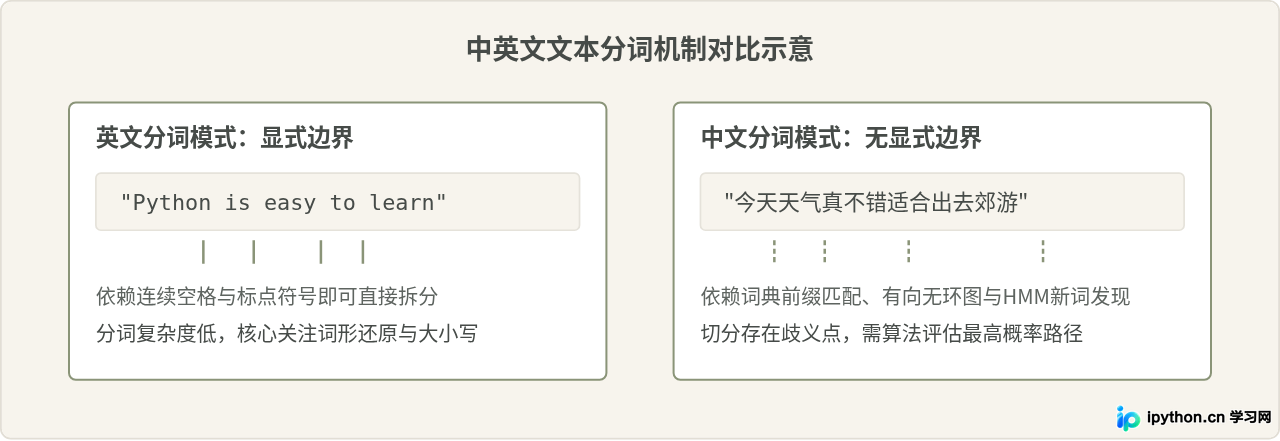
本文详细介绍如何使用Python进行中文文本数据分析,重点讲解中文分词原理、jieba库核心用法、停用词清洗以及基于collections.Counter的高频词统计实战。