Python使用jieba库进行文本分词及生成词云的方法
本文介绍如何利用Python中的jieba库进行文本分词,并结合wordcloud库绘制词云图。教程涵盖环境配置、文件读取、多余字符清理、自定义词典添加以及词云参数设置等关键步骤,通过《老九门》小说案例演示完整流程,帮助读者掌握自然语言处理的基础技能。
2026-10-13
6

本文介绍如何利用Python中的jieba库进行文本分词,并结合wordcloud库绘制词云图。教程涵盖环境配置、文件读取、多余字符清理、自定义词典添加以及词云参数设置等关键步骤,通过《老九门》小说案例演示完整流程,帮助读者掌握自然语言处理的基础技能。
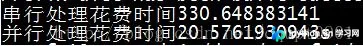
本文介绍利用Python multiprocessing模块的Pool进程池,结合jieba库对海量文本进行高效关键词提取的方法。通过对比单进程与多进程处理581行、7MB语料的耗时,验证了多进程异步处理的性能优势,并指出移除模拟延迟可显著缩短运行时间,为大规模文本分析提供实用参考。
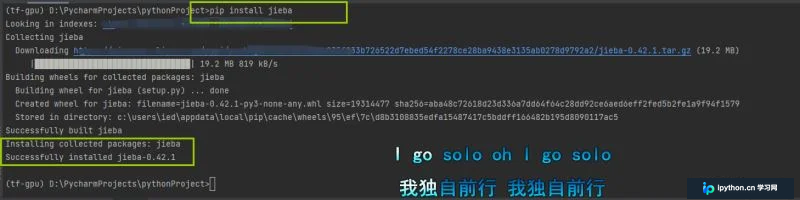
本文详细解析Python jieba模块的安装配置与核心用法,涵盖精确/全/搜索引擎三种分词模式、自定义词典加载、TF-IDF与TextRank关键词抽取、词性标注及词位置获取等实战操作。提供完整代码示例与性能对比,指导开发者针对NLP场景优化文本处理流程。
本文详细介绍Python中两种主流的关键词提取技术:TF-IDF与TextRank。通过解析词频-逆文档频率原理及基于图排序的TextRank算法,结合jieba库实现代码示例,对比两者在提取民营企业、贷款等关键词时的权重差异,帮助开发者根据场景选择最优方案。
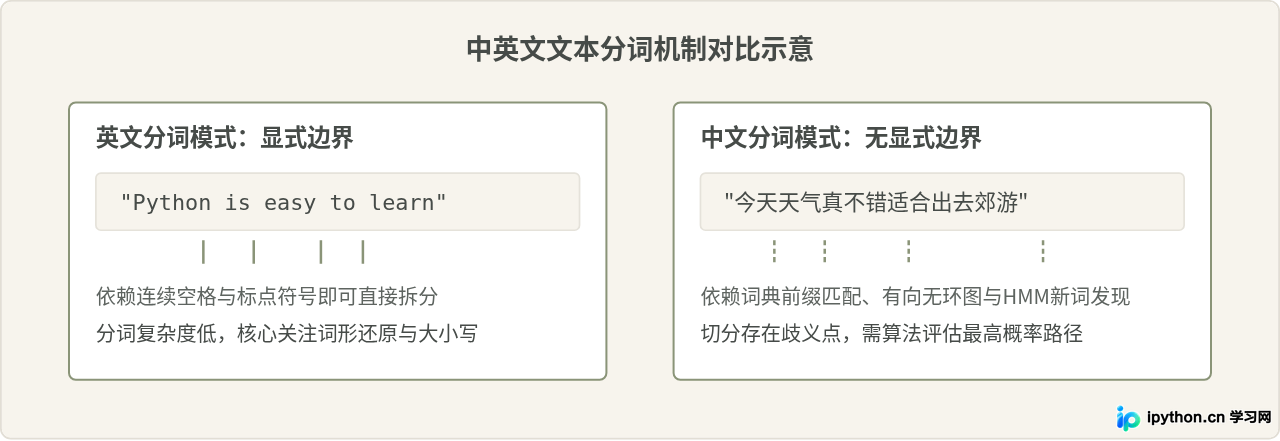
本文详解Python jieba库的中文分词原理,介绍基于词库与动态规划的算法机制。重点解析精确模式、全模式及搜索引擎模式的区别与适用场景,并通过jieba.lcut等常用函数展示代码实操,涵盖安装、自定义新词及不同模式下的分词效果对比。
本文详细介绍如何使用Python爬取CSDN全站综合热榜的100个文章标题,并通过Jieba库进行分词与词频统计。教程涵盖使用Selenium模拟浏览器滚动加载动态页面、提取HTML源码、利用Lxml解析标题以及统计高频关键词的完整流程,旨在帮助开发者掌握动态网页抓取与数据处理技巧。
本文详解如何使用Python爬取《哆啦A梦:伴我同行2》的豆瓣短评,并通过jieba库进行中文分词、去停用词处理,最终利用wordcloud库生成可视化词云图。教程涵盖requests请求、正则解析、词典动态调整及词频统计等核心步骤,适合爬虫初学者练手。
本文介绍如何利用Python的jieba库对中文文本进行精确分词,并通过Counter模块统计高频词汇。同时结合matplotlib和wordcloud库,将统计结果可视化生成词云图。文章包含完整的代码示例、运行结果分析及注意事项,适用于需要处理中文文档并提取关键信息的场景。
本文详解Python jieba库的三种核心分词模式:精确模式、全模式及搜索引擎模式,并通过代码实例展示jieba.cut()、jieba.lcut()及jieba.cut_for_search()的具体用法与输出差异。此外,文章还介绍了利用jieba.posseg模块进行词性标注及动词提取的实操方法,帮助开发者掌握中文文本处理的关键技术。
本文解决在Jupyter Notebook中运行import jieba时出现的ImportError: No module named 'jieba'错误。当常规pip install无效且conda install直接安装不可用时,通过anaconda search查找特定版本,并使用conda install -c指定频道和版本号(如0.36.2)进行安装,从而成功导入模块。
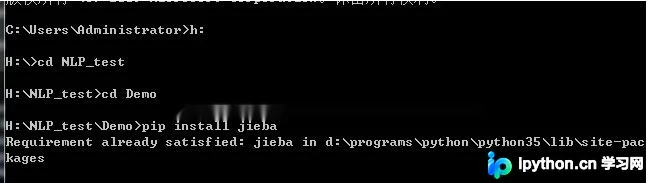
本文介绍如何利用Python的jieba库对中文论文题目进行分词与词频统计。通过安装jieba和xlwt库,读取文本文件后提取关键词并计算频率,最终将结果分别保存为txt和xls格式文件,适用于学术数据处理场景。
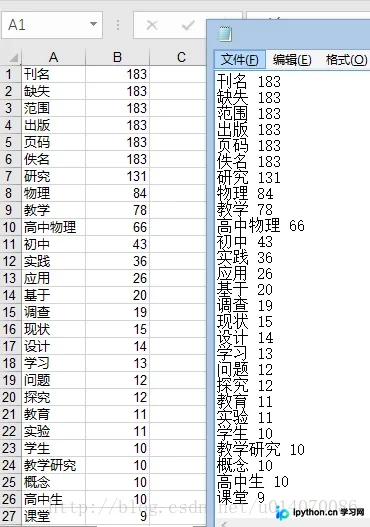
本文详细介绍如何使用Python进行中文文本数据分析,重点讲解中文分词原理、jieba库核心用法、停用词清洗以及基于collections.Counter的高频词统计实战。