Python使用xlrd读取Excel合并单元格的正确姿势与避坑指南
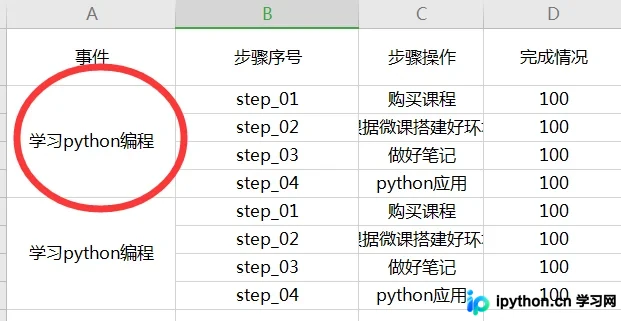
本文详解Python中利用xlrd库读取Excel合并单元格的两种方法:直接获取merged_cells属性与循环赋值法。重点解决merged_cells二次调用返回空列表及多值返回问题,指出需在open_workbook时设置formatting_info=True。
2026-10-14
9

本文详解Python中利用xlrd库读取Excel合并单元格的两种方法:直接获取merged_cells属性与循环赋值法。重点解决merged_cells二次调用返回空列表及多值返回问题,指出需在open_workbook时设置formatting_info=True。
本文系统汇总Python中文件与目录的核心操作方法。详细解析open()函数的各种模式(r/w/a等)及编码处理,涵盖write/read系列函数的使用规范。深入讲解os与os.path模块,包括工作目录获取、目录创建删除、多级目录处理及os.walk遍历技巧,附带完整代码示例,助您掌握Python文件系统编程。
本文介绍Python中PrettyTable第三方库的安装方法及基础用法。通过pip install安装后,可快速创建表格并添加行与列数据。文章演示了如何定义表头、增加数据行及字段,并展示了获取HTML字符串和指定列数据的常用方法,帮助开发者高效实现数据表格化展示。
本文介绍如何利用Cython将Python源代码转换为C语言并编译为平台特定的扩展模块。在Linux环境下生成.so文件,在Windows环境下生成.pyd文件,从而实现代码逻辑的隐藏与保护。文章涵盖基础模块加密及Flask Web应用的特殊处理方案,提供完整的操作步骤与代码示例。
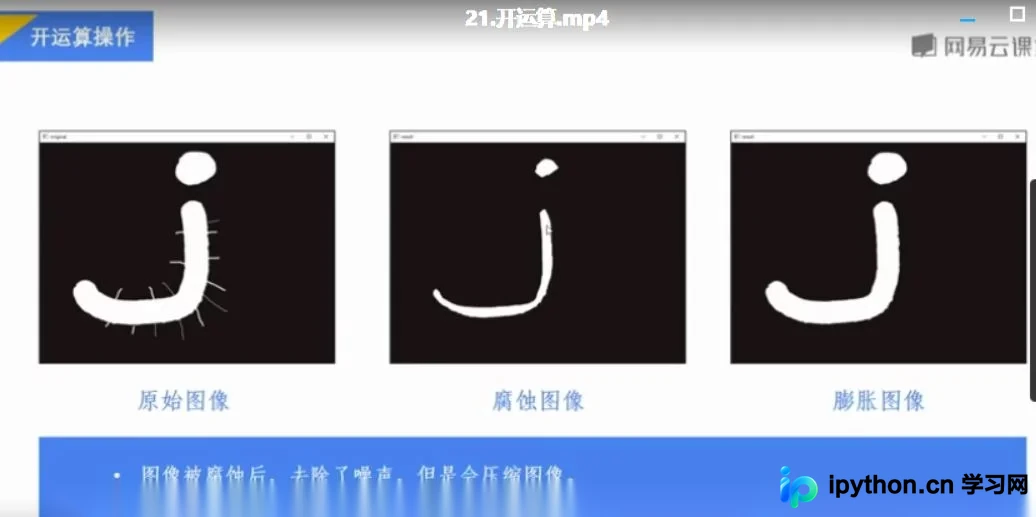
本文深入解析OpenCV中的形态学变换,涵盖开运算、闭运算及梯度运算的核心原理。通过cv2.morphologyEx()函数,结合腐蚀与膨胀操作,演示如何去除图像噪声、填补孔洞及提取边缘。附带Python代码示例与卷积核选择建议,帮助开发者掌握图像预处理关键技术。
本文详解如何在单向链表中删除指定值的节点。通过引入哨兵节点简化边界处理,并结合双指针技术高效定位目标。提供Python和C++两种语言的完整实现代码,重点解析指针移动逻辑与内存管理细节,帮助开发者掌握链表操作的核心技巧。
本文详细介绍在Python环境中清空变量的几种常用方法。针对Spyder和IPython控制台,分别讲解了使用del删除单个变量、reset清除所有变量以及clear清空命令历史的操作。此外,还提供了一种通过遍历globals()字典来批量删除自定义变量的Python脚本方案,帮助解决循环中内存积累导致程序崩溃的问题。
本文介绍在Python中如何通过字典遍历结合字符串对齐方法实现键名的格式化输出。通过计算最大键长,利用ljust、rjust和center方法分别实现左对齐、右对齐及居中对齐效果,并演示如何自定义填充字符,帮助开发者快速掌握Python字符串处理的实用技巧。
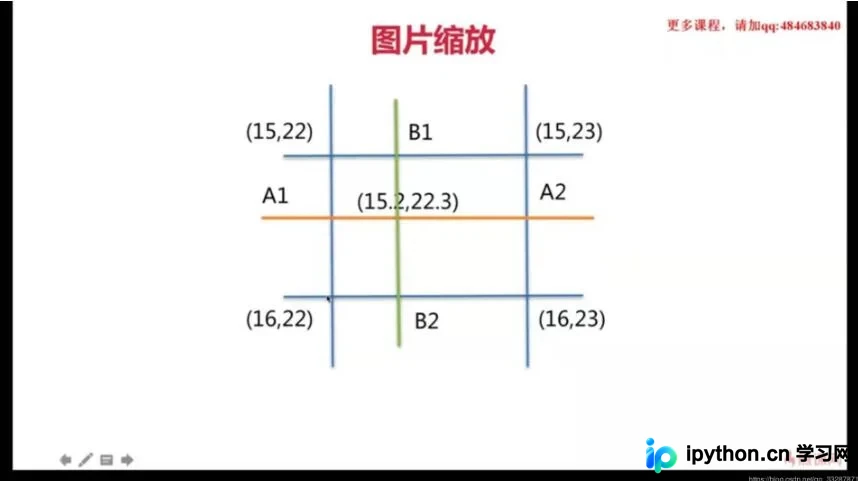
在使用OpenCV进行图像resize时,默认的双线性插值会生成新像素值,影响语义分割结果。本文介绍通过设置interpolation=cv2.INTER_NEAREST参数,利用最近邻点像素值进行缩放,确保不产生新的颜色类别值,保持语义标签的一致性。
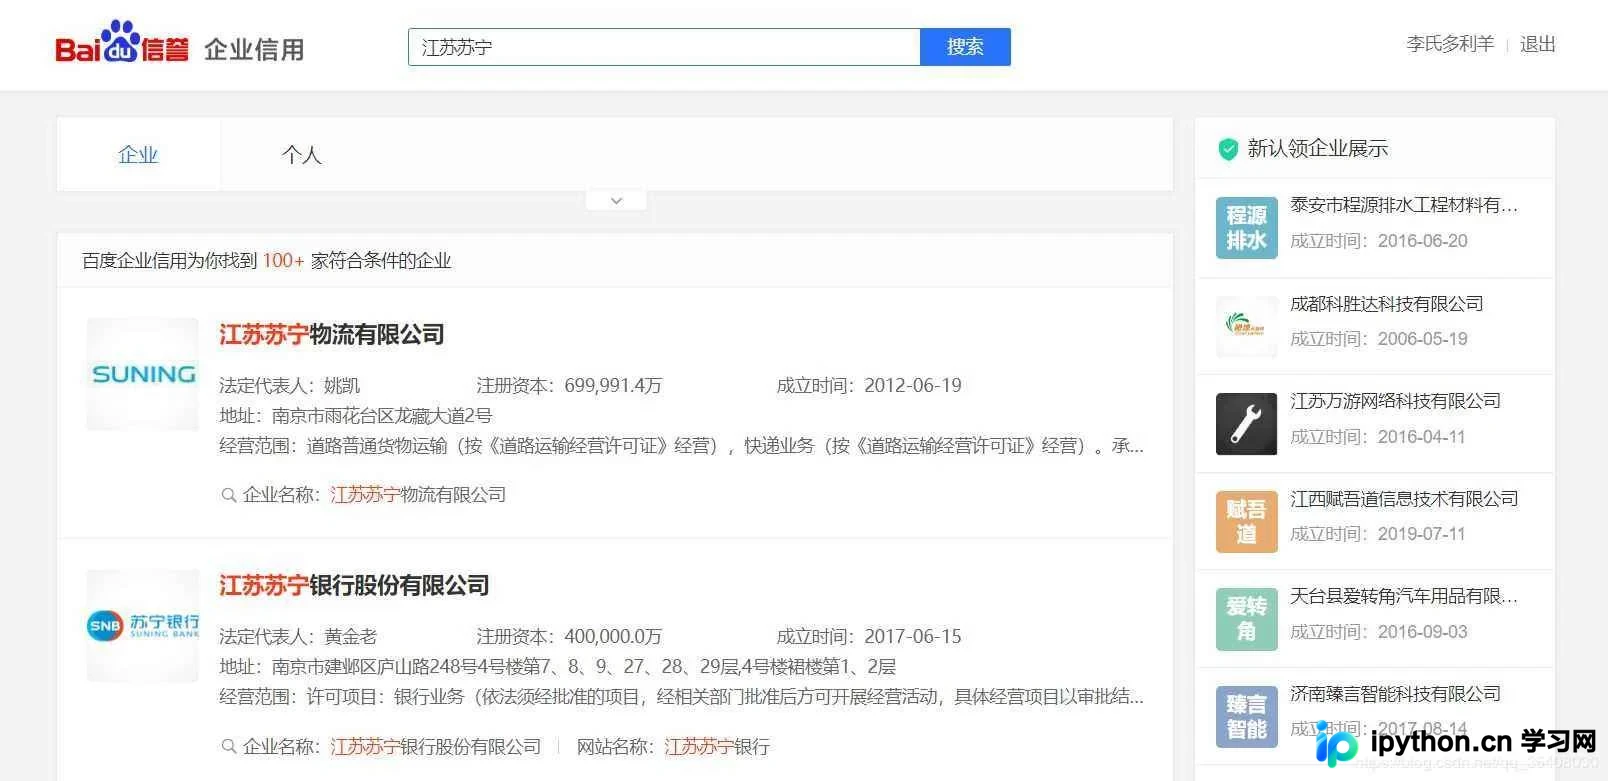
本文介绍如何使用Python爬虫从百度企业信用网站获取企业基本信息。通过分析页面JavaScript动态生成的数据,利用正则表达式提取resultList字段并转换为JSON对象,从而获取企业名称、法人、注册资本等详细信息。文章提供完整源码及调用示例,适用于学习参考,请勿用于恶意爬取。
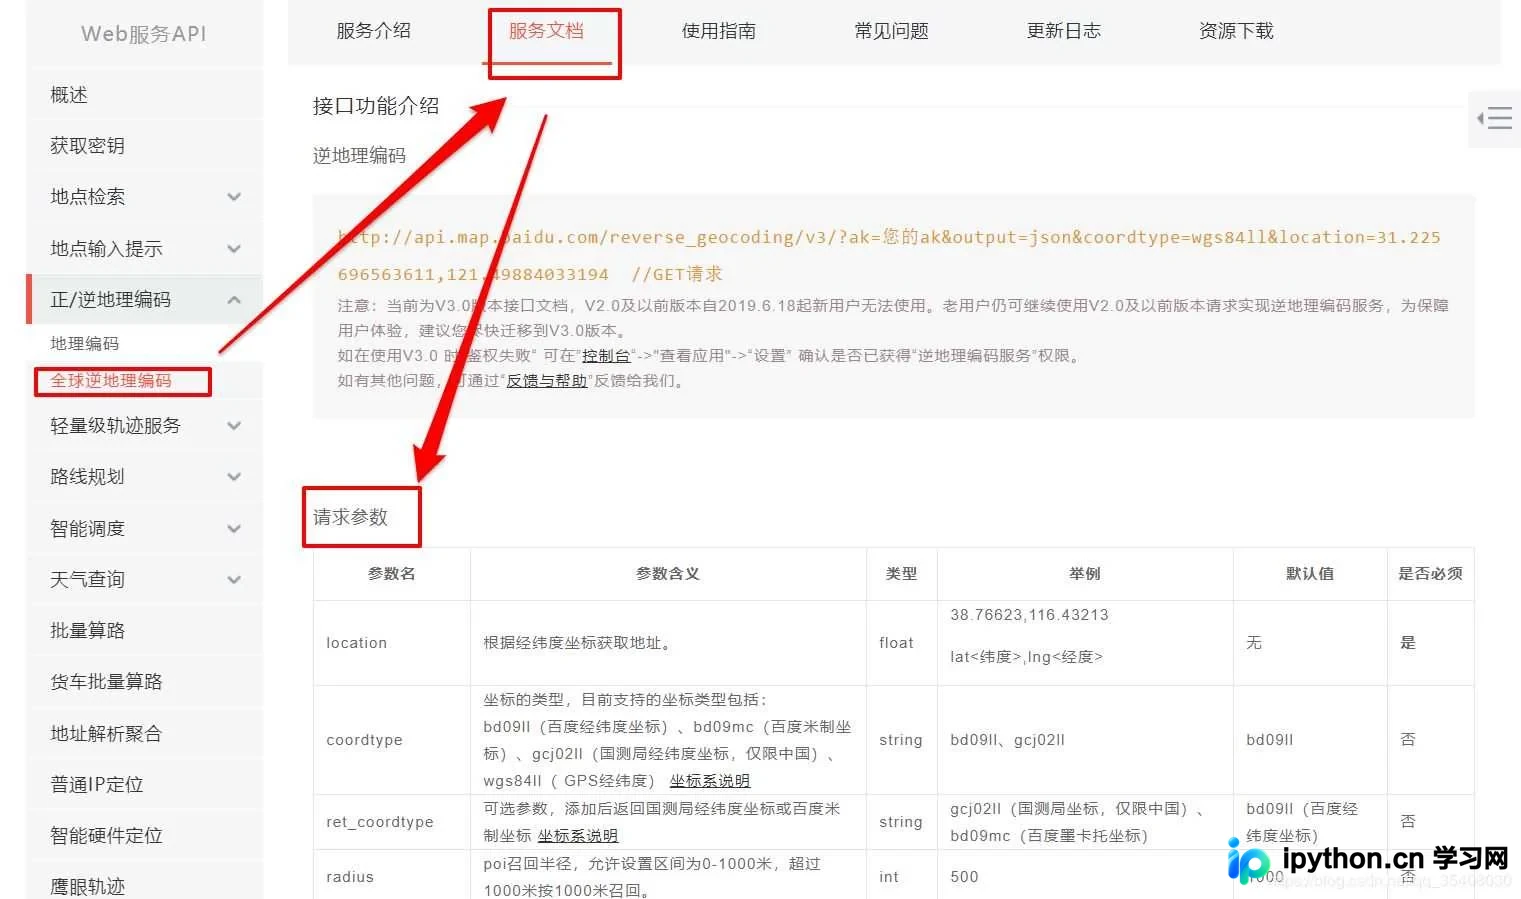
本文详细介绍如何利用Python调用百度地图正/逆地理编码API。通过提供完整源码与具体示例,演示如何将地名转换为经纬度,或将坐标反查为详细地理位置。文章还探讨了正编码精度不足时的优化策略,结合企业信用数据提升定位准确度,适用于需要地理信息处理的开发场景。
本文利用Python对热播网剧《隐秘的角落》进行弹幕数据爬取与分析。通过解析爱奇艺.z格式压缩文件,获取近20万条弹幕,统计高频发言用户、分集互动热度及高赞内容,揭示观众对剧情冲突的关注点与角色讨论热度,为剧集数据分析提供技术参考。