Python爬虫中urllib模块处理URL编码的方法
本文详解Python爬虫中urllib模块处理URL编码的方法。针对包含非ASCII字符(如中文)的URL,直接请求会引发UnicodeEncodeError。通过urllib.parse.quote函数对特殊字符进行ASCII编码并拼接,可生成有效URL,确保爬虫程序正常发起请求并获取页面数据。
2026-10-13
9

本文详解Python爬虫中urllib模块处理URL编码的方法。针对包含非ASCII字符(如中文)的URL,直接请求会引发UnicodeEncodeError。通过urllib.parse.quote函数对特殊字符进行ASCII编码并拼接,可生成有效URL,确保爬虫程序正常发起请求并获取页面数据。
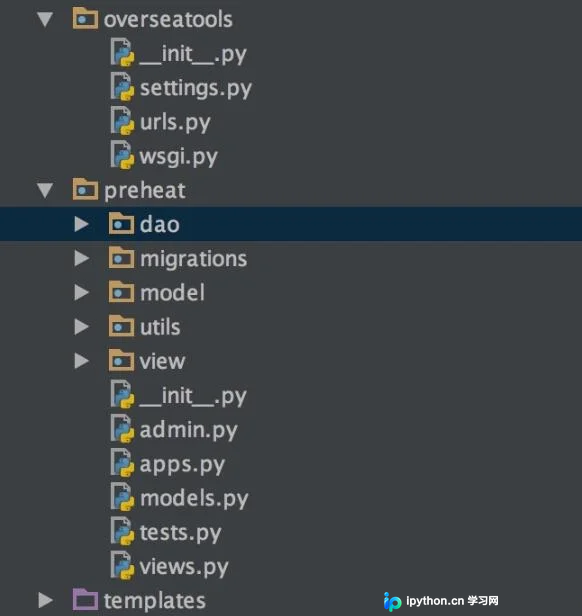
本文介绍在大型Django项目中,将自动生成的models.py和views.py拆分为独立文件夹的方法。通过新建model和view目录,并在__init__.py及urls.py中正确配置导入路径,实现代码模块化,提升项目的可维护性与扩展性。
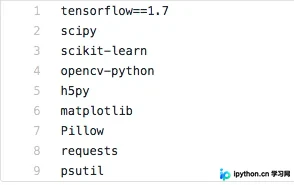
本文详细解析基于TensorFlow的Facenet人脸识别库的完整测试流程。内容涵盖源码下载、依赖安装、LFW数据集的获取与160x160图像预处理,以及使用CASIA-WebFace预训练模型在LFW数据集上的精度验证。文中还记录了运行过程中遇到的模块导入错误、模型版本兼容性问题及线程报错,并提供了相应的解决方案,帮助开发者快速上手Facenet并进行本地部署测试。
本文深入解析Python列表的高级操作技巧。涵盖使用extend高效合并列表、利用sort进行就地排序及自定义键值排序、通过bisect模块维护有序列表,以及掌握切片语法实现逆序与步长提取。同时详解enumerate、sorted、zip和reversed等内置函数的实际应用场景,帮助开发者提升数据处理效率。
本文深入解析Python中局部变量与全局变量的定义、作用域差异及交互机制。通过代码示例说明如何在函数内访问和修改全局变量,重点讲解global关键字的使用场景,并区分不可变类型(如整数)与可变类型(如列表)在函数内修改时的行为差异,帮助开发者避免UnboundLocalError等常见错误。
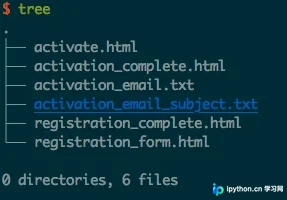
本文详细介绍如何在Django项目中利用django-registration模块实现用户注册邮箱验证功能。内容涵盖模块安装、settings.py配置、URL路由设置以及必要模板文件的创建,帮助用户快速搭建安全的用户激活机制。
本文介绍如何使用 Python 调用高德地图 Web 服务 API,实现经纬度与地址的批量相互转换。通过解析 CSV 文件数据,结合坐标转换与逆地理编码接口,解决异步返回问题,提供完整的代码示例及 Key 使用注意事项,帮助开发者高效完成地理数据批量处理任务。
本文介绍如何使用Python的subprocess模块在父进程中实时获取子进程的标准输出。通过示例演示了因缓冲区导致输出延迟的问题,并给出通过手动刷新缓冲区(flush)实现逐行实时读取的完整代码方案。
本文深入解析Python中zip和enumerate两个常用内置函数的用法。通过代码示例展示zip如何组合多个可迭代对象,以及enumerate如何同时获取索引与值。此外,文章包含多个实战练习,涵盖坐标字符串生成、字典构建、矩阵转置及列表元素修改,帮助开发者掌握高级数据处理技巧。
本文详细解析梅尔倒谱系数(MFCC)的提取原理与流程,涵盖预加重、分帧加窗、FFT变换、Mel滤波器组及DCT逆变换等关键步骤。通过对比MATLAB与Python两种主流编程语言的实现代码,展示MFCC在语音识别与声纹分析中的具体应用,帮助开发者快速掌握特征参数提取的核心技术。
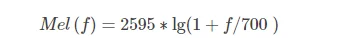
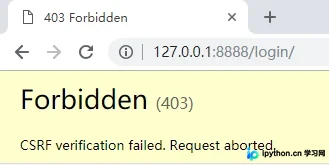
本文详细解析Django框架中Cookie的基础用法,涵盖如何创建响应对象、使用set_cookie设置普通Cookie以及利用set_signed_cookie添加盐值以增强安全性。教程包含完整的登录与主页视图代码示例,强调在POST请求中必须包含csrf_token以防止403错误,并演示如何通过request.COOKIES和get_signed_cookie进行Cookie读取与状态验证,帮助开发者快速掌握Django中的会话保持机制。
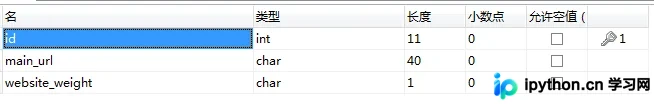
本文详细解析如何使用Python3批量查询网站百度权重。通过openpyxl读取Excel中的网址列表,利用Requests伪造请求获取seo.chinaz.com页面,并用BeautifulSoup提取权重数据。最终将结果写入MySQL数据库及Excel文件,提供完整的代码逻辑与配置说明。