基于OpenCV与KNN的定制化OCR实现:针对固定场景的高精度识别方案
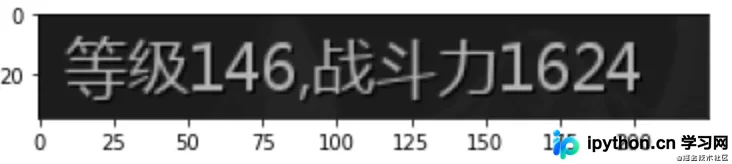
本文介绍一种针对固定窗口字符的定制化OCR方案。通过OpenCV进行灰度化、二值化及纵向膨胀处理,结合轮廓查找与外接矩形过滤,实现字符精准分割。利用KNeighborsClassifier构建向量分类模型,无需复杂深度学习即可在特定场景下实现极高识别率。
2026-10-15
8

本文介绍一种针对固定窗口字符的定制化OCR方案。通过OpenCV进行灰度化、二值化及纵向膨胀处理,结合轮廓查找与外接矩形过滤,实现字符精准分割。利用KNeighborsClassifier构建向量分类模型,无需复杂深度学习即可在特定场景下实现极高识别率。
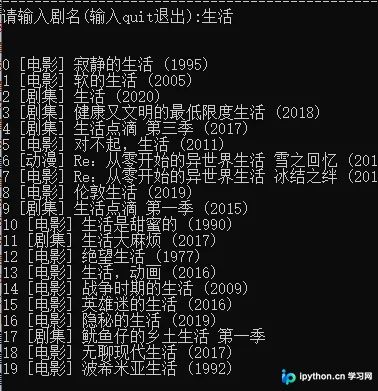
本文介绍使用Python编写的影视网站资源抓取工具,通过requests和re模块解析网页结构,结合多线程与并发处理提升效率。代码包含自定义请求头、Cookie管理及正则提取逻辑,支持批量获取指定影视内容的下载链接,适合对Python爬虫感兴趣的用户参考学习。
本文详细解析Python中的条件控制语句,重点区分break、continue和return在循环与函数中的不同行为。通过具体代码示例,展示如何正确使用break终止循环、continue跳过当前迭代以及return在函数中强制返回,帮助初学者掌握代码执行流程的控制技巧。
本文深入解析Python Tkinter图形界面开发,涵盖标签与按钮的自定义样式配置、顶层窗口协议处理及图标报错解决,并详细演示标准模态对话框(如询问、警告、错误提示)及多栏复合对话框的构建与回调逻辑,帮助开发者掌握GUI交互设计的核心技巧。
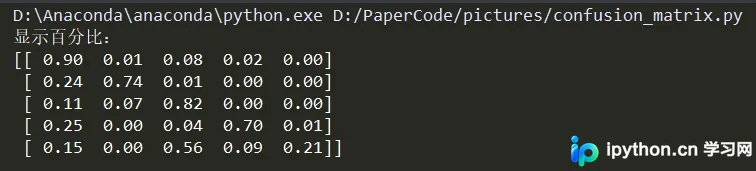
本文介绍如何使用Matplotlib绘制机器学习多分类模型的混淆矩阵,涵盖显示百分比和具体数值两种场景。通过示例代码展示如何配置参数以生成清晰的可视化图表,适用于论文撰写及模型评估分析。
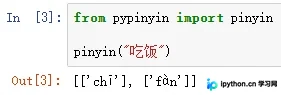
本文详细介绍Python第三方库pypinyin的安装与核心用法。涵盖智能匹配拼音、多音字与繁体字支持,详解Style类中的14种拼音风格(如声调、注音、俄语对照等)。通过示例演示如何处理非汉字字符,并利用load_phrases_dict方法自定义词典以修正特定词汇的拼音标注,实现精准的中文转拼音功能。
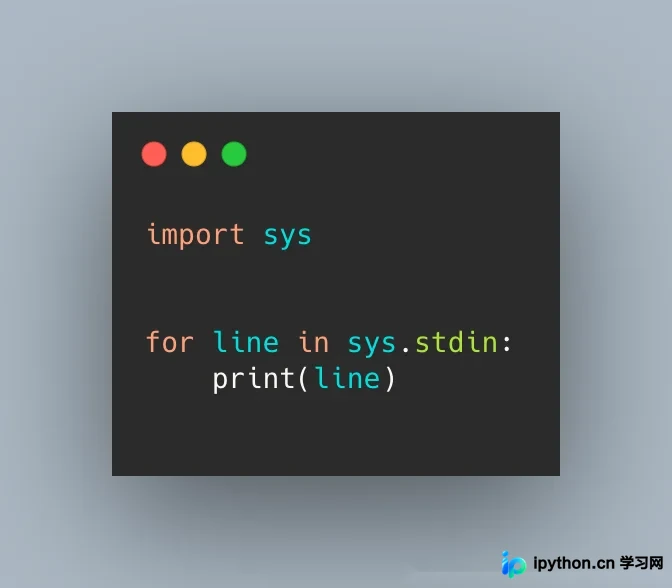
本文详细介绍Python脚本在服务器部署或共享使用时接收外部参数的四种方法。通过sys模块进行流式文本处理,利用argparse模块实现带默认值、帮助文档的标准化参数解析,使用argv列表直接通过下标获取参数,以及结合argv与argparse进行高级封装。文章包含MySQL binlog分析与自动化部署的具体代码示例,帮助开发者根据场景选择最佳方案,提升脚本的兼容性与生产环境可用性。
本文通过具体代码实例,详细讲解Python列表中数据的增加与删除操作。介绍如何使用append函数在末尾追加元素,利用del关键字根据索引删除指定数据,以及extend和insert方法的用法。同时演示了列表的创建、访问及元素修改,帮助读者掌握列表基础操作。
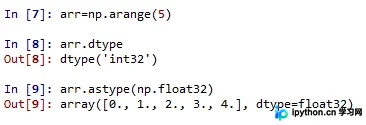
本文详细解析TensorFlow中的核心数据类型dtype,涵盖有符号/无符号整型、浮点数、字符串及布尔型等常用类型。重点介绍tf.as_dtype()函数的用法,以及如何通过dtype属性查看和astype方法进行数据类型转换,帮助开发者在模型构建中准确管理数据格式。
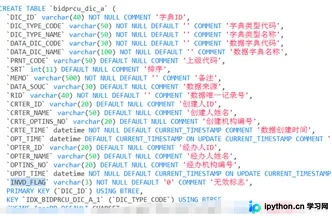
本文介绍使用Python批量生成数据库Insert语句的两种常用方法。第一种通过字符串直接拼接构建SQL,第二种利用列表存储字段值并在生成后替换括号符号。文章提供了完整的代码示例及注意事项,帮助开发者高效处理大量数据插入场景。
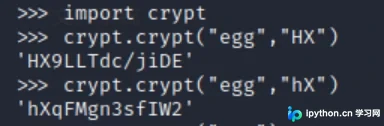
本文详细介绍如何使用Python脚本结合crypt模块对Linux系统进行密码破解测试。通过解析/etc/shadow文件中的加密格式,提取盐值(salt)与哈希算法ID,利用字典文件进行暴力匹配。文章涵盖Python字符串split()方法的深入应用及代码实现细节,旨在帮助安全研究人员理解口令验证机制。
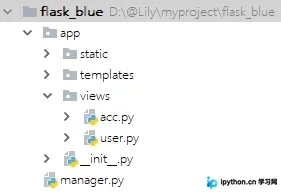
本文详细解析了Flask官方推荐的目录结构,包括蓝图(Blueprint)的注册与应用工厂模式。接着介绍了如何集成Flask-SQLAlchemy进行数据库操作,利用Flask-Script实现命令行启动与自定义脚本,并通过Flask-Migrate完成数据库迁移。涵盖从项目搭建到数据库管理的完整流程,适合Flask初学者参考。