Python提取PDF指定内容并生成新文件
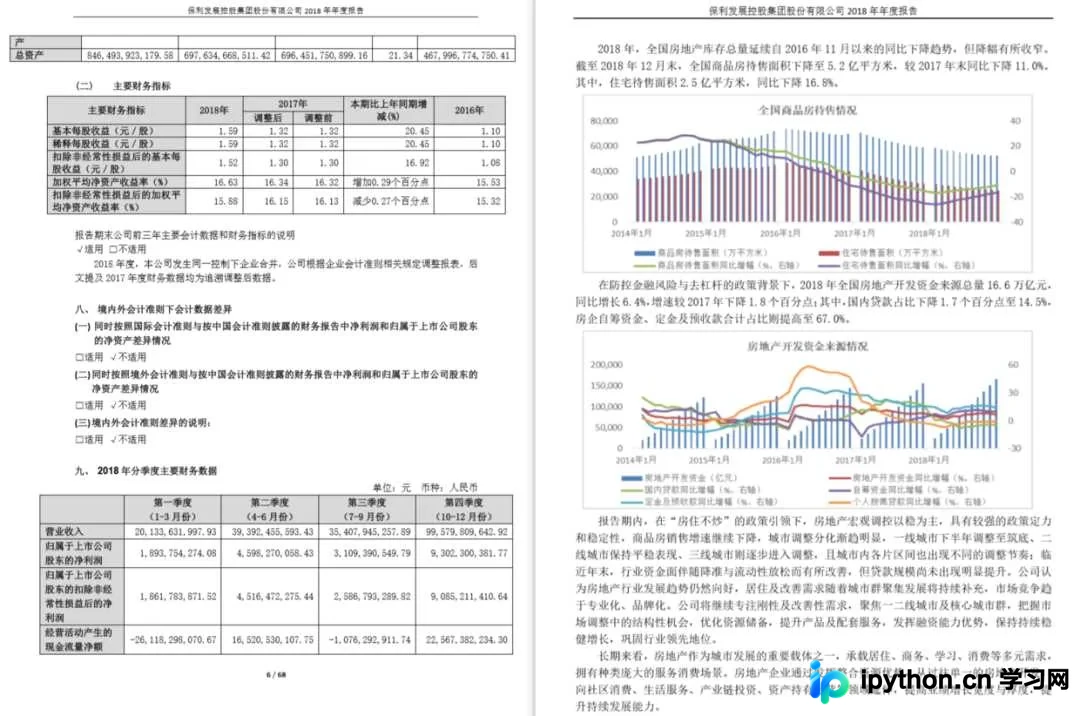
本文通过两个真实需求,演示如何使用Python提取PDF中指定内容并生成新文件。需求一提取包含特定文字“战略”的页面并合并,需求二提取包含图片的页面并单独保存。文章详细梳理了PyPDF2、pdfplumber和fitz模块的逻辑,提供了完整的代码实现,并提示图片识别方法的局限性。
2026-10-14
8

本文通过两个真实需求,演示如何使用Python提取PDF中指定内容并生成新文件。需求一提取包含特定文字“战略”的页面并合并,需求二提取包含图片的页面并单独保存。文章详细梳理了PyPDF2、pdfplumber和fitz模块的逻辑,提供了完整的代码实现,并提示图片识别方法的局限性。
本文详细介绍如何使用Python开发扫码工具,核心利用OpenCV模块调用摄像头获取视频流,并结合Pyzbar模块解析二维码数据。教程涵盖环境配置、图片识别逻辑及实时视频流处理,通过修改函数参数适配视频帧,实现从读取到解析输出的完整流程,帮助开发者快速掌握二维码识别技术。
本文详解如何使用Python编写爬虫程序,通过requests获取爱奇艺热门电影页面源码,并利用BeautifulSoup解析HTML结构,提取电影链接与名称等关键信息。教程涵盖环境配置、代码实现及结果验证,帮助开发者快速掌握基础网页数据抓取技巧。
本文详细介绍Python中OpenCV库(cv2)处理图像的核心功能。涵盖使用cv2.imread读取不同格式图片,通过cv2.imshow和waitKey正确显示窗口,以及利用cv2.imwrite保存图像并设置JPEG质量与PNG压缩级别。此外,还讲解了图像翻转、复制及RGB与灰度图转换的具体实现方法,帮助开发者快速掌握基础图像处理技能。
本文详解Numpy中矩阵翻转(flip)与旋转(rot90)的实现方法。通过axis参数控制上下或左右翻转,保持形状不变。结合skimage.io读取的图片数据,利用rot90实现90度、180度等角度旋转,适用于图像数据增广场景。
本文深入解析Python中transitions库的使用,涵盖状态机的基本概念、逐步创建与直接初始化两种模式。详细讲解如何定义状态节点、添加触发器及处理状态转换,并通过代码示例演示状态的查询、强制移动及触发器的调用方法,帮助开发者高效构建复杂的状态管理逻辑。
本文深入解析Python函数的四种核心参数类型:定位参数、*args可变参数、默认值参数及**kwargs关键字参数,并重点讲解Python3新增的仅限关键字参数定义规则。同时介绍如何利用__defaults__、__kwdefaults__及inspect库进行函数内省,以及使用类型注解提升代码可读性与IDE支持。
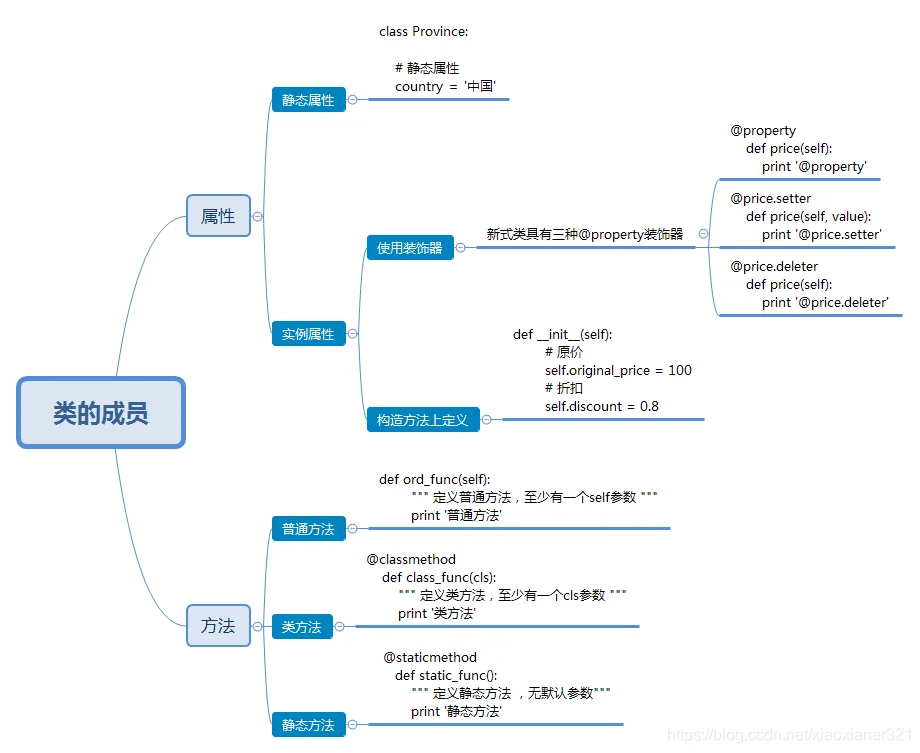
本文详细介绍Python中类的核心概念,涵盖静态与实例属性的区别及创建方式,解析普通、类与静态方法的调用机制,阐述公有与私有成员的访问规则,并系统梳理__init__、__str__等常用特殊成员的使用方法,帮助开发者深入理解面向对象编程。
本文介绍如何使用 Python 的 PyAutoGUI 库快速构建自动化操作脚本。通过模拟鼠标点击和键盘输入,解决网页填表、OA 系统操作及批量数据录入等重复性工作。文章详细讲解了坐标获取、ASCII 与汉字输入(结合 pyperclip)、以及 CSV 数据源集成方法,帮助开发者在无需复杂框架的情况下实现高效的 GUI 自动化。
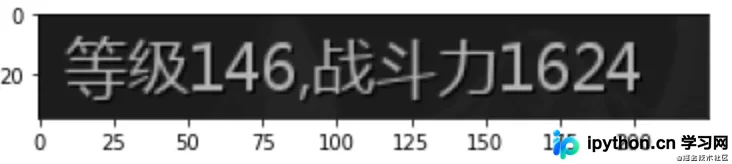
本文介绍一种针对固定窗口字符的定制化OCR方案。通过OpenCV进行灰度化、二值化及纵向膨胀处理,结合轮廓查找与外接矩形过滤,实现字符精准分割。利用KNeighborsClassifier构建向量分类模型,无需复杂深度学习即可在特定场景下实现极高识别率。
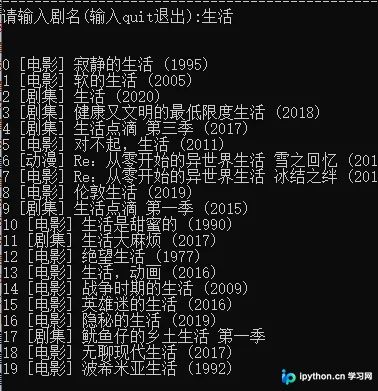
本文介绍使用Python编写的影视网站资源抓取工具,通过requests和re模块解析网页结构,结合多线程与并发处理提升效率。代码包含自定义请求头、Cookie管理及正则提取逻辑,支持批量获取指定影视内容的下载链接,适合对Python爬虫感兴趣的用户参考学习。
本文详细解析Python中的条件控制语句,重点区分break、continue和return在循环与函数中的不同行为。通过具体代码示例,展示如何正确使用break终止循环、continue跳过当前迭代以及return在函数中强制返回,帮助初学者掌握代码执行流程的控制技巧。