Python查看数据类型与格式
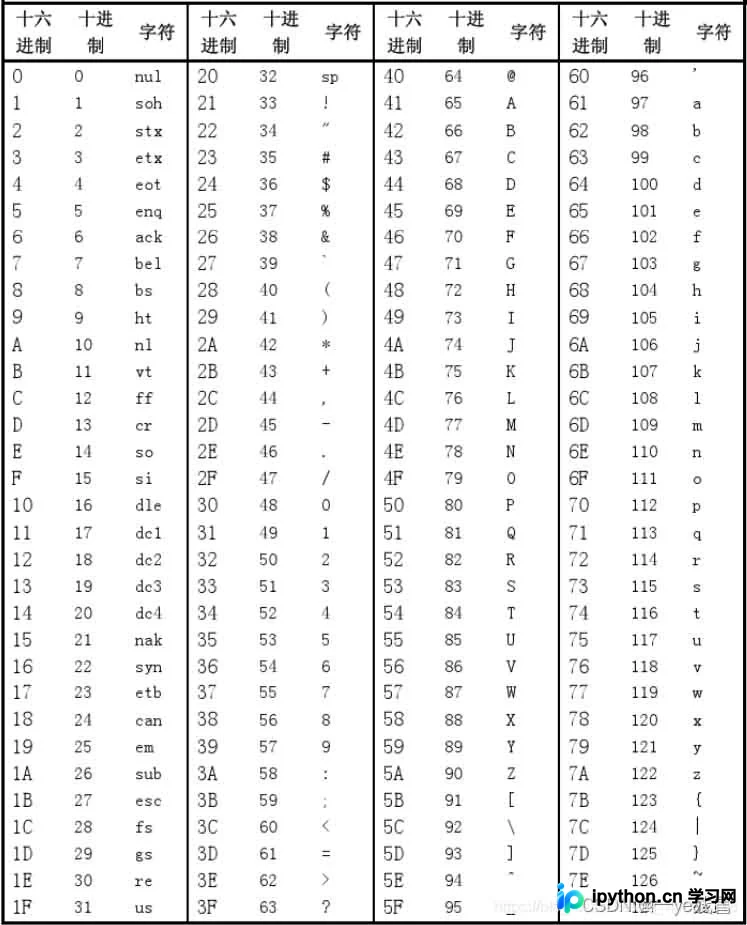
本文介绍Python中查看数据类型的常用方法,涵盖Numpy数组与Pandas数据框的类型判断。重点解析bytes、bytearray与string的区别,演示数字、ASCII及汉字在bytes类型下的创建、转换、切片与迭代操作,帮助开发者准确处理二进制数据。
2026-10-16
9

本文介绍Python中查看数据类型的常用方法,涵盖Numpy数组与Pandas数据框的类型判断。重点解析bytes、bytearray与string的区别,演示数字、ASCII及汉字在bytes类型下的创建、转换、切片与迭代操作,帮助开发者准确处理二进制数据。
本文深入解析 Django ORM 的事务管理机制与查询优化策略。涵盖 transaction.atomic 的使用、回滚点设置及隔离级别配置;详解 ORM 惰性查询原理,包括 only 与 defer 字段的内存缓存机制,以及 select_related 和 prefetch_related 在正反向跨表查询中的应用,旨在帮助开发者提升数据库交互效率并保障数据一致性。
本文详细解析Python .whl文件的命名规则与结构,说明其作为标准二进制包格式的作用。重点介绍通过pip命令安装whl文件的具体步骤,并针对“file does not exist”和“not a supported wheel”等常见报错提供排查方案,包括检查路径、Python版本匹配及wheel模块安装方法。

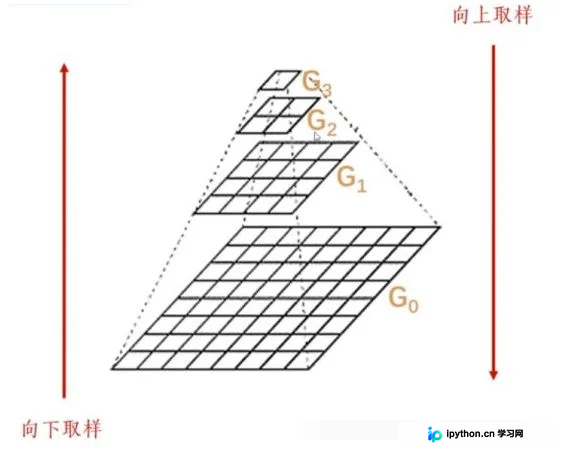
本文深入解析Python OpenCV中的图像金字塔技术,重点讲解向下取样(pyrDown)与向上取样(pyrUp)的原理及实现。通过高斯核卷积与降采样算法,阐述图像分辨率降低导致的信息丢失机制;同时说明放大过程中零填充与卷积重建对清晰度的影响。附带完整代码示例,展示单次及多次取样的具体效果与参数配置。
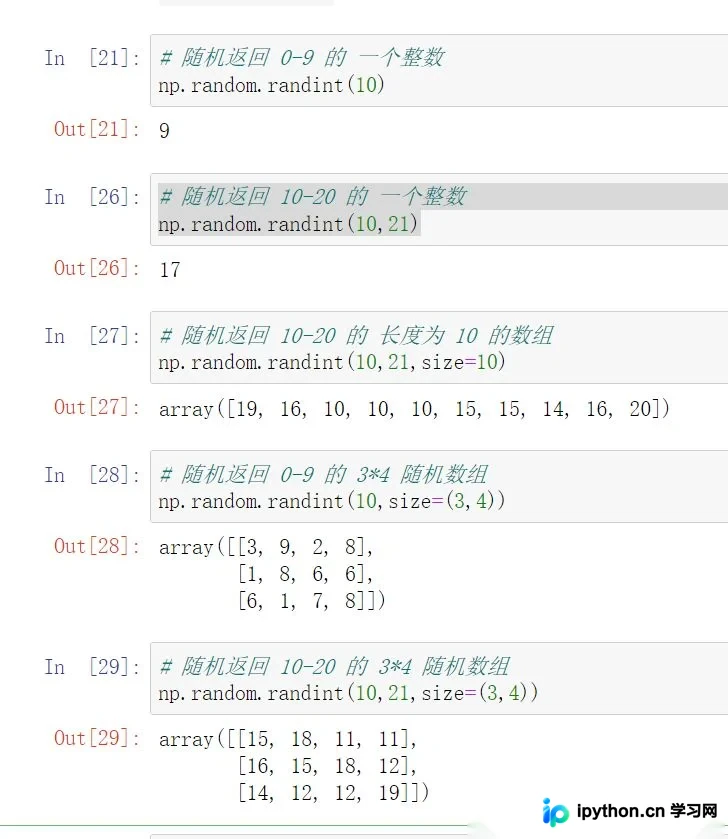
本文详细解析Python中np.random.randint()函数的参数用法,涵盖从生成单个随机整数到多维数组的完整示例。重点讲解low、high、size及dtype参数的具体作用,并深入演示通过列表指定不同元素范围的高级技巧,帮助开发者高效生成符合特定分布的随机数据。
本文详细介绍使用Python的pandas和matplotlib库读取Excel文件并绘制折线图的完整流程。涵盖从环境配置、库安装到代码实现的每一步,重点解析数据读取、绘图参数设置(如颜色、标记、线宽)及图表美化技巧,帮助开发者快速掌握数据可视化基础。
本文详解Matplotlib中plt.xticks()函数的功能与参数。通过官方文档解析,介绍如何获取或设置X轴刻度位置及标签文本。包含旋转标签、隐藏刻度等具体代码示例,帮助开发者灵活控制坐标轴显示样式。
本文详细介绍Python中操作XML文件的两种主要方式:xml.etree.ElementTree和xml.dom.minidom。通过具体代码示例,演示如何解析XML文件、提取元素与属性、修改节点内容以及增删节点,帮助开发者掌握Python处理XML数据的核心技能。
本文深入解析Python中__init__方法的两种常见形式:无参初始化与有参初始化。通过对比代码示例,阐述前者允许实例化后动态赋值,适用于结构预留场景;后者要求实例化时传入参数,适用于数据预置场景。文章提供了Student类的具体实现代码,帮助开发者根据实际需求选择合适的初始化策略。
本文详解在Windows系统中如何使用PyCharm运行.sh脚本。首先介绍本地环境配置,包括安装Git并设置Terminal路径为sh.exe,实现本地脚本执行。其次讲解如何连接远程Linux服务器,通过Start SSH session打开服务器终端,解决模块缺失及环境激活问题,实现高效的远程开发与调试。
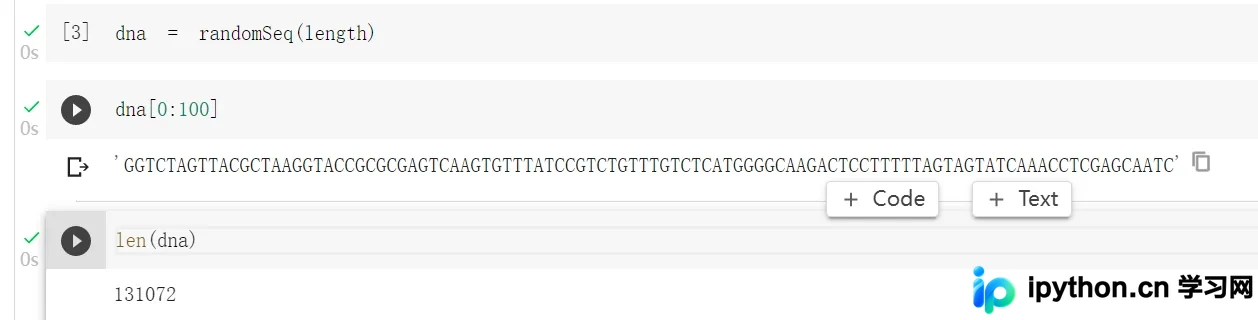
本文介绍使用Python将DNA碱基序列转换为One-Hot编码矩阵,并存储为TensorFlow专用的TFRecord格式文件的全过程。内容涵盖随机序列生成、自定义编码函数实现、字节流转换、Example构建以及数据读取与解析方法,适用于生物信息学深度学习模型训练前的数据预处理环节。
本文详细介绍如何利用Python实现计算机文件的自动化整理。内容涵盖使用os、shutil及pathlib模块进行文件自动分类与快速查找,通过filecmp模块清理重复文件,以及结合PIL和exifread模块批量转换图片格式并按拍摄日期分类。提供完整代码示例与操作步骤,帮助提升文件管理效率。